导读:Databend 原生 Data Lineage 自 v1.2.935 起可用,在数据库内部采集数据流动关系,支持表级和列级追踪,并提供 Databend Cloud 血缘图和 SQL 查询两种分析方式。采集到的对象和字段依赖关系可用于变更影响分析、数据问题定位、数据资产治理和敏感数据传播追踪。
数据血缘解决什么问题?
表结构变更可能影响下游视图、数据任务和报表;指标异常需要沿加工链路定位源数据或转换逻辑;敏感字段的传播范围也需要持续追踪。
当数据系统规模较小时,这些问题通常依靠经验、SQL 搜索和人工排查解决。随着表、视图、Stage 和数据管道形成复杂的依赖网络,仅有数据对象清单还不够,还需要识别数据在对象之间的流动关系。
数据血缘描述数据从产生、加工到被消费的路径,可按两个方向进行分析:
- • 上游(Upstream):描述当前对象的数据来源。例如,客户销售汇总表的上游可能包括订单明细表和客户维度表。
- • 下游(Downstream):描述当前对象的数据去向。例如,订单明细表的下游可能包括聚合表、视图和数据任务。
在修改表结构、调整字段类型、删除列或重构数据模型之前,查询下游血缘可识别潜在影响范围,减少人工确认成本,并降低变更上线后报表或任务失败的风险。
当报表数字异常时,可沿列级血缘逐层检查源数据、转换逻辑和下游使用方式,缩小排查范围。相比在 SQL 和任务日志中逐项搜索,血缘为问题定位提供了明确的依赖路径。
Databend 记录哪些关系和对象?
表级与列级血缘
在血缘模型中,表、视图、Stage 和外部 Catalog 对象构成节点,数据写入与视图定义关系构成节点之间的边。表级血缘描述对象之间的依赖,列级血缘进一步描述源列与目标列之间的生成关系。
列级血缘并不局限于直接复制列。对于聚合、计算表达式、别名以及多层查询,Databend 从查询计划中解析参与计算的源列。当一个目标列由多个源列计算生成时,各源列均构成其上游,依赖关系也可跨越中间表或视图继续追踪。本文的示例血缘链路展示了这一过程。
Data Movement 与 View Lineage
Databend 采集以下两类血缘:
- • Data Movement:数据实际从一个对象写入另一个对象,例如
CREATE TABLE ... AS SELECT、INSERT ... SELECT、多表INSERT、REPLACE、MERGE和COPY。 - • View Lineage:视图定义与其源对象之间的依赖。启用血缘后,创建视图时会记录血缘关系;启用功能之前已存在的视图可使用
REFRESH LINEAGE回填或校准关系。
Stream、Stage 与外部 Catalog
- • Stream:通过 Stream 读取数据时,血缘关系指向 Stream 对应的底层表。
- • Stage:参与对象级血缘,记录数据从 Stage 加载到表或从表卸载到 Stage 的过程。
- • 外部 Catalog:外部对象可作为血缘端点,表示 Databend 对象与外部数据之间的关系;血缘遍历以外部 Catalog 边界为止。
用客户分层实例理解数据血缘
私有化部署配置
Data Lineage 是 Databend 企业版功能。私有化部署需要企业版许可证。启用该功能时,在每个 Query 节点的
databend-query.toml 中加入以下配置:
[lineage]

>
示例血缘链路
以下客户分层场景用于演示完整链路:
fact_orders 保存订单明细,
agg_customer_sales 按客户汇总累计消费额、订单数和最近下单时间,
customer_segments 根据累计消费额生成客户等级。
CREATE OR REPLACE DATABASE lineage_demo;


CREATE OR REPLACE TABLE lineage_demo.fact_orders (

    order_id BIGINT,

    customer_id BIGINT,

    amount DECIMAL(12, 2),

    order_time TIMESTAMP

);


CREATE OR REPLACE TABLE lineage_demo.agg_customer_sales AS

SELECT

    customer_id,

    sum(amount) AS total_amount,

    count(*) AS order_count,

    max(order_time) AS last_order_time

FROM lineage_demo.fact_orders

GROUP BY customer_id;


CREATE OR REPLACE TABLE lineage_demo.customer_segments AS

SELECT

    customer_id,

    total_amount,

    order_count,

    if(total_amount >= 1000, 'high_value', 'standard') AS segment,

    now() AS updated_at

FROM lineage_demo.agg_customer_sales;
血缘通过异步流程持久化。执行上述语句后,相关关系通常在数秒内可查询。
通过 SQL 追溯来源与检查变更影响
表级上游血缘查询
GET_LINEAGE 接收对象名称、对象类型、方向和可选的遍历跳数。对象类型支持
TABLE、
VIEW、
STAGE 和
COLUMN,方向支持
UPSTREAM 和
DOWNSTREAM;遍历跳数取值范围为 1–5,省略时默认为 5。
SELECT

    distance,

    source_object_database,

    source_object_name,

    target_object_database,

    target_object_name,

    process

FROM GET_LINEAGE(

    'lineage_demo.customer_segments',

    'TABLE',

    'UPSTREAM',

    2

)

ORDER BY distance;
UPSTREAM 表示向数据来源方向追溯,
DOWNSTREAM 表示向数据消费方查找。
distance = 1 是直接关系,
distance = 2 是经过一个中间对象的第二跳关系。
process 是包含查询与执行上下文的 JSON 字符串,其中的字段可能因血缘关系类型和执行上下文而为空。
列级下游血缘查询
查询列时,将完整列名作为起点,并把对象类型设为
COLUMN:
SELECT

    distance,

    source_object_name,

    source_column_name,

    target_object_name,

    target_column_name

FROM GET_LINEAGE(

    'lineage_demo.fact_orders.amount',

    'COLUMN',

    'DOWNSTREAM',

    5

)

ORDER BY distance, target_object_name, target_column_name;
该查询用于评估修改
amount 字段时可能受到影响的派生列。
数据库内部如何采集和保存血缘
基于真实查询计划解析依赖
血缘采集的准确性来自真实的查询计划。对于聚合、计算表达式、多表关联和多层查询等复杂 SQL,Databend 能够依据实际查询语义解析列级依赖。同时,血缘关系会保留相关的查询与执行上下文,便于追溯关系来源、核验转换逻辑并定位数据问题。
异步持久化血缘事件
查询成功后,产生的血缘事件会异步写入内置历史表。在正常运行状态下,新关系通常在数秒内可查询和展示,无需等待按小时或按天运行的离线扫描任务。
用对象身份维持重命名后的关系
对于
default Catalog 中的 Databend 原生表,Data Movement 使用对象 ID 和列 ID 标识血缘端点,而不是只保存对象名称。查询血缘时,再根据当前元数据解析最新名称。因此,对表或列执行重命名(Rename)后,已有血缘关系仍然能够指向同一对象,无需根据名称变化重新匹配或重建整条链路。稳定的对象身份可减少长期维护血缘图时的误连接,并在数据模型演进过程中保持关系的一致性。
把已有视图接入血缘图
启用 Data Lineage 后,创建视图时会记录血缘关系。对于启用前已经存在的视图,建议先通过试运行(Dry Run)预览变更,再执行刷新:
REFRESH LINEAGE FOR ALL VIEWS DRY RUN;

REFRESH LINEAGE FOR ALL VIEWS;
REFRESH LINEAGE 会校准
default Catalog 中所有视图的血缘,需要全局
SUPER 权限。试运行只报告将要新增、更新或删除的关系,不写入数据。
在 Databend Cloud 中检查依赖与查询上下文
在 Databend Cloud 中,打开 Database Explorer,选择一个表或视图并进入 Lineage 页签,即可查看血缘图。该功能默认不开启,需要时可提交工单联系 Databend 开启。
节点代表表或视图,节点之间的连线表示数据的上下游关系;展开节点后可查看列之间的依赖。点击表节点之间的连线,还可查看产生该血缘关系时记录的查询和执行上下文。
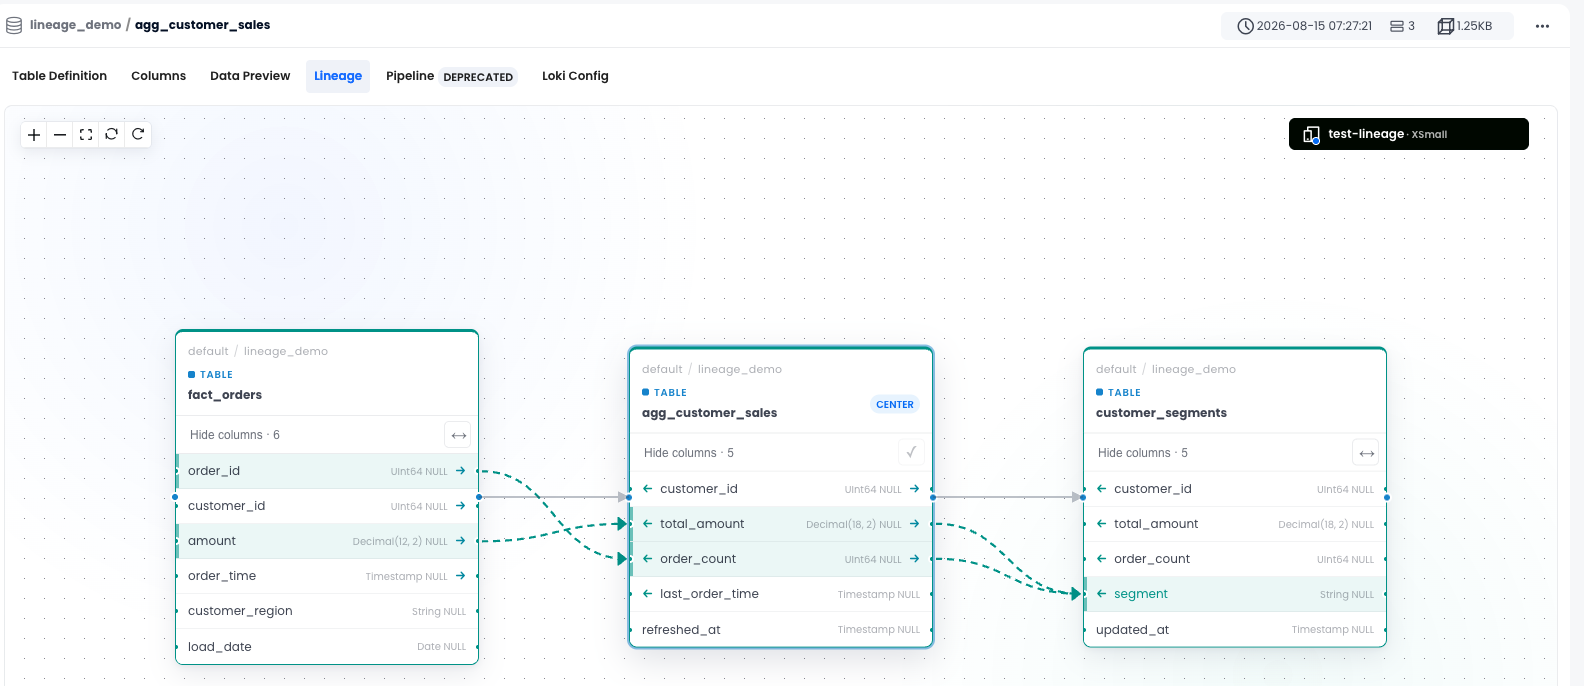
列级血缘可用于分析敏感字段经过转换后流向的目标列。结合权限控制与
Masking Policy,可评估数据暴露范围,为安全审计和合规治理提供依据。
在包含大量表和视图的平台中,名称相似并不代表含义相同。血缘关系反映数据的实际流向,可用于识别关键数据集、重复加工链路,以及缺少下游依赖的对象。
让数据依赖成为排查线索
Databend 原生 Data Lineage 基于真实的查询计划采集血缘关系,并将表级依赖、列级映射和执行上下文纳入统一的血缘查询结果,用于变更影响分析、数据问题定位和数据治理。
Data Lineage 自 Databend v1.2.935 起可用。进一步阅读: Databend Data Lineage 产品文档。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042558/viewspace-3182788/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 同样 PASS,路径为何不同|用 Jev 逐 Span 评估 Agent Trace
- Jev 爆火之后,我们把它集成进了数据湖仓
- 只看 PASS 会骗你,6 条 Agent Trace 里的 Coding Agent 评测真相
- AI 时代的数据工程挑战:从复杂链路走向统一数据底座
- Databend 增量物化视图:基于 Change Tracking 的增量刷新与一致性读取
- Cluster Key 最佳实践:列怎么选、顺序怎么排与粒度设计
- 从传统分区到微分区,Snowflake 与 Databend 如何减少数据扫描
- 从 Kafka 到 Databend Cloud:万亿级 Agent Trace 接入链路的工程实践
- Databend Cloud 助力头部 AI 企业构建全链路 Trace 管道
- Databend 产品更新:从 Spatial Index Join 到 Eval 数据管道
