用户行为数据埋点指标是数据仓库中不可或缺的重要数据源之一,同时也是企业最宝贵的资产之一。通常情况下,用户行为数据分析包含两大数据源:用户行为分析日志和上游关系型数据库(如 MySQL)。基于这些数据,企业可以进行用户增长分析、用户行为研究,甚至通过用户行为分析精准排查用户问题。
用户行为数据分析的挑战
-
高流量和大容量:用户行为数据的产生量非常大,对存储和分析能力要求高;
-
兼顾多种分析需求:既需支持 BI 报表的静态展示,也需满足灵活的 Adhoc 查询;
-
多样化数据格式:用户行为数据通常包含结构化数据与半结构化数据(如 JSON);
-
实时性要求:需要对用户行为快速响应,实现及时反馈。
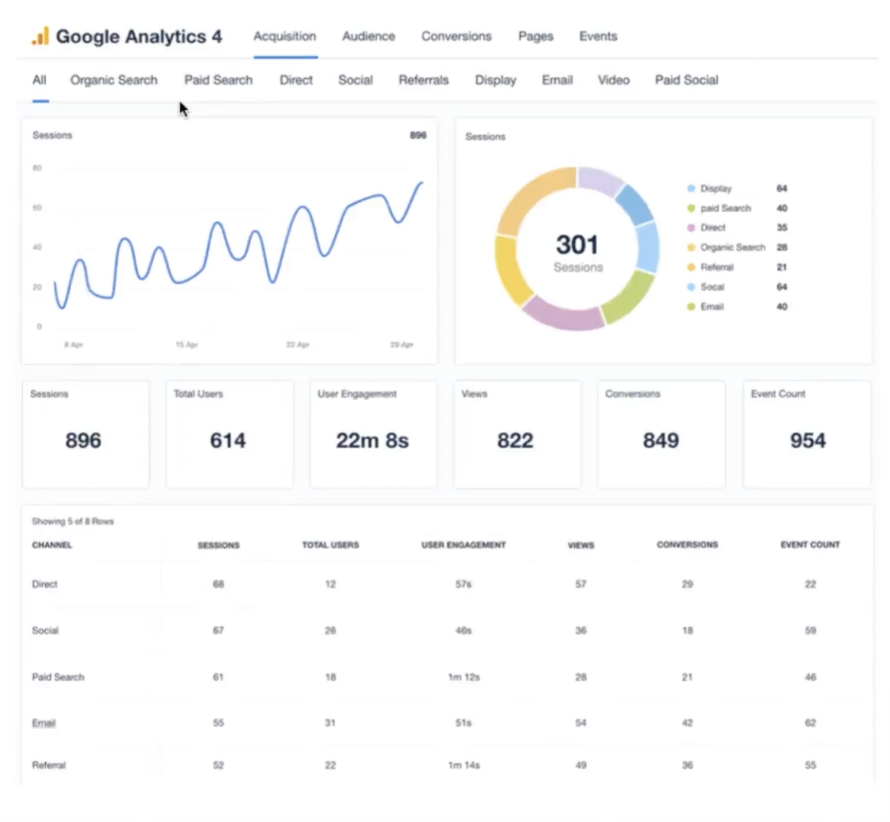
然而,通用埋点系统虽然简单易用,但在实际使用中存在以下不足:
-
数据 明细 的缺失。通用埋点系统往往不会提供用户具体的访问明细日志,只能在 UI 中查询预设的报表;
-
自定义查询能力不足。通用埋点系统的查询模式并非标准 SQL 查询接口,当数据科学家希望构建复杂的 adhoc 查询时,由于缺少 SQL 能力,难以支持复杂的自定义查询;
-
成本快速上升。通用埋点系统一般采用阶梯计费模式,往往到了一个阶梯时,费用会翻倍。随着企业流量的持续增长,如果要查询更大范围的用户行为数据时,成本会迅速增加。
自建用户行为分析体系的复杂性

为了应对通用埋点系统的局限性,不少企业在业务增长到一定阶段后,往往都会选择自建一套用户行为埋点数据分析体系。通常情况下,传统自建架构多基于 Hadoop 大数据生态,典型实现流程如下:
-
在客户端(APP、网站)中埋入 SDK,采集用户行为日志 activity logs;
-
使用 Activity gateway 埋点指标网关,收集客户端发来的日志,并将日志转到 Kafka 消息总线;
-
利用 Kafka 将日志 logs 落到 Hive 或 Spark 等计算引擎;
-
通过 ETL 工具将数据导入数据仓库,生成用户行为分析报表。

虽然这一架构在功能上能够满足需求,但其复杂性和维护成本极高:
-
Kafka 需要依赖 Zookeeper ,还需要配备 SSD 硬盘保障性能。
-
从 Kafka 到 Data Warehouse 需要 kafka-connect ;
-
Spark 要运行在 YARN 上,ETL 需要 Airflow 管理;
-
当 Hive 存储达到上限,可能还需要将 MySQL 换成 TiDB 等分布式数据库。
这种架构不仅需要大量的技术团队投入,还极大增加了运维负担。而在企业不断追求降本增效的背景下,传统 Hadoop 架构已不再适合需要简单、高效的业务场景。
新选择:基于 Databend Cloud 的轻量化用户行为分析
随着技术的演进,企业在设计用户行为数据埋点架构时有了新的选择。Databend Cloud 凭借简洁的架构和灵活性,提供了一种高效且低成本的用户行为分析解决方案。
Databend Cloud 的架构特性
-
100% 面向对象存储,完全存储计算分离,显著降低存储成本;
-
Rust 编写的 Query 引擎性能高,价格低廉。在计算资源闲置时自动休眠,不产生额外费用;
-
支持 100% ANSI SQL ,支持半结构化数据分析(JSON 和自定义 UDF)。当用户有一些比较复杂的 JSON,可以用内置的 JSON 分析能力或自定义的 UDF,分析半结构化数据;
-
内置 Task 调度驱动 ETL,完全无状态,自动弹性伸缩。
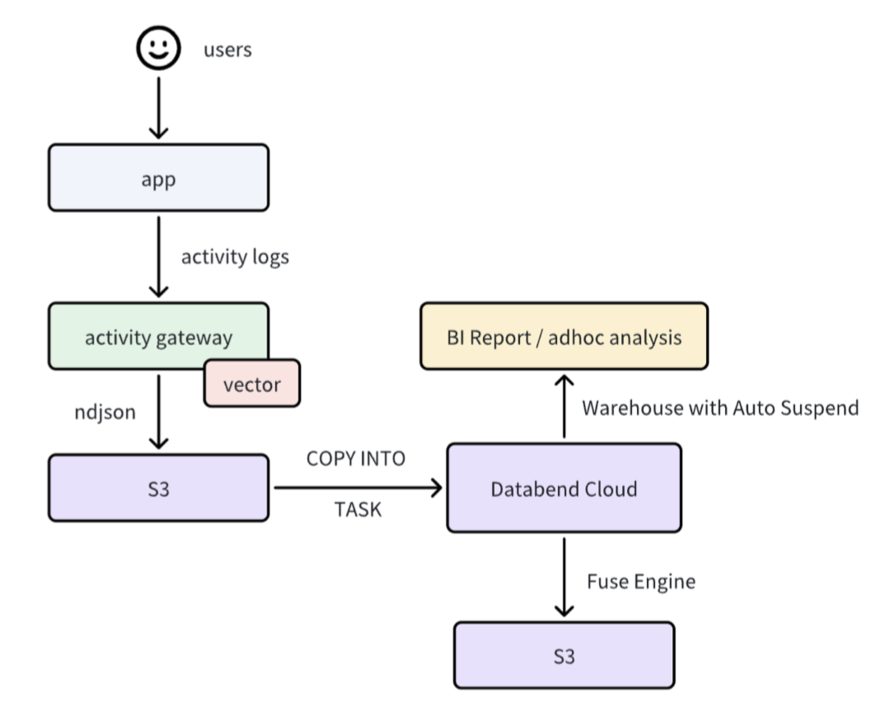
典型架构实现
-
日志采集与存储:不再需要 Kafka,用户直接将埋点日志通过 vector 以 ndjson 格式落到 S3。
-
数据摄入与处理:在 Databend Cloud 中创建一个 copy task 任务,自动把日志拉出来,落到 S3。很多时候,S3 在 Databend Cloud 中可以当做一个 stage,落到 stage 里面的东西就可以被 Databend Cloud 自动吸进来,然后在 Databend Cloud 中进行处理,再从 S3 转出去。
-
查询与报表分析:通过自动休眠的 Warehouse 运行 BI 报表/即席查询,休眠时不产生任何费用。
通过上述方式,Databend Cloud 能够以最简化的方式实现企业对高效用户行为分析的需求。
案例:Databend Cloud 在用户行为分析的应用实践
某互联网应用公司有一个典型的用户行为分析场景,在做架构选型时选择了 Databend Cloud 进行用户行为数据分析体系的搭建。在使用 Databend Cloud 后,该用户放弃了 Kafka,直接用 Databend Cloud 建了一个 stage ,把用户行为日志落在 S3 中,再用 task 导进 Databend Cloud 中。最终,该公司仅用一个下午便完成了 POC,从复杂的 Hadoop 架构切换到 Databend Cloud,极大简化了运维和操作成本。
用户所需要的准备工作非常简单。首先,准备两个 Warehouse,一个用于 Task 摄入数据,一个用于 BI 报表查询。一般来说,摄入数据的时候可以用一个规格小点的 Warehouse,查询的 Warehouse 规格高一点,因为查询不会一直查,可以节省更多成本。

然后点击 connect 获得一个连接串,这个连接串可以放在 BI 报表用于查询。Databend 提供了各种语言的 Driver。

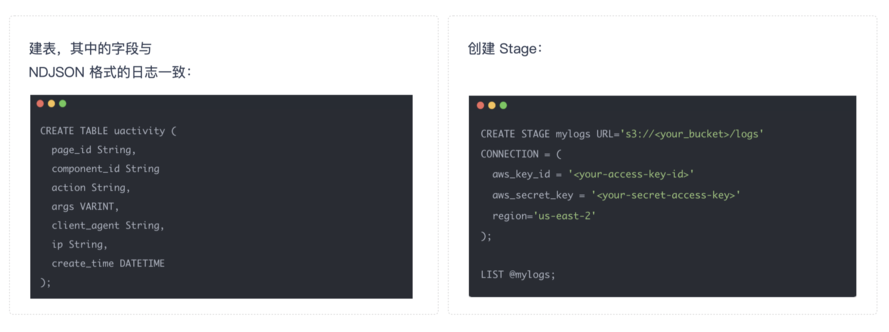
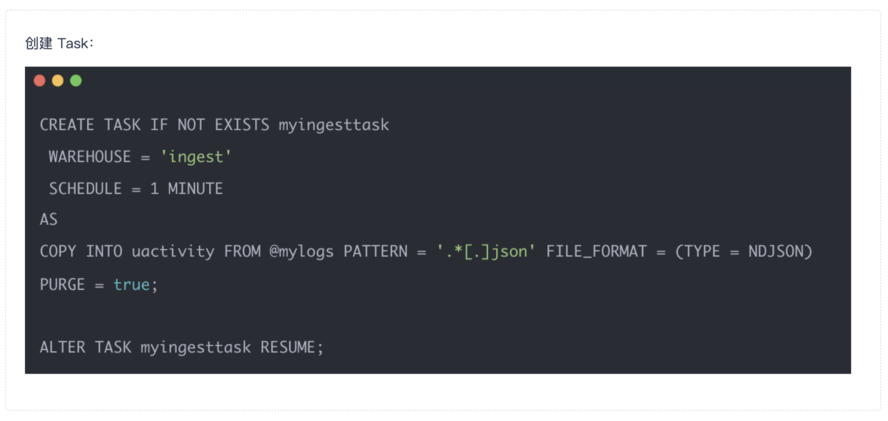
接下来的准备工作只有三步,一是建表,其中的字段与 NDJSON 格式的日志一致。然后创建一个 stage,将存放用户行为日志的 S3 目录录进来,然后再创建一个 task ,每一分钟或者十秒钟执行一次。它会自动把 stage 里的文件导进来,然后自动把它清理掉。准备工作完成后,就可以源源不断地把用户行为日志录进来。
架构对比与收益
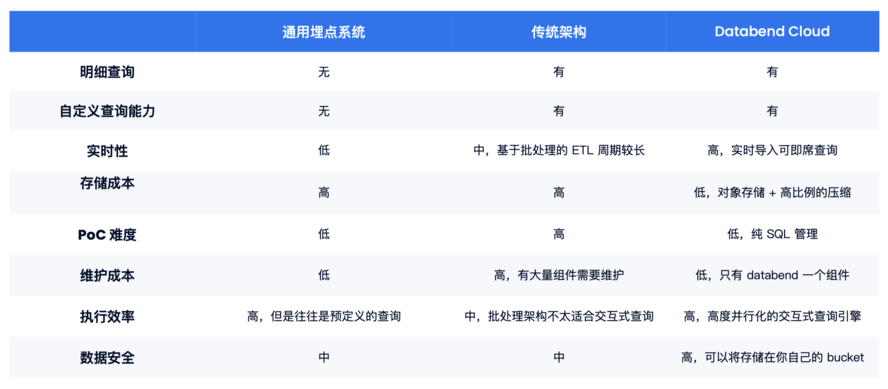
通过对比通用埋点系统、传统 Hadoop 架构和 Databend Cloud,Databend Cloud 的优势显而易见:
-
架构简洁性:摆脱了复杂的大数据生态,无需 Kafka、Airflow 等组件。
-
成本优化:利用对象存储和弹性计算实现低成本的存储与分析。
-
灵活性与性能:支持高性能 SQL 查询,满足多样化的业务场景。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042558/viewspace-3051320/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 同样 PASS,路径为何不同|用 Jev 逐 Span 评估 Agent Trace
- Jev 爆火之后,我们把它集成进了数据湖仓
- Databend 原生数据血缘:追溯指标来源,检查变更影响
- 只看 PASS 会骗你,6 条 Agent Trace 里的 Coding Agent 评测真相
- AI 时代的数据工程挑战:从复杂链路走向统一数据底座
- Databend 增量物化视图:基于 Change Tracking 的增量刷新与一致性读取
- Cluster Key 最佳实践:列怎么选、顺序怎么排与粒度设计
- 从传统分区到微分区,Snowflake 与 Databend 如何减少数据扫描
- 从 Kafka 到 Databend Cloud:万亿级 Agent Trace 接入链路的工程实践
- Databend Cloud 助力头部 AI 企业构建全链路 Trace 管道
