拒绝SQL“玄学”卡顿!openGauss 自适应缓存计划硬核拆解
同一条 SQL,昨天执行如丝般顺滑,今天换个参数突然就拉胯,甚至引发系统卡顿?
这并非数据库在“抽风”,而是背后的执行计划可能选错了。
在IFClub近期直播中,我们邀请到 陆登老师带来分享《openGauss 源码解读:自适应缓存计划的生成逻辑》,把 PBE协议、cplan、gplan、aplan盘了个明明白白。
今天这篇回顾,带你看看怎么解决“计划跑偏”这个玄学问题。
🌟 PBE 协议的意义——消除重复劳动的“缓存魔法”
分享开篇,陆老师先科普了数据库交互的底层逻辑。平时我们直接发一条select语句,后端一次性完成解析、生成计划、执行。这叫 简单协议,主打一个“阅后即焚”,前后端毫无瓜葛。
但对于高频执行的预编译 SQL(Prepare)来说,每次都走一遍词法解析、语义分析、优化重写、生成计划,算力开销极大。这就引出了 扩展协议(PBE)。
PBE 将操作拆解为:
Parse(解析):只生成CachedPlanSource对象(保存查询树)。
Bind(绑定):将实际参数塞入占位符。
Execute(执行):调用执行器直接运行。
💡 无论是 PBE 还是存储过程,其核心灵魂就是复用。通过把执行计划缓存进会话级的哈希表,下次带参数进来直接取用,省去了前面的“重复造轮子”,极大提升了性能。
🌟 cplan 与 gplan 的取舍艺术
进入核心环节,陆老师对比了 openGauss 中两种最常见的执行计划:
cplan(Custom Plan,定制计划):每次 Execute 都根据传入的 真实参数生成最优计划。优点是优化器看得到真实数据,选得准;缺点是每次都要走一遍解析优化,开销大。
gplan(Generic Plan,通用计划):用占位符生成一个通用计划,之后无限复用。优点是省去了规划开销;缺点是优化器看不到实际参数,只能盲猜平均值。一旦遇到数据倾斜,选出来的计划可能极其糟糕。
🔥 灵魂拷问:系统怎么选?openGauss 的策略非常严谨:前 5 次硬编码强制生成 cplan!系统会累计这 5 次的代价,到了第 6 次,如果 gplan 的预估代价小于前 5 次 cplan 平均代价的 1.1 倍,才会切到 gplan。
此外,还有一些“强制排除规则”(比如带 limit 的 delete、全局缓存场景等)只能选 cplan。
🌟 aplan 怎么化解“数据倾斜”危机?
既然 gplan 看不到真实参数,一旦遇到极端的数据倾斜(比如参数100占了 90% 的数据,参数1只有 1 条),gplan 极有可能选出糟糕的执行计划。
openGauss 的对策是:既然一个 gplan 兜不住,那就 缓存多个 gplan!这就是 aplan的诞生背景。
🔍 状态机拆解与实战:aplan 本质上是一个状态机流转:
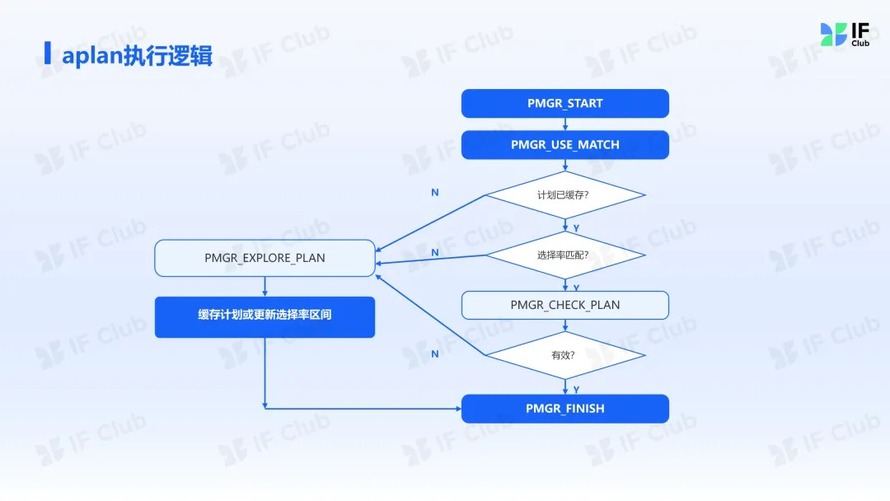
陆老师带我们一同实操体验:
前 5 次s(100):生成 cplan。
第 6 次s(100):开始尝试 gplan,并计算选择率(52.6%),将计划和选择率区间打包缓存。
执行s(200):计算选择率为 47.3%。此时系统发现没在这个区间内,于是重新评估。结果发现底层执行路径依然是全表扫描,于是直接 更新原有缓存计划的匹配区间(将下限拉低)。
执行s(1):选择率极小,没匹配上。系统重新生成一条 索引扫描的新计划,作为第二条 aplan 缓存。
再执行s(0):选择率刚好匹配刚刚生成的索引扫描区间,直接完美复用,不再产生新的规划开销。
通过哈希运算与选择率区间的动态调整,aplan 做到了对不同参数“精准下药”。
🌟 避坑指南与局限性
虽然 aplan 解决了大问题,但陆老师也客观指出了它目前作为“实验性功能”的局限:
模型较简单:只考虑了基表的选择率,没考虑数据分布(比如数据块物理位置是否分散),也没考虑 join 的选择率。如果表连接复杂,依然可能选偏。
使用条件苛刻:必须开启enable_cachedplan_mgr,且与全局缓存冲突;必须加choose_adaptive_gplanhint;且只支持预编译语句(prepare),存储过程里的 SQL 用不上。
💡 结语
从协议层交互,到 cplan/gplan 的自动切换机制,再到 aplan 的状态机流转,陆老师用一场源码级的拆解,让我们看清了 openGauss 在面对复杂场景时的处理方式。aplan 的引入,可以说是对通用计划缺陷的一次反馈。
感谢陆老师的倾情分享!如果想获取完整 PPT 和视频回放,或者想进群深入交流,欢迎关注 IFClub 视频号与公众号,我们群里见!👇
💬 互动话题:你在日常写 SQL 时,遇到过最离谱的“计划翻车”导致卡顿的场景是什么?欢迎在评论区吐槽!
(注:本文根据IFClub 2026-10-22 陆登老师直播分享整理,完整回放可关注“IF-论坛”视频号观看,PPT可以点击“阅读原文”查看。)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042159/viewspace-3186662/ ,如需转载,请注明出处,否则将追究法律责任。

