一次常规的分区 SPLIT,叠加索引重建和统计信息收集,可能让优化器基于错误基数重新选路。本文还原一个制造业生产案例,并给出可落地的变更检查清单。
在数据库运维里,最危险的事情往往不是一眼就能看出来的,而是“每一步单独看都合理,组合起来却出了问题”。
一次分区 SPLIT 就是典型场景。它看起来只是把一个分区拆成两个分区;但它同时会触发索引维护、游标失效、硬解析和统计信息变化。如果恰好有一项统计信息失真,优化器就可能把原本稳定的 SQL 带到一条完全不同的执行路径上。
本次直播分享的制造业案例中,核心存储过程单次执行从约 0.1 秒变成约 2 秒。单次多出 1.9 秒未必惊人,但它是高频调用:延迟在并发下累积,最终造成生产任务超时并影响产线。
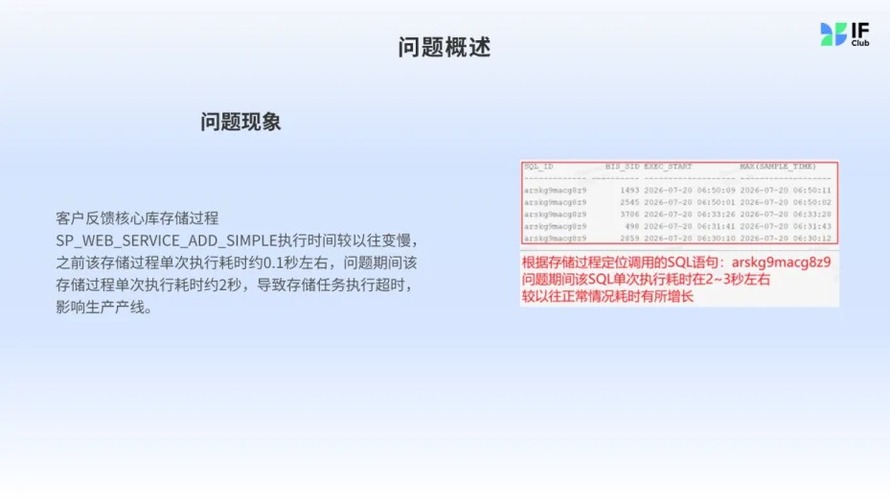
(故障现象:核心存储过程从约0.1秒变为约2秒)
从“存储过程变慢”到“异常 SQL”:先找事实,不急着猜原因
排查没有从“最近做了什么变更”开始,而是先锁定存储过程内部真正变慢的 SQL。通过对象标识关联历史会话和性能视图,再比对问题期间与历史期间的执行计划,可以看到两个关键信号:
优化器对谓词选择性的预估严重偏小;
实际访问的数据量与预估值出现数量级差异,原本稳定的高效计划被替换。
案例 PPT 记录中,问题计划预估仅 1 行,实际访问达到百万级;同时 AWR 历史显示,SQL 在 DDL 前长期使用另一份稳定计划。这里最值得记住的不是某个 Hash 值,而是排查顺序: 先比较预估行数与实际行数,再比较历史计划与当前计划,最后才回溯变更窗口。
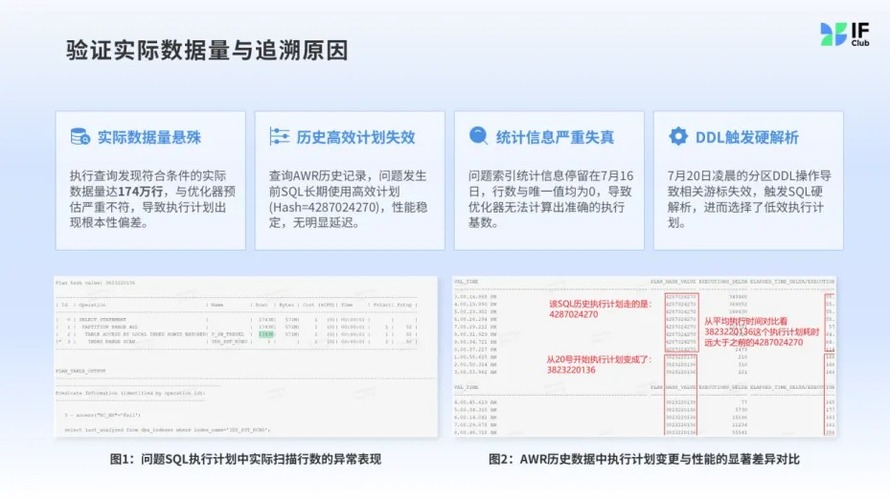
(预估失真、历史高效计划失效、统计信息异常与DDL硬解析的证据链)
真正的触发链:SPLIT 不只是“拆分数据”
SPLIT 是 DDL。它会重建分区元数据、移动数据,并使引用对象的游标失效。下一次执行相关 SQL 时,数据库需要硬解析;如果这时统计信息不可信,优化器就可能在错误的成本模型下重新选路。
索引类型的差异尤其关键:本地分区索引通常可随分区维护;全局索引则需要重点关注维护方式和可用性。生产案例中,风险链条被归纳为:SPLIT 后索引进入失效或待维护状态 → 在不合适的时点收集统计信息 → 重建索引恢复物理可用性 → 汇总统计仍然失真 → 硬解析选择低效计划。
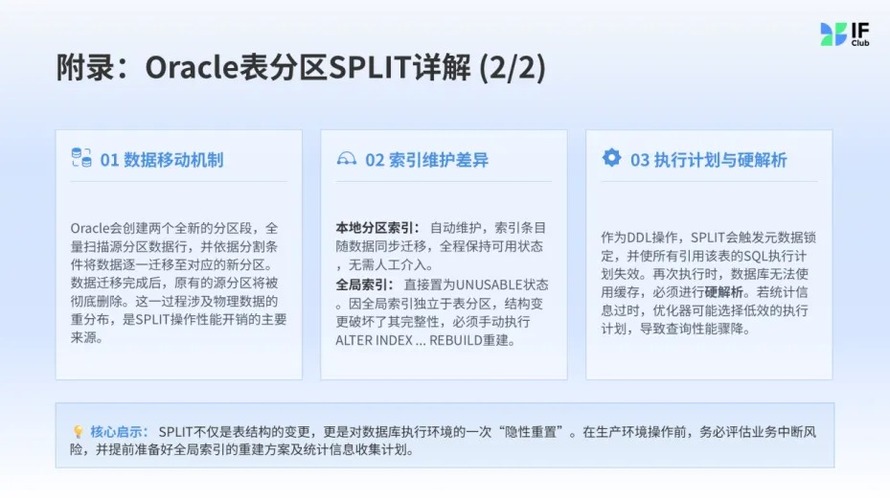
(SPLIT的数据移动、索引维护差异及硬解析风险)
这里有一个很容易混淆的认知: 索引状态为 USABLE,只说明它可以被使用;不说明优化器据以估算成本的统计信息已经正确。
附带的 Oracle 19c 测试脚本验证了这一点的一个具体形态:对本地分区索引执行 SPLIT、收集表统计、再重建该索引分区后,分区级 NUM_ROWS 会更新,但索引的全局汇总 NUM_ROWS 仍可能为 0;单独执行 DBMS_STATS.GATHER_INDEX_STATS 后,汇总统计才恢复到真实行数。
这份测试不能替代对所有索引类型和版本组合的验证,却足以说明一条通用原则: 物理重建、分区级统计、全局汇总统计是三件不同的事,不能互相替代。
为什么上月也做了 SPLIT,却没有出故障?
这种问题最反直觉的地方就在这里。
如果索引一直不可用,CBO 不会选择它,业务反而可能继续走旧路径;而在本月,索引被重建为可用状态,但失真的统计信息没有同步修复。DDL 又让原先缓存的计划失效,SQL 被迫硬解析,低成本的“假象”终于被优化器采纳,故障才真正爆发。
因此,复盘变更不能只问“DDL 是否成功”,还应问四件事:索引状态是否正确?分区级和全局统计是否一致?核心 SQL 是否重新硬解析?新的计划与耗时是否通过回归验证?
先止血,再修根因:两层处置思路
出现生产故障时,首要目标是尽快让业务恢复。案例中的临时做法是将异常索引设为不可见,迫使优化器重新选择路径,使 SQL 回到可接受的执行计划。此类操作必须结合现场验证,不应机械套用。
长期方案则要把“恢复”变成“稳定”:针对核心 SQL 使用 SQL Profile 或 SQL Plan Baseline 固化经过验证的计划;同时补齐相应索引的统计信息,避免下一次统计刷新、对象变更或硬解析再次触发计划跳变。
一张可放进变更单的 SPLIT 检查清单
变更前:确认分区字段、业务低峰窗口、锁表与 I/O 风险;梳理核心 SQL,并保留执行计划和耗时基线。
执行中:明确本地与全局索引的维护策略;对需要维护的全局索引使用合适的在线/离线方案和参数。
变更后:检查索引状态,而不只检查 DDL 是否成功;重建后核对统计信息的 NUM_ROWS、LAST_ANALYZED 与实际数据量是否合理。
统计信息:不要把一次全表统计当作全部完成。对于分区索引,单独确认分区级统计与全局汇总统计;必要时执行索引级统计收集。
业务验证:立即对核心 SQL 做计划和性能回归;将耗时阈值、计划变化和大幅基数偏差纳入监控告警。
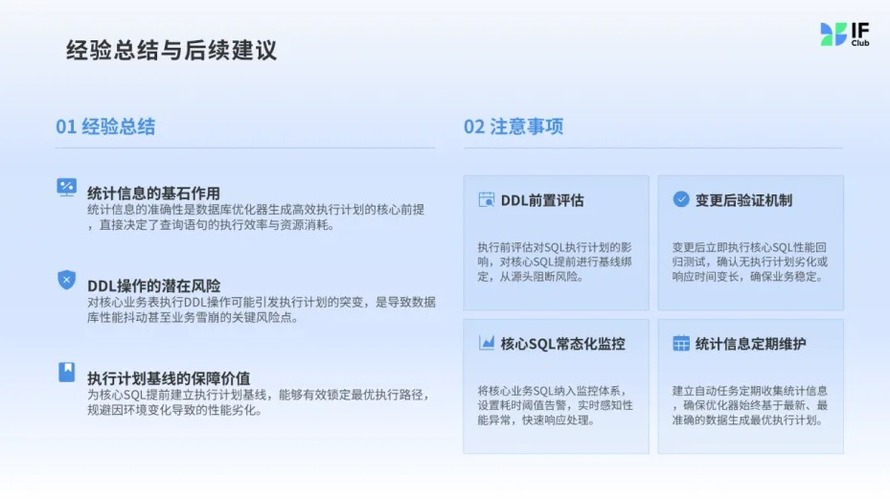
(经验总结:DDL前置评估、变更后验证、核心SQL监控与统计维护)
两个常见误区
“预估 1 行,就一定有问题吗?”
不一定。预估只是模型结果。只有它与实际访问行数差距显著,并且伴随执行计划切换和性能劣化时,才构成有价值的异常信号。
“重建索引后,统计信息肯定正常了吗?”
不一定。重建解决的是物理结构可用性;优化器是否拥有正确的分区级与汇总统计,要通过查询和统计收集结果单独确认。
写在最后
分区变更、索引重建和统计信息收集,都是 DBA 日常操作。但生产风险通常不藏在某一条命令里,而藏在命令之间的依赖关系里。
真正可靠的变更,不是“执行成功”就结束,而是完成索引状态、统计信息、执行计划和业务性能的闭环验证。把这些隐性条件写进检查清单,才能让一次看似普通的 SPLIT,不再变成下一次执行计划跳变的起点。
资料说明
本文依据直播 PPT 与《分区表 UNUSABLE 索引统计信息测试》脚本整理。测试结果用于说明“索引可用性与统计信息正确性并非同义”;生产环境中的索引类型、Oracle 版本、参数与数据分布不同,执行前应在同构环境验证。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042159/viewspace-3184254/ ,如需转载,请注明出处,否则将追究法律责任。

