差点翻车?TiDB 一线运维实战笔记,附全套排障闭环干货整理!
面对业务规模持续扩张,信创落地不断深化,不少团队都会遇到现实困境:集群能跑起来,但很难 “稳得住”——扩缩容操作踩坑引发数据风险、业务突发慢查询无从下手、备份任务跑完却无法真正恢复、分布式故障溯源找不到头绪...
本次我们邀请到 IFClub 星珩联盟智库星系专家李琪老师,结合金融行业 TiDB 一线落地实战经验,带来深度技术直播。 立足信创分布式数据库生产运维现实痛点,传递从 “会用” 到 “会管”的核心运维理念,实现运维能力的层级跃升。
一、认知升维:构建 TiDB 分布式集群全局视野
“会用,解决业务能不能跑;会管,保障业务能不能持续稳定地跑。” 这是整场分享的底层核心。
仅仅掌握建库建表、SQL 编写,只能算作 “会用”;而 “会管”,是把 TiDB 视作一套完整分布式系统来运营,以保障集群高可用、性能可控、风险可预知为目标。
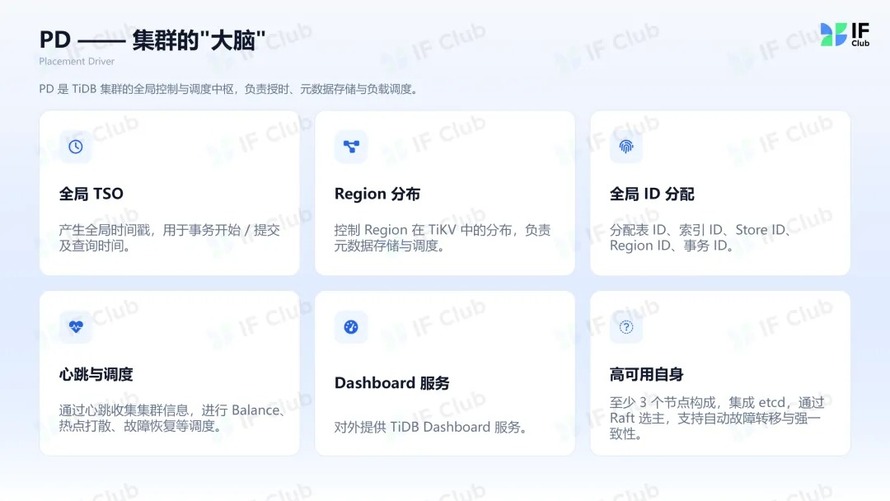
李琪老师对 TiDB 存算分离架构进行体系化拆解:PD 节点间通过 Raft 协议实现高可用选主,PD 负责全局元数据管理和负载调度决策;TiKV 行存引擎依托 MVCC 多版本并发控制机制,赋予集群闪回、在线 DDL 等关键生产能力;无状态的 TiDB-Server 计算层,支撑业务压力下的算力弹性扩缩。
同时着重提示,TiDB 仅兼容 MySQL 通信协议,底层内核架构完全迥异,运维不能简单复刻传统数据库经验,必须建立适配分布式体系的全新认知框架。
二、集群启停与扩缩容:标准化实操与风险规避
本部分李琪老师 依托 TiUP 运维工具做实操演示,梳理集群启停、扩缩容的标准动作与风险边界。
集群启停具备固定时序:启动顺序为 PD→TiKV→TiDB-Server;停止执行反向顺序。日常运维常用list、display、check命令快速校验集群整体状态。特别强调,务必备份 TiUP 拓扑元数据目录,规避运维管理主机单点故障风险。
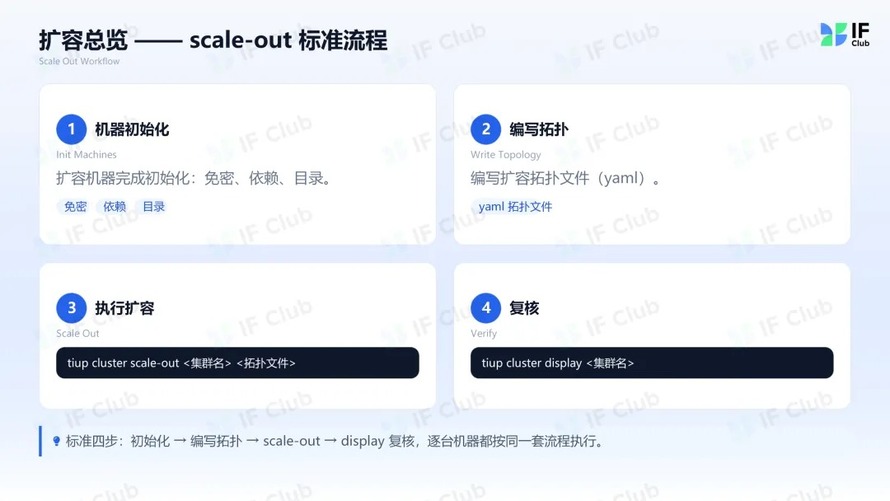
扩缩容是生产高频变更,但不同组件风险等级截然不同。TiDB-Server 无状态,扩缩容风险较低;TiKV 缩容属于高危操作,执行 scale in 之后,必须等待节点状态变更为 Tombstone ,确认全部 Region 迁移完成,才可以清理节点,操作不当会直接造成数据丢失。
PD、TiFlash 同样存在部署约束,PD 集群节点不能低于 3 个,所有线上变更必须严格遵守操作流程。
三、集群健康巡检与监控告警:构筑风险前置防线
优秀的分布式运维,核心在于前置发现隐患,而不是故障发生之后被动救火。 分享定义五大巡检核心维度:组件运行状态、Region 副本健康度、业务性能指标、硬件资源容量、备份有效性校验。
监控观测上,除 CPU、内存、磁盘 IO 等基础服务器指标,TiDB 运维需要重点关注活跃连接数,而非总连接数;持续跟进 GC 执行状态,避免 MVCC 历史版本堆积耗尽磁盘空间。同时明确一个关键理念:备份任务执行成功≠备份可用,必须常态化开展恢复演练,校验备份集真实有效。
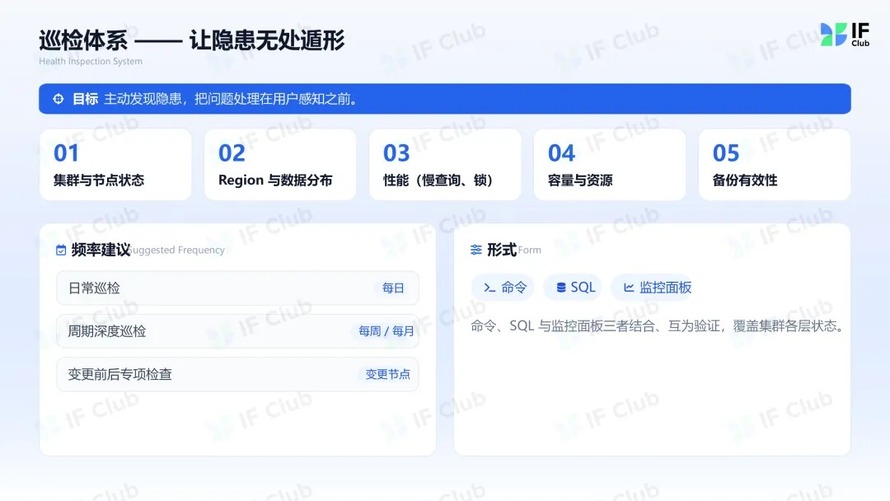
同时,直播中实操演示两大观测体系:TiDB Dashboard 可以完成慢 SQL 查询、读写热点识别、日志检索,搭配 Clinic 采集火焰图用于疑难问题诊断;Grafana 侧重点关注 TiKV 读写线程池、Region 均衡、DDL 执行进度等核心指标,实现风险早识别、早干预。
四、典型故障排查与处理:生产问题标准化处置思路
结合金融行业真实生产场景,李琪老师在直播中梳理了 TiDB 高频故障排查路径,同时补充 BR、TiCDC 工具的生产注意事项。
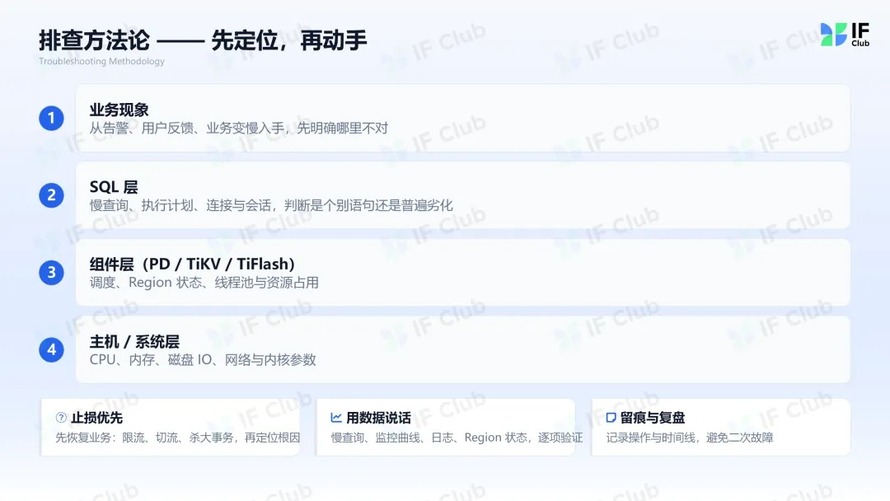
慢查询与读写热点:借助 SQL 指纹筛选高消耗 SQL,区分瓶颈出在计算层 TiDB-Server,还是存储层 TiKV;自增主键极易引发热点问题,依靠 Dashboard 流量视图定位热点分片,通过打散、预切分、SQL 优化化解集群瓶颈。
MDL 元数据锁阻塞:TiDB 在线 DDL 不会阻塞 DML,但 DDL 会被 DDL 发起前未提交的事务所阻塞,可通过 tidb_mdl_view 视图定位阻塞会话,生产环境终止会话前务必充分评估业务影响。
CPU 与内存负载异常:分层定位压力来源,大 Join、超大事务是内存暴涨主要诱因,优先优化 SQL、拆分大事务,配合参数策略守护集群稳定性。
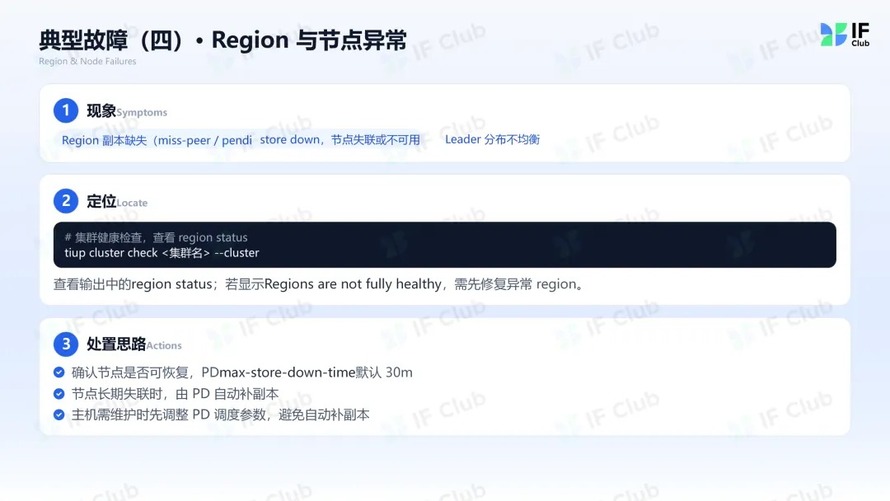
Region 与节点异常:PD 默认在节点宕机 30 分钟(max-store-down-time)后,才将其上的 Region 调度到其他节点以补全副本,在此之前不会触发自动迁移。
工具实践层面:BR 物理备份要求版本对齐,NAS 存储环境统一 UID,控制备份并发,防止备份流量冲击业务;强烈建议表具备主键,否则可能导致同步性能下降或数据不一致风险,持续监控同步链路延迟,保障数据同步链路可靠。
故障处置恪守核心原则:先止损、再定位、后复盘,故障过程留存监控与日志证据,为根因分析提供依据。
五、总结沉淀:打造分布式数据库完整运维闭环
故障处置完成,并不代表运维工作就此结束,真正成熟的 TiDB 运维,重在形成可复用、可落地的完整闭环。
线上集群所有变更操作,必须严格执行双人复核机制,从源头降低人为误操作带来的生产风险。故障解决之后,要做好完整复盘,将处置思路、排障步骤沉淀为故障速查表与标准化应急操作手册。同时把周期性巡检、重复故障处置等机械性工作脚本化、自动化,释放 DBA 精力,减少人工疏漏。
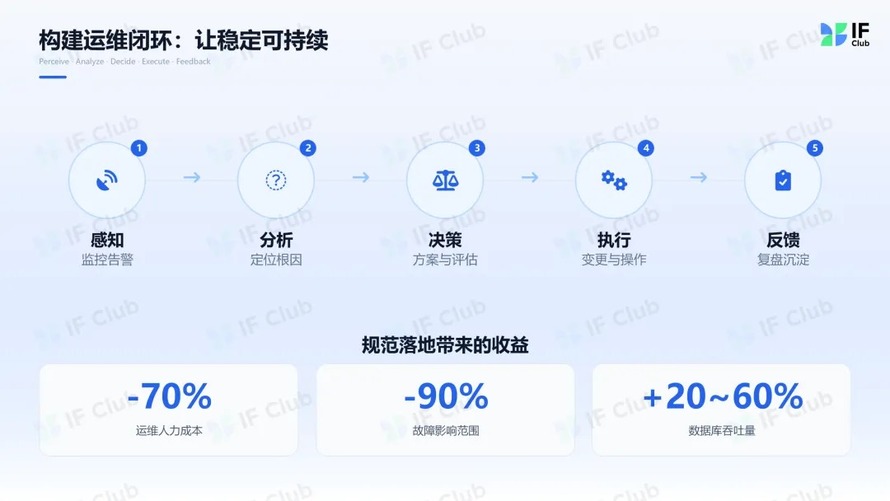
分享也特别强调,分布式数据库的问题根源往往不止于数据库本身,业务、中间件、硬件都可能成为故障诱因。 运维人员需要跳出数据库的局部视角,建立全链路分析思维,把实战经验沉淀为团队内部知识库,规避同类问题反复上演。
最终实现运维模式的升级,从被动的故障救火,转向风险预判、架构优化的主动防御,保障集群长期稳定可靠运行。
** 本文内容整理自IFClub社区2026年9月22日技术直播。*
完整回放可关注“IF-论坛”视频号观看,完整PPT可进入官网获取。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042159/viewspace-3184248/ ,如需转载,请注明出处,否则将追究法律责任。

