通常我们在使用GPU机器时,我们会非常关注GPU的利用率。我们可能会通过性能监控来获取这些指标。
在Nvidia的官方的指导文档中,是这么描述GPU利用率的。
如果GPU的某个SM正在执行计算任务,而其他SM处于空闲状态,我们可以通过以下公式来估算整体的GPU利用率:
GPU 利用率=  ×100%GPU 利用率 =总SM数量活跃的SM数量×100%
根据这个公式,如果我们有一个GPU,它有10个SM,并且只有一个SM在工作,那么GPU的利用率应该是:
GPU 利用率=  ×100%=10%
然而,在实际应用中,我们可能会观察到nvidia-smi工具报告的GPU利用率为100%,即使只有一个SM在活动。这种现象可能会引起一些混淆,因为它似乎与我们的直觉不符。
令人困惑的现象
即使只有一个任务在 GPU 的一小部分上运行,“GPU util”诸如 nvidia-smi 或其他基于 nvml 的工具所报告的指标可能会误导用户,让他们误以为设备已完全被占用,这会带来相当大的困惑。
__global__ void simple_kernel() {
    while (true) {}
}

int main() {
    simple_kernel<<<1, 1>>>();
    cudaDeviceSynchronize();
}
此代码片段将在单个流多处理器 (SM) 上启动指定的内核(线程)。根据常规理解,GPU的“利用率”应该计算为1 / num_sm * 100%。例如:
如果 GPU 上有 10 个 SM,则“GPU 利用率”应为 10%。
如果 GPU 上有 20 个 SM,则“GPU 利用率”应为 5%。
然而,据观察,nvidia-smi 可能会报告"GPU-Util" 100%,如以下示例输出所示:
 $nvidia-smi
|-------------------------------+----------------------+----------------------+
| GPU  Name        Persistence-M| Bus-Id        Disp.A | Volatile Uncorr. ECC |
| Fan  Temp  Perf  Pwr:Usage/Cap|         Memory-Usage | GPU-Util  Compute M. |
|                               |                      |               MIG M. |
|===============================+======================+======================|
|   0  Tesla V100-SXM2...  Off  | 00000000:1A:00.0 Off |                    0 |
| N/A   42C    P0    67W / 300W |   2602MiB / 32510MiB |    100%      Default |
|                               |                      |                  N/A |
+-------------------------------+----------------------+----------------------+
有什么问题?让我们来寻找答案吧。
GPU Util:一个误导性的术语
我们首先来看看nvidia-smi 官方文档是如何描述的。
该nvidia-smi命令行工具基于 NVIDIA 管理库 (NVML),遗憾的是该库不是开源的。为了找到一些说明,我们参考了官方NVML 文档。根据文档,
GPU 利用率:报告 GPU 和内存接口的计算资源的当前利用率。
接下来我们看看代码是如何定义的。
尽管 NVML 库本身不是开源的,但我们发现有可用的开源语言绑定。这意味着我们至少可以访问structure and field definitions,通常在 C/C++ 头文件中提供。这里我们选择该gonvml项目,该项目为 NVML 提供了 Golang 绑定。以下是 NVML 头文件的摘录,其中定义了术语"GPU Util"和“内存利用率”:
// https://github.com/NVIDIA/go-nvml/blob/v0.12.0-1/gen/nvml/nvml.h#L210

/**
 * Utilization information for a device.
 * Each sample period may be between 1 second and 1/6 second, depending on the product being queried.
 */
typedef struct nvmlUtilization_st {
    unsigned int gpu;                //!< Percent of time over the past sample period during which one or more kernels was executing on the GPU
    unsigned int memory;             //!< Percent of time over the past sample period during which global (device) memory was being read or written
} nvmlUtilization_t;
通过上面的评论,我们得到了答案。
根据NVML的定义,“利用率”是指 在过去的样本期间内发生某些活动的时间百分比。具体来说:
-
GPU 利用率
:这表示一个或多个内核在 GPU 上执行的时间百分比。
-
内存利用率
:这表示读取或写入全局(设备)内存的时间百分比。
换句话说,NVML定义的“利用”概念可以不符合我们的共同理解。它仅测量给定采样周期内设备使用的时间部分,而不考虑该时间内使用的流式多处理器 (SM) 的数量。通常,我们将“利用率”视为正在使用的 GPU 处理器的部分。
我不知道为什么 NVIDIA 以这种非常规的方式定义“利用率”。但是,它可能与“USE”(利用率/饱和度/错误)方法中的“利用率”定义有关。
接下来我们来看看“USE”中是如何描述这个定义的。
Brendan Gregg 介绍的“USE”方法论。该方法侧重于三个关键指标:利用率、饱和度和错误。根据“USE”博客,术语定义如下:
利用率:平均时间该资源正忙于维修工作 [2]饱和度:资源具有无法服务的额外工作的程度,通常需要排队错误:错误事件的计数
“USE”方法为“利用”提供了额外的解释:
还有另一个定义其中利用率描述 使用资源的比例,因此 100% 利用率意味着无法接受更多工作,与上面的“忙”定义不同。
总之,在“USE”方法论中,“利用率”指的是 资源正在积极服务或工作的部分时间,而不考虑分配的容量。对于后者,使用术语“饱和度”。虽然“使用”方法为资源使用评估提供了宝贵的见解,但重新定义“利用率”等成熟术语可能会导致混乱。许多人仍然更喜欢代表容量使用或饱和度的“利用率”概念。
如有必要,可以使用替代术语来代替“利用率”"used-frequency",表示使用设备的频率。
那么如何采集这些指标呢?
在大多数情况下,我们主要关心的指标与“饱和度”有关。那么,我们在哪里可以找到这些 GPU 指标呢?
有两种流行的收集 GPU 性能指标的方法:
使用诸如 之类的命令行工具
nvidia-smi,它可以以 Pretty-Print 和`xml`。
该工具内部基于NVML(NVIDIA Management Library)。
它收集高级指标,例如 GPU 和内存“利用率”(使用频率)、设备温度、功耗等。
使用类似服务dcgm-exporter,可以输出Prometheus格式的数据。
该服务内部基于DCGM(数据中心GPU管理)。
除了高级指标之外,它还可以执行分析并收集关于 GPU 设备饱和度数据详细信息。
nvidia-smi以下是两个仪表板集合,显示从和收集的指标dcgm-exporter:

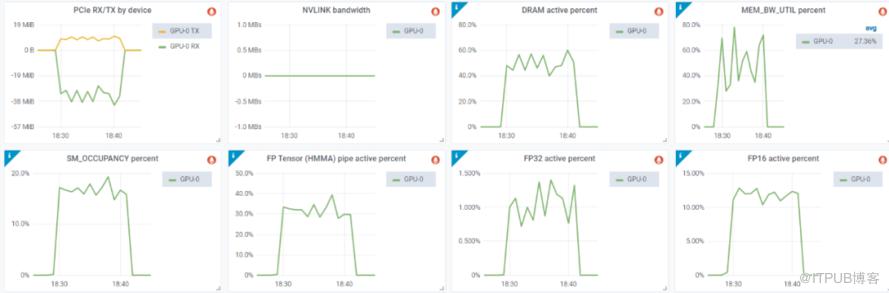
我们可以看到当GPU 利用率为 100%时,SM占用率非常低(<20%),浮点运算(FP32/FP16/TensorCore)也保持在非常低的百分比,这表明GPU还没有饱和。
总结
不确定NVML设计者是否有意采用上述“USE”方法,但似乎其对“利用率”(包括GPU和内存利用率)的定义与“USE”标准一致。
nvidia-smi报告的“利用率”仅表示设备的使用频率(以时间百分比表示),而不考虑正在使用的GPU是否被占满。
虽然nvidia-smi它是一种常用且方便的工具,但它并不是性能测量的最佳选择。对于实际部署中的GPU应用,建议使用基于DCGM的指标,例如dcgm-exporter.
此外,密切关注饱和度指标可能是有益的。这些指标包括 FP64/FP32/FP16 激活、张量核心激活百分比、NVLINK 带宽、GPU 内存带宽百分比等。

原文作者:Tim在路上;如有侵权,请联系管理员删除。

