从Sora文生视频模型爆火以来,再次凸显了训练大模型中数据工程的重要性。Sora模型的成功不仅依赖于其先进的算法架构,更在于其背后精细的数据工程支持。
从透露出的信息来看,要实现Sora的效果,不仅需要考虑数据输入中的配比,包括高质量数据和从互联网上爬取数据是如何组合,以及不同数据输入模型训练的次数如何配比。
还需要数据工程师进行精准的数据预处理和转换,包括如何设计视频的输入,是否截断、长宽比、像素优化,以及patches 的输入方式、还需考虑文本描述和文本图像对的质量。
以及如何消除数据中的噪声,低质量数据,提高混合数据避免单一类型结果输出,提高模型的训练效果。
然而当前很多人依然只愿意深挖研究做模型训练工作,对于数据工程是不愿意去做去研究的。谢赛宁曾说过,”对于Sora这样的复杂系统,人才第一,数据第二,算力第三,其他都没有什么是不可替代的。“在当前的大模型训练中数据是非常重要的。
所以本篇文件就来浅浅的探讨一下,好的数据对于模型的影响,希望对您可以有所帮助。
一个好的数据集的组成
当谈及数据的重要性时,大家可能首先想到的是数据科学领域中广为流传的名言:“Garbage in, Garbage out”。
这句简洁而深刻的格言揭示了一个无可辩驳的事实:如果输入的数据是低质量的、混乱的或是不准确的,那么无论模型的算法多么先进,其输出结果也必然是低劣的,甚至可能完全失去实用价值。这句话不论在大模型还是小模型都是适用的。
所以说,模型的数据一定程度上决定了模型的质量。可以说假如我们有一个不计成本的大规模高质量对话标注数据,只要我们模型的泛化效果好,那么通过自监督的学习就可以学成类似ChatGPT的效果。
那么我们首先想要考虑的就是,什么是一个好的数据集。
定义1:一个好的数据集应该既包含目标任务的训练数据,还应该包含可迁移能力的相关训练数据。
那么什么是可迁移能力的相关数据?提到可迁移能力就需要了解一下什么是迁移学习。
迁移学习指的是:我们可以在某个领域(A领域)学习模型训练模型,然后将这些知识在另一个领域(B领域)中应用。
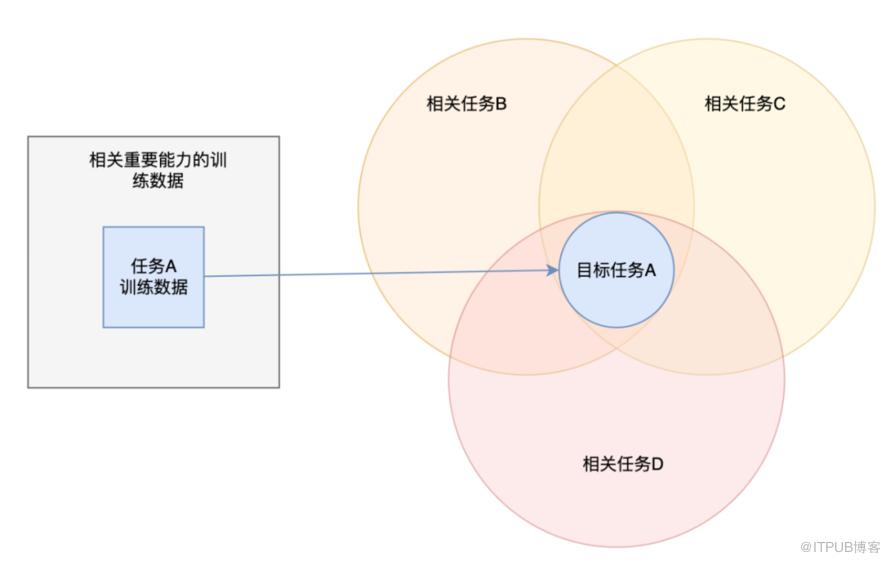
对于ML/DL的数据,每个数据集都有其独特的特点和价值。有些数据集侧重于让模型学会常识(Common Sense)。这类数据集通常包含大量的日常生活场景和情境,让模型通过学习和理解这些场景,逐渐积累起对世界的基本认知。
另一些数据集则注重培养模型的推理能力。这类数据集通常包含一系列具有逻辑关系的问题和答案,要求模型通过分析和推理来找到正确的答案。
还有一些数据集则专门用于提升模型的对话能力。这类数据集包含大量的对话文本,让模型学习如何在不同场景下与人进行自然的交互。
因此,在收集数据集时,我们需要根据我们的目标和需求来精心挑选和准备“食材”。就像一位厨师在准备料理时,会根据菜肴的类型和口味来选择合适的食材和调料一样,我们也需要根据模型的任务和可迁移能力的需求来选择和构建合适的数据集。
只有这样,我们才能确保模型能够学到我们期望的知识和技能,并在实际应用中展现出优秀的性能。
例如,假如我们要创建一个外卖客服机器人,我们的目标数据应该包含了大量与外卖服务、订单处理、客户反馈等相关的对话,模型通过学习这些数据,能够熟练掌握处理外卖客服相关问题的技能。
然而,仅仅依赖这些目标任务数据是不够的。为了让客服机器人更加智能和人性化,我们还需要为其添加基础对话能力和日常生活常识的数据。这种数据混合的方式就像是厨师在烹饪时巧妙地将各种食材和调味料融合在一起,创造出既符合特定口味又具有广泛吸引力的美食。
而这个概念就是数据混合,是我认为在LLM预训练跟微调中最重要的关键。
数据混合
数据混合在大型语言模型(LLM)的预训练、持续预训练以及监督微调阶段都扮演着至关重要的角色。它决定了模型能够学习到哪些类型的可迁移能力,并直接影响到模型在不同任务上的表现。
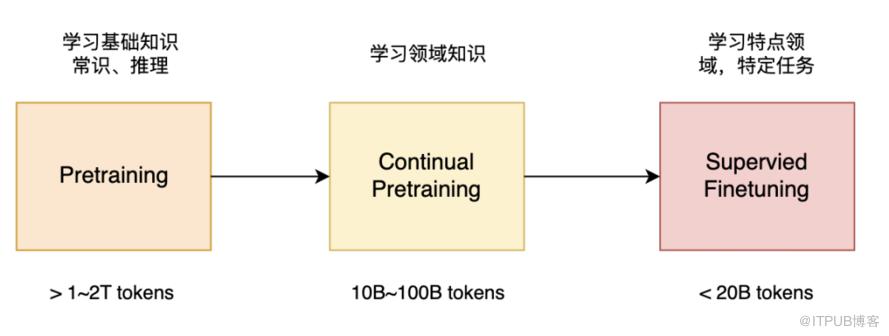
以下是关于这三个阶段中数据混合的详细讨论。
预训练阶段
在预训练阶段,数据混合的主要目标是让模型掌握广泛的语言知识、常识和推理能力。因此,我们需要构建一个多样化且规模较大的数据集,以触发LLM的各种基础能力。
预训练是LLM模型“学习”到最大能力的关键阶段,例如LLaMa-2的2T的tokens、Qwen的3T的tokens,未来我们可能看到更大LLM模型的tokens,这种大规模的训练量确保了模型能够捕获到语言的复杂性和多样性,它使模型能够学习到语言的普遍规律和结构,从而在各种不同的任务上展现出强大的泛化能力。
Meta AI与PSL大学在2023年6月做了一个非常有趣的实验,研究人员对GPT2模型进行了持续的观察和记录,分析了模型在预训练的不同时间阶段,模型所展现出的语言能力种类和水平。
研究人员发现GPT2在预训练过程中逐渐学习到了越来越多不同种类的语言能力。这一发现表明,随着训练的进行,模型不仅提升了现有任务上的性能,还扩展了能够处理的任务范围。而这甚至只在GPT2 * 48GB的训练数据上面的现象,如下图所示。
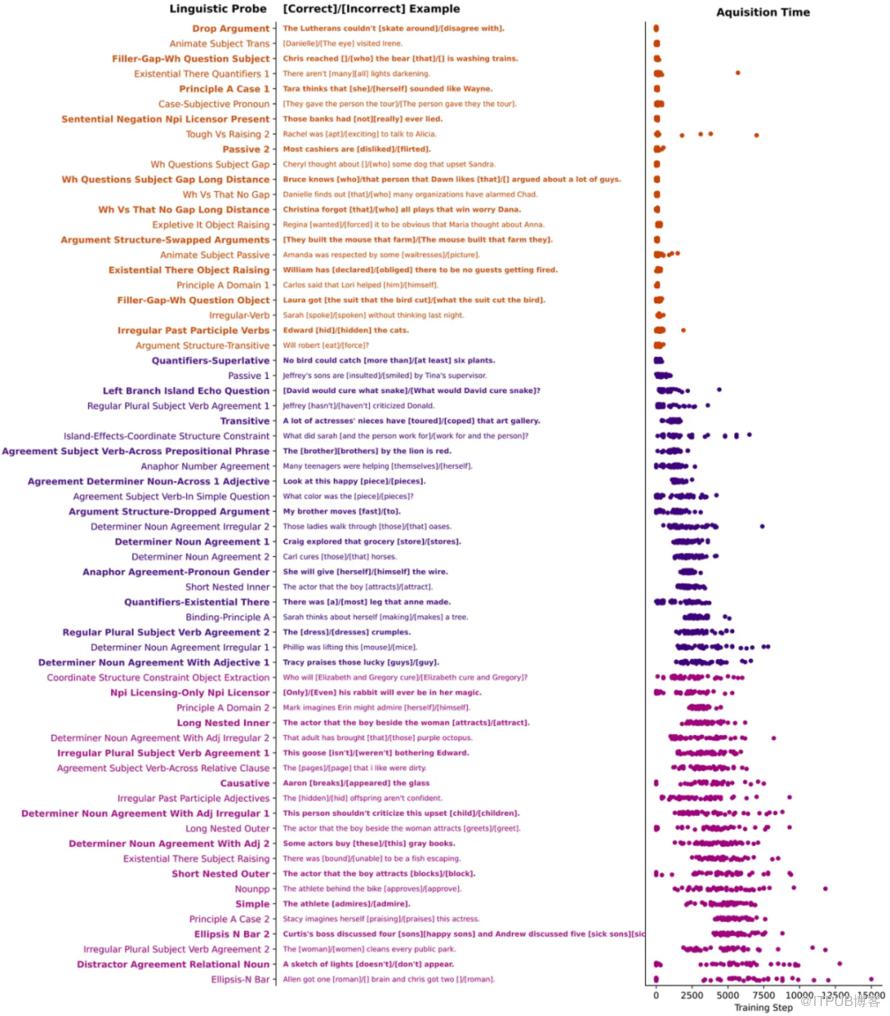
因为预训练阶段LLM能够学到最多的基础能力,所以就像是要教小孩子一样,打好基础的重点是:什么都要学到,而且不要过度偏科。
过去,我们已经从一些事件中获取了宝贵的经验和知识。
1. 在建立基础的预训练数据方面:
GPT2开放AI模型仅通过WikiText数据集就展现出了相对鲁棒的基础语言能力;
而LLaMa1和Chinchilla模型则在数据混合方面进行了进一步的尝试。它们不仅使用了Common Crawl和C4这样的大规模网络爬取并清理过的数据集来强化语言能力和大多数知识、常识,还纳入了像Wikipedia这样的正式知识内容源,以及The Pile中包含的丰富文学书籍。此外,StackExchange和Github为模型提供了编码内容的学习资源,而Arxiv则提供了更高级的学术知识。这样的数据多样性使得模型能够接触到更广泛的知识领域,从而提升了其理解能力和应用能力。
2. 在提高”多学科平衡“方面:
Common Crawl就提供LLM相对强大的基础常识,在MMLU上可以比混了维基百科的数据混合达到更好的分数,但差距并不明显。
其次,Galactica和Minerva这两个模型在训练过程中加大了论文数据的比重。通过纳入更多的学术内容,它们全方位地提升了LLM的理解能力,特别是在自然科学领域,可以获得更专业的回答。
此外,我们还看到编码数据的加入对于提升LLM的理解能力也起到了积极作用。研究表明,将代码数据纳入训练过程中,可以使模型更好地理解编程逻辑和代码结构,从而提升其在编程相关任务上的表现,甚至对于一些逻辑推理能力可以通过生成的编码实现沙盒运行,并获取推理的结果。
Meta为了进一步提升LLaMa2模型的编码能力,专门训练了500B的编码数据,最终得到了code-llama模型。这一举措充分展示了针对特定领域的数据优化对于提升模型在该领域性能的重要性。
3. 提高多语言能力
在LLaMa1的训练资料中,英文占据了绝大多数(约89.7%),而中文则只有不到0.13%,这导致了模型在中文处理方面的能力相对较弱。相反,像Baichuan2和Qwen这样的模型,由于使用了大量中文和英文相关的数据,因此它们在双语处理方面表现出了更强的能力。
综上所述,预训练数据的选择和配比对于模型性能至关重要,如果我们有着”世界第一的模型“,但输入模型的数据不怎么样,那么其训练的结果也会是非常差的。
当然除了数据的选择以外,我们也应该关注数据的配比,分布和训练。
另外一点就是,我们需要学会解读Public Benchmark的分数,理解分数背后的预训练数据对LLM能力的影响。例如,使用大量网页文本数据进行预训练的模型可能在文本生成和语言理解方面表现出色;而使用学术论文进行预训练的模型则可能在逻辑推理和科学理解方面更具优势。
因此我们不仅需要知道哪些数据引起了模型当前的基础能力,还需要能够预测不同数据组合对模型未来能力的影响。
这需要对LLM的工作原理、数据驱动的学习机制以及不同数据集的特性有深入的了解。通过这样的分析,可以更加精准地选择预训练数据,以实现对LLM能力的定制化提升。
持续预训练阶段
相较于预训练,持续预训练(Continual Pretraining)的重点是在于加强已有基础能力的模型在特定领域的知识。
一般我们通过利用10B~100B tokens的数据,持续预训练旨在进一步提升模型在特定领域内的表现。
然而,在持续预训练的过程中,一个关键挑战在于如何避免模型在学习新知识时遗忘旧知识,即所谓的“遗忘”(Forgetting)问题。遗忘是一个普遍存在的现象,尤其在处理大量数据时更为突出。
哈佛和斯坦福的研究团队确实就LLM在训练过程中的遗忘问题进行了深入的研究,并发表了相关论文。
它揭示了一个关键现象:随着LLM不断吸收新知识,它可能会逐渐遗忘最初学习的内容。
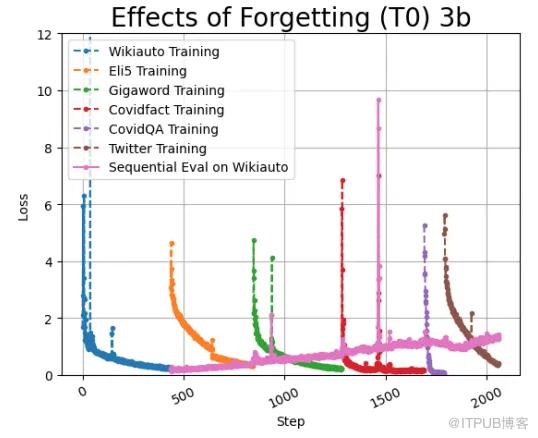
因此在持续预训练这个阶段通常我们会「混入持续模型通用知识的数据」,让模型不断「复习」这些重要知识。
一些研究者为应对这一问题,在训练过程中平衡新旧知识的权重,确保模型在学习新知识的同时,也能够保持对旧知识的记忆。
例如,BloomBergGPT在训练时用了金融数据跟通用数据1:1的比例,ChatHome则进行消融研究发现领域数据跟通用数据大概在1:5~1:10之间。

然而,关键并不在于确定一个固定的最佳比例,因为不同模型、不同任务和不同数据集可能都会有所差异。相反,重要的是在持续预训练过程中,通过监控损失来观察模型是否开始遗忘,并据此调整数据配比。
这个时候就体现了Scaling Laws的重要性,我们可以使用缩放法则(Scaling Laws)来帮助确定最佳的数据配比。通过应用这些法则,我们可以更系统地探索不同数据配比对模型性能的影响,并找到最适合当前任务和数据集的配置。
监督微调阶段
在有监督的微调阶段,确实存在两个核心目标:一是希望模型能够学会对话并解决特定任务,而不仅仅是预测下一个字;二是进一步让模型具备特定领域的任务能力。这两个目标共同构成了微调阶段的主要任务。
在追求这些目标的同时,我们还需要特别关注“遗忘”的问题,我们依然重视的是「让LLM学会专业任务的前提下,也要兼顾同样的基础能力,不要变成一个只解任务的专家。」
很多公司会收集完一包特定任务的SFT训练数据就直接丢去finetune,结果finetune 3~5个epoch后发现LLM完全忘记怎么说话。这就是典型的把模型做成只能解特定任务的专家了。
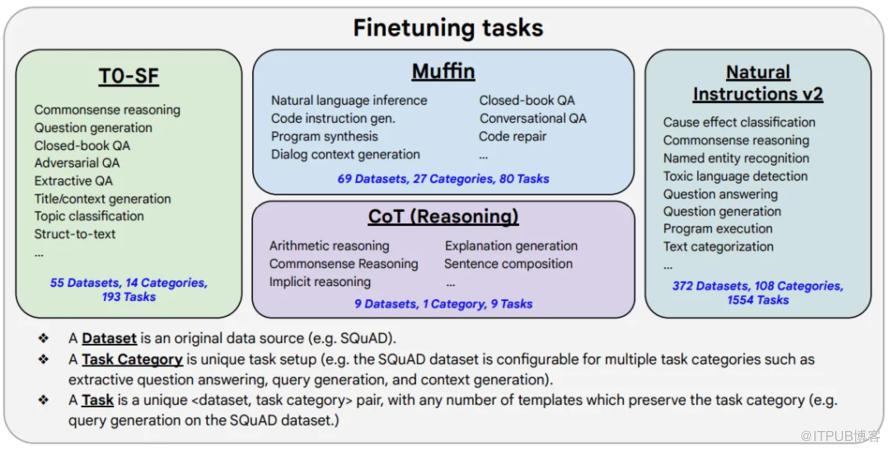
Google在2022年提出了Flan v2数据集,为了让LLM学会解决通用任务对话,而Flan v2中提出出来,当我们把越来越多的多种类的监督数据包含进我们的SFT数据后,可以显着的著作提升了我们模型各个方面的能力。
MAmmoTH 采取类似概念,在训练模型数学理解能力时,也混入大量不同方面的数学理解微调数据,并构建出MathInstruct,包含大部分的数学通用能力,如下图。
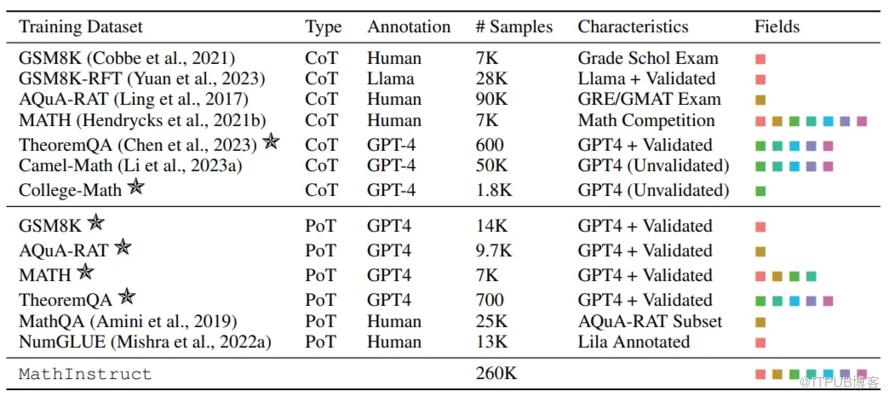
因此当我们要进行SFT的时候,我们不仅仅要特定任务的数据,还要尽量混一些跟这个任务相关的其他监督微调数据,让模型变成一个大范围任务都通用的才通,而不是特定学会任务就忘记基础能力。
数据质量
说到数据,我们无法避免的一个话题就是数据质量。
这是因为在数据集中较大数据量的数据并不总是会带来更好的性能,但更高质量的数据集却可以。
数据质量在LLM的训练、微调过程中通常包含两个涵义:
数据是好的,数据的格式规范,多样性,包含足够多的信息,具有一定逻辑性。
数据不是坏的,不包含任何会让LLM学坏或者学不起来的性质,例如色情,暴力,歧视,大量重复。
Lee et al. 的研究揭示了模型学习基础数学运算的一个关键发现。他们发现,如果只是简单地将如“128+367=495”这样的等式作为训练数据,模型在学习时会遇到一个明显的性能上限,并且学习速率也会较慢。
这是因为模型没有接触到运算的内在逻辑和过程,只是机械地记忆了等式的结果。
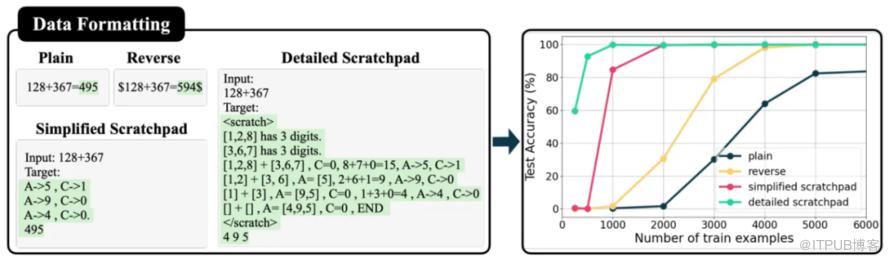
然而,当研究者将更多的运算过程,包括中间逐位运算以及进位的过程都加入到训练数据中时,模型的学习效果发生了显著的变化。
这种训练方式不仅使模型能够以更短的时间学会基础数学运算,而且所需的训练数据量也减少了。这是因为模型通过学习运算的内在逻辑和过程,能够更好地理解和泛化到新的运算实例上。
这一发现对于LLM的训练具有重要的启示意义。它告诉我们,在训练模型时,除了提供最终的结果外,还应该尽可能地展示任务的内在逻辑和过程。这样可以帮助模型更深入地理解任务,提高学习的效率和泛化能力。
另外,在MAmmoTH中,它采用了CoT(Chain of Thought)和PoT(Prompt of Thought)策略来构建其有监督的微调数据集,以达到更好的效果。这种方法的核心思想是让模型(例如GPT-4)在解决问题时尽量详细说明自己的思考过程,从而得到更完整的训练资料。
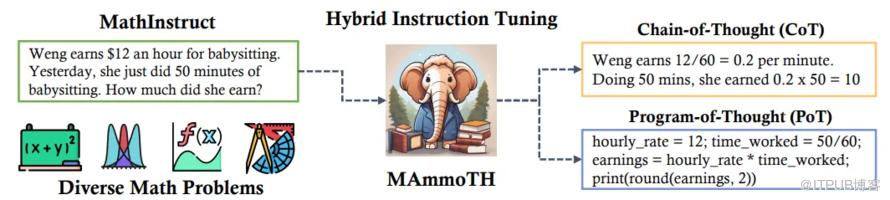
这种方法的优势在于它充分利用了模型的生成能力,使得训练数据更加贴近人类的思考过程,从而有助于模型更好地理解并完成任务。
所以说,高质量的训练数据应该包含丰富的任务信息和内在逻辑。从微观层面来看,训练资料中是否包含足够详尽的推理过程是影响模型学习的一个重要因素。这一点非常直观且易于理解。
如果模型仅仅接触到“问题-答案”这样的数据对,那么它很有可能只是在机械地记忆答案,而没有真正理解和掌握问题的本质和解决方法。这种学习方式可能导致模型在遇到类似但稍有变化的问题时无法给出正确的答案,因为它没有学会如何推理和解决问题。
相反,如果我们在训练资料中提供“问题-答案-解题过程”这样的完整信息,模型就能够更清楚地理解整个学习的重点和逻辑。通过观察和分析解题过程,模型可以学习到如何逐步推导答案,从而真正掌握问题的解决方法。这种学习方式不仅提高了模型的准确性,还增强了其泛化能力,使其能够更好地应对各种复杂和多变的情况。
最为突出的一个例子就是,Meta提出的LIMA,这个论文证明了「SFT Data的品质比SFT Data的数据量更重要」这个结论。
在LIMA论文中,他們只使用1,000个sample就达到了比其他SOTA更强的效果。
1. 任务多样性非常高
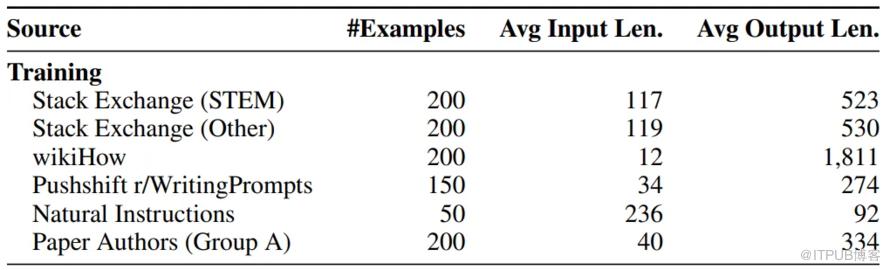
LIMA在仅仅1000个样本的数据集中就覆盖了STEM、wiki、code等多个领域,这显示出其极高的任务多样性。这种多样性不仅有助于模型更好地泛化到各种任务上,还能提升模型在处理不同领域问题时的能力。
特别是在STEM领域,LIMA涵盖了75种不同的子领域,而其他类别则包含了99种不同的问题领域,这进一步增强了数据集的丰富性和挑战性。
2. 不仅仅是回答,包含完整的解释
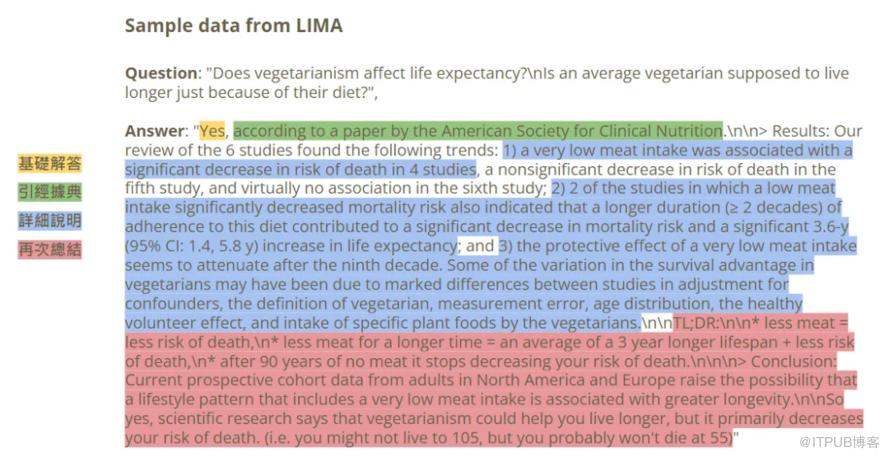
LIMA数据集中过半的资料都包含了完整的解释,而不仅仅是简单的回答问题。这种解释性不仅有助于模型理解问题的本质和解决方法,还能提升模型生成回答的可信度和准确性。
LIMA的资料大多遵循“基础回答、引经据典、详细的说明、最后再次总结”的风格,这种格式使得每个回答都成为一个完整、连贯的论述,有助于模型学习到更深入的推理和解释能力。
这种高质量的数据集对于模型训练来说至关重要。通过使用这样的数据集进行微调,模型可以更好地理解任务的本质和需求,从而提升其在各种任务上的表现。
同时,这种数据集的构建方式也为我们提供了一种有效的策略:在构建训练数据集时,我们应该注重数据的多样性和解释性,以提升模型的学习效果和泛化能力。
总结
数据是所有大型语言模型(LLM)训练中的一个关键问题,数据的考量既多面又复杂,相比于模型我们在这方面实际上是欠缺的。
数据处理中,最为重要的就是数据混合(Data Mixture)和数据质量(Data Quality)。
数据混合需要关注的是:我们应该在训练数据中加入哪些种类的数据?这些数据将赋予LLM哪些能力?选择正确的数据类型和比例,能够确保模型在训练过程中接触到丰富多样的任务场景,从而增强其泛化能力和适应性。
数据质量需要关注的是:每个数据是否可学、好学,即数据是否清晰、准确,是否包含足够的推理过程,以便模型能够从中学习到有用的信息和知识。另外还需关注整个数据集是否存在某些糟糕的性质没有被处理好,比如数据偏差、噪声等,这些问题可能会对模型的训练效果产生负面影响。
只有通过精心设计和优化数据混合和数据质量,我们才能训练出性能更优越、泛化能力更强的模型。由于能力有限很多东西没有涉及很深,希望本文能为大家提供一些有益的启示和帮助。
Reference:
https://axk51013.medium.com/llm專欄-迎接2024年-10個必須要搞懂的llm概念-2-good-data-is-all-you-need-1e9e760c016
https://medium.com/scb-datax/data-quality-is-all-you-need-d6a9848e556a
Touvron, Hugo, et al. “Llama: Open and efficient foundation language models.” arXiv preprint arXiv:2302.13971 (2023)
Zhou, Chunting, et al. “Lima: Less is more for alignment.” arXiv preprint arXiv:2305.11206 (2023).
Chung, Hyung Won, et al. “Scaling instruction-finetuned language models.” arXiv preprint arXiv:2210.11416 (2022).
原文作者:Tim在路上;如有侵权,请联系管理员删除。

