我知道现在聊GTC24可能已经晚了,不过可以借着GTC24这个话题,简单聊几个Nvidia GPU的关键问题。
在AI还没有爆火的时候,GTC一直不是什么大事,它主要影响在游戏和加密领域。但现在它彻彻底底的出圈了,感觉一切都变了一样。
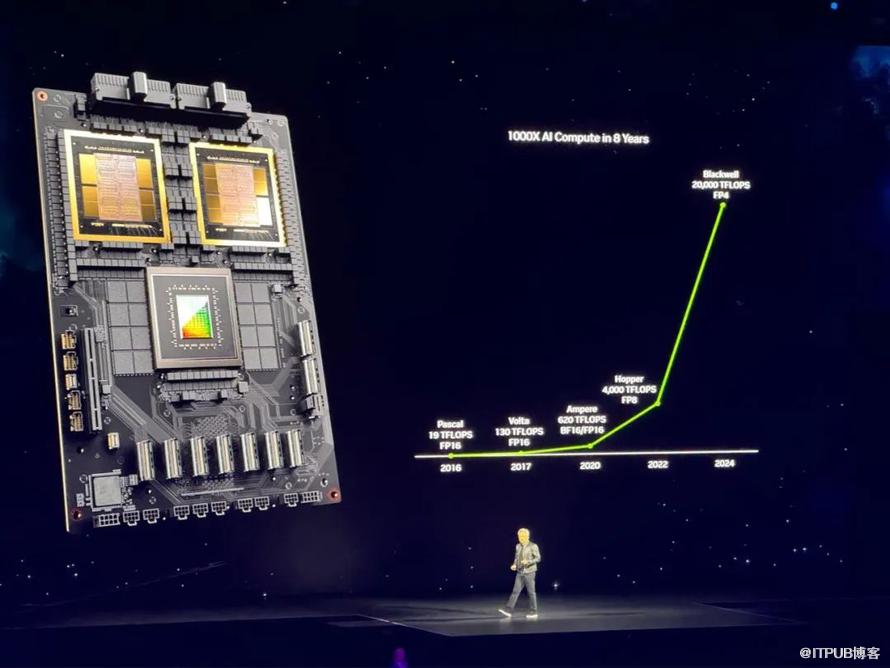
今年参会的人数非常的之多,老黄还特地换了一个大的会场,不论是投资界,科技界,还是一些吃瓜界都关注着GTC。去年美国对中国芯片加强了禁售协议,但Nvidia的财报丝毫没受影响,营收为上一年的3.5倍之多,股价在16个月内上涨了六倍,市值也来到了全球第三的位置。
Nvidia内部有许多员工已经实现了财务自由,同时老黄呼吁员工不要躺平。那么在Nvidia坐拥市值第三的宝座的背景下,即将举行的GTC大会将是一个窗口,人们希望去看到Nvidia未来如何发展,如何守住霸主地位,以及未来还有多大的增长空间的期望。
继续加倍Blackwell
Blackwell 是美国统计学和数学先驱 David Harold Blackwell 博士的名字,是他编写了第一本贝叶斯统计教科书,现在它是Nvidia新一代GPU架构的名字。
可以说,NVIDIA 内部已经形成了一套针对如何进行 GPU 开发的非常可靠的系统手册,这种手册其实是建立在其与服务的客户深度绑定的前提下。
Nvidia当前的触角基本深入到了各个公司,在帮助他们进行优化使用效率和性能时,同时收集客户的痛点,这使得其可以正确识别当前和未来的趋势,以及客户对高性能加速器的需求,那么接下来需要做的就是高效的投资和更新这些工作负载所需的硬件,然后优化这些需求。
NVIDIA 改进了从性能到内存带宽的芯片设计的各个方面,每个元素都旨在提高特定工作负载/场景中的性能或消除可扩展性的瓶颈。
GB200 Superchip
当然目前Nvidia仅提供了Blackwell架构的性能和实现的简报,详细的信息还没透露,如下所示:
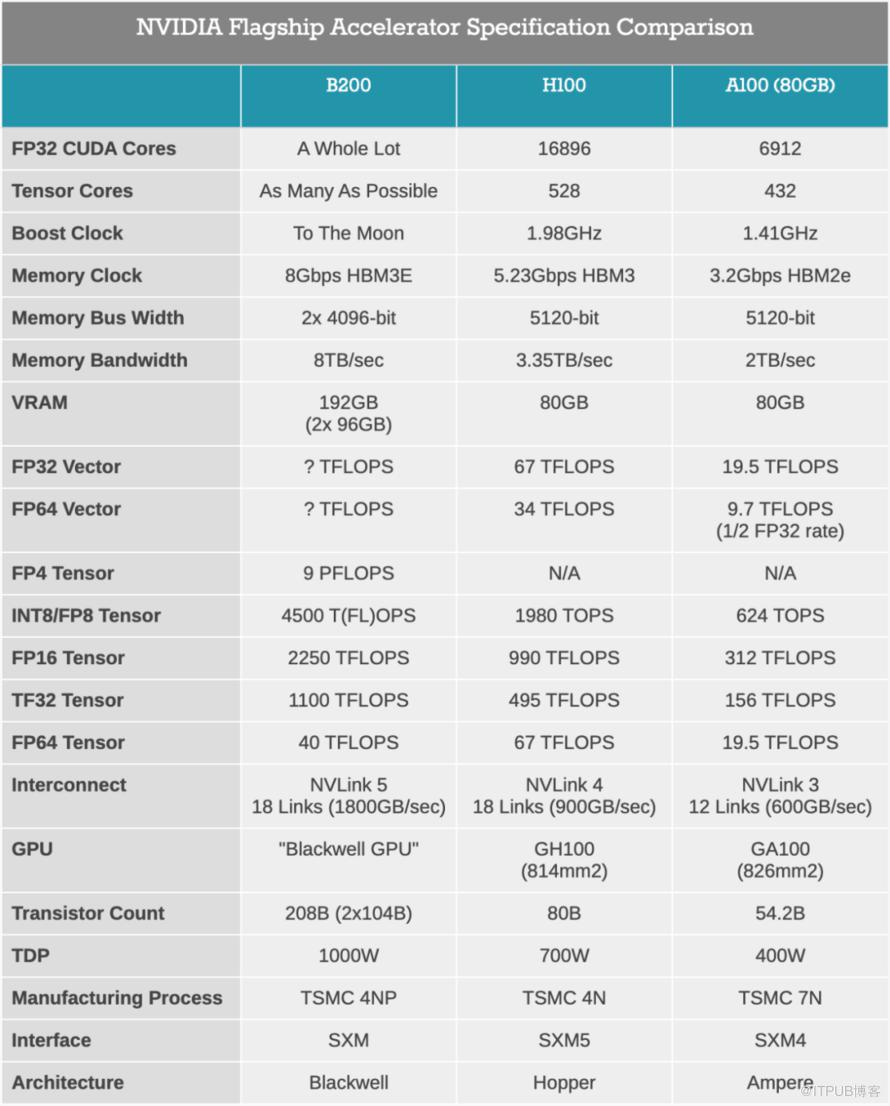
上图为B200与H100和A100的比较图示,与 Nvidia H100 GPU 相比,其 GB200 Superchip 对于大型语言模型推理工作负载的性能提升高达 30 倍,同时能耗降低高达 25 倍。
GB200 Superchip它将两个 Blackwell GPU 可以组合并与 Nvidia 的 Grace 中央处理单元配对。
不过由于 GH100 芯片本身已经接近台积电的 4 纳米模版极限,因此 NVIDIA 芯片增长空间应该不大,其性能的提升绝大部分增益应该来自架构上的提升。
从上图我们可以看出,晶体管数量为 208B,即每个芯片 104B 晶体管。GH100 是 80B 晶体管,因此每个 B100 芯片总体上多了大约 30% 的晶体管,这和A100到H100的增加是差不多的,只是这次将两块芯片拼成了一块。那么要实现两个芯片像一个芯片一样使用,其关键就是芯片之间的高带宽 I/O 链路。NVIDIA 称其提供 10TB/秒的带宽,这意味着芯片可以在每个方向上同时发送 5TB/秒。
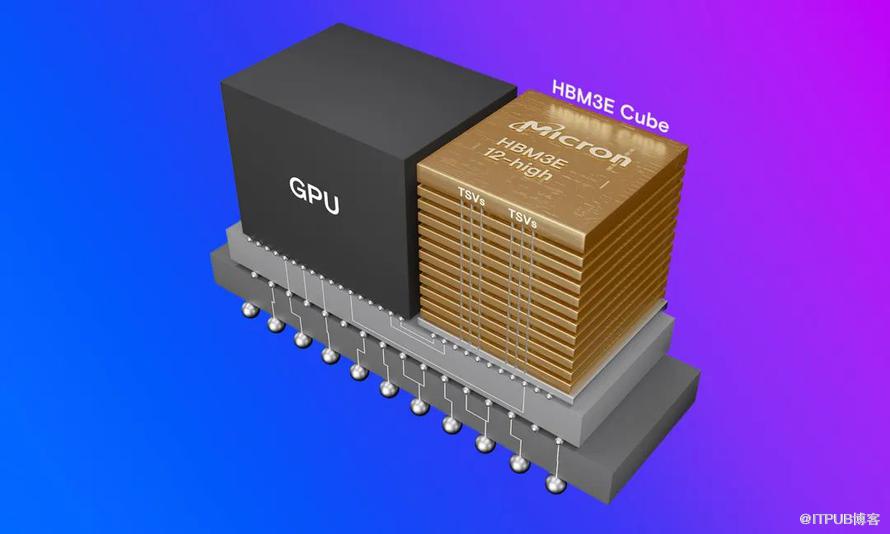
其次,在内存带宽上每个芯片通过4个引脚与4个HBM3E配对,两个芯片8个HBM3E,每个HBM3E可以提供1TB每秒的内存带宽,总共提供了8TB每秒的内存带宽,超H100的2.4倍。
CUDA编程性能的一个关键就是内存带宽,B200不仅加大了内存的容量达到192GB 的 HBM3E,而且总带宽也达到了8TB/s,这是一个显著的性能提升。
由于 NVIDIA B200 仍采用 4 纳米级工艺,现在将两倍多的晶体管封装到单个 Blackwell GPU 中,所以其功耗也必然上升,高于 H100 的 700W,达到了1000W,B200是两个芯片合一的,但其功耗并未达到H100功耗的2倍,可见其功耗单个相比是下降了的。
所以总的来说,与集群级别的H100 相比,NVIDIA 将训练性能提高 4 倍,将推理性能提高 30 倍,同时能源效率提高 25 倍。
第二代的Transformer Engine
NVIDIA当前在大模型的训练上,绝对是占主导地位的,但推理上竞争更加加剧了。尤其是Groq芯片的诞生,大幅降低了延时,存在一定的应用场景。NVIDIA通过加倍的性能提升,就是在对外界进行回应,其有实力保留在AI芯片领域的绝对权威,使得其可以稳住AI芯片销售的占比,守住霸主地位。
Blackwell的另外一个看点就是其第二代的Transformer引擎。
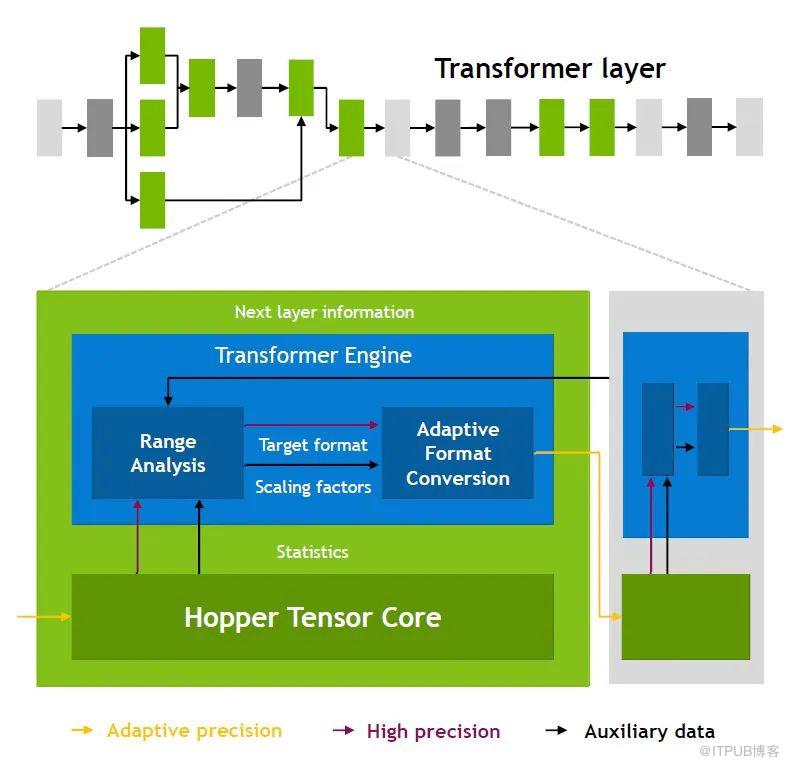
NVIDIA与Hopper架构的重大胜利之一是其决定优化Transformer型模型的架构。这项优化包括引入专用硬件,被NVIDIA称为Transformer Engine。通过利用Transformer模型不需要以高精度(FP16)处理所有权重和参数的事实,NVIDIA添加了对将这些操作与较低精度(FP8)操作混合的支持,以减少内存需求并提高性能吞吐量。当GPT-3/ChatGPT在2022年晚些时候起飞时,这个决定获得了巨大的回报,成为历史上的一大成功故事。
针对第二代Transformer引擎的发展,NVIDIA面临着新的挑战。Blackwell引擎特别针对低精度计算进行了优化,能够处理最低至FP4精度,并着眼于使用非常低精度的格式进行推理。
为了应对那些FP4精度不足以满足的工作负载,NVIDIA进一步扩展了其支持的精度范围,增加了对FP6精度的兼容。虽然FP6精度在计算性能上并不比FP8有显著提升——因为它在NVIDIA的张量核心中本质上仍然是以类似FP8的方式进行操作——但由于数据大小缩小了25%,它在内存占用和带宽需求方面带来了显著的优势。
对于大型语言模型(LLM)的推理任务而言,内存容量依然是这些加速器所面临的主要限制。因此,在推理过程中降低内存使用量成为了一个亟待解决的问题。通过采用低精度格式如FP4和FP6,可以在保持推理质量的同时,有效减少内存消耗,这对于提升LLM推理的效率和可行性至关重要。
与此同时,在训练方面,NVIDIA 计划在 FP8 上进行更多训练,而不是 BF16/FP16。但 LLM 训练中使用的精度最终不在 NVIDIA 的控制范围内,而取决于开发人员,他们需要优化模型以在这些低精度下工作。
虽然Transformer引擎可以处理较低精度的格式,而不会损失太多的精度。但是FP4 相当低。所以,未来NVIDIA 及其用户打算如何以如此低的数据精度来满足他们的准确性需求,决定了 Blackwell 作为推理平台的成败。
第五代 NVLink
除了使用更多TensorCore和更多内存带宽之外,加速性能的第三个关键因素是互连带宽。NVIDIA 碾压华为等芯片的杀手锏就是其专有的 NVLink 互连系统。在 Blackwell 架构中继续对其带宽和可扩展性方面进行迭代。

总体上看,NVIDIA 将 NVLink 的带宽从每 GPU 900GB/秒增加了一倍,达到每 GPU 1800GB/秒。与上一代产品相比,这是过去几年来 NVLink 带宽的最大跃升,因为 2022 Hopper 架构的 NVLink 带宽仅比上代提高了 50%。
值得注意的是,尽管NVIDIA将GPU芯片数量翻倍,但互连带宽也翻了一倍,因此每个芯片接收的数据量并没有改变。然而,由于两个芯片需要作为单个处理器一起工作,因此需要传输和重新排列的数据总量显着增加。
另一个有趣的方面是,每个GPU的NVLink数量在幕后没有改变;GH100 Hopper的NVLink容量为18个链接,Blackwell GPU的NVLink容量也是18个链接。因此,NVLink 5带来的所有带宽增益都来自于链路内每个高速对的200Gbps更高信号传输速率。这与前几代NVLink的模式一致,每次迭代都会使信号传输速率翻倍。
除此之外,由于NVLink 4的链路数量保持不变,本地芯片拓扑选项基本上也保持不变。NVIDIA的HGX H100设计结合了4路和8路设置,HGX B200/B100设置也将相同。这并不意味着NVIDIA没有增加NVLink域中GPU数量的雄心,但这将在机架级别而不是节点级别实现。
Nvidia不希望成为一个纯硬件公司
在过去的十年中,Nvidia早已开始着手布局CUDA,这一举措实际上构建了其最为坚实的护城河。根据Omdia公司的研究数据,目前Nvidia在AI芯片销售额中占据超过70%的市场份额,并且在训练生成型AI模型方面处于领先地位。
从Nvidia的发布会可以看出,该公司更加注重突出其在软件上的更新。一直以来,Nvidia都是软硬件协同发展的倡导者,致力于打造整体的芯片生态系统。然而,这一重点与观众的期待有所不同,因此在GTC大会上并未受到太大的关注。然而,从中我们可以窥见Nvidia对未来十年布局方向的雏形。
Nvidia的高管也表明,随着产品多元化和扩展,公司已经不再是一个单纯追求利润的芯片提供商,而是转型为一个平台服务提供商。
如今在投资界,评估一家AI公司是否值得投资的标准已经不再仅仅是其技术创新的水平,而更关注其是否有能力获得GPU芯片渠道。而在这一点上,Nvidia无疑是当之无愧的领军者。
NIM 推理微服务
Nvidia还宣布在其Nvidia企业软件订阅中新增了一款名为NIM(Nvidia Inference Microservice)的新产品。NVIDIA NIM™ 微服务,可适用于 NVIDIA 及合作伙伴生态系统中 20 多个热门的 AI 模型进行推理优化
 NIM微服务提供了基于NVIDIA推理软件的预构建容器,包括Triton推理服务器™和TensorRT™-LLM,使开发者能够将部署时间从几周缩短至几分钟。这些容器将让开发者能够安全地使用托管在NIM基础设施中的专有数据,快速构建AI应用。
NIM微服务还为部署NVIDIA、谷歌、Hugging Face、Meta、微软、Mistral AI和Stability AI的开放模型提供了快速且性能出色的生产级AI容器。用户将能够从亚马逊SageMaker、谷歌Kubernetes Engine和微软Azure AI中访问NIM微服务,并与Deepset、LangChain和LlamaIndex等流行的AI框架集成。
CUDA-X 微服务
此外,用户现能够以 NVIDIA CUDA-X 微服务的形式使用 NVIDIA 加速软件开发套件、库和工具,用于检索增强生成(RAG)、护栏、数据处理、HPC 等。
CUDA-X 微服务为数据准备、定制和训练提供端到端的构建模块,助力各行各业加快开发生产级 AI。
为了加快 AI 采用,企业可以使用 CUDA-X 微服务,包括用于定制语音和翻译 AI 的 NVIDIA Riva、用于路由优化的 NVIDIA cuOpt™,以及用于高分辨率气候和天气模拟的 NVIDIA Earth-2。
Omniverse Cloud API
OMNIVERSE 平台是一个物理模拟反馈平台,用于训练AI以更好地与物理世界互动。
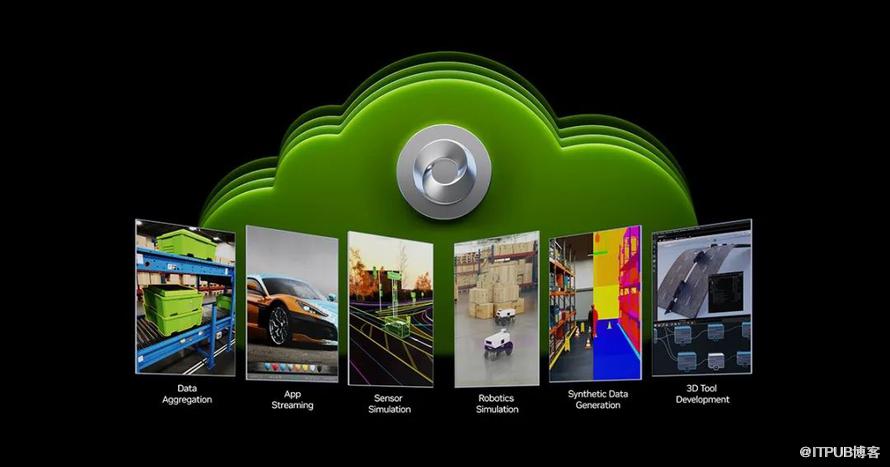
在GTC大会上,NVIDIA宣布推出了NVIDIA Omniverse Cloud API,旨在扩展Omniverse平台的应用范围,以更广泛地应用于工业数字孪生应用程序和工作流程中。此举也被认为是NVIDIA未来十年中重点关注的方向之一。据传言,老黄的子女都在该领域的部门担任产品经理。
在GTC主题演讲中,黄仁勋展示了Teamcenter X与Omniverse API的连接,使该软件能够将设计数据连接到NVIDIA生成式AI API,并直接在应用程序内使用Omniverse RTX渲染。
随着机器人、自动驾驶汽车(AV)和基于人工智能的监控系统的需求增加,开发人员正在寻求加速其端到端工作流程。
传感器数据对于训练、测试和验证从感知到规划和控制的全栈自主性至关重要。
Omniverse Cloud API连接了丰富的仿真工具和应用程序开发人员生态系统(例如Foretellix的Foretify™平台、CARLA、MathWorks),以及行业领先的传感器解决方案提供商(例如FORVIA HELLA、Luminar、SICK AG和Sony Semiconductor Solutions),以实现全栈培训并使用高保真、基于物理的传感器模拟进行测试。
AI的未来
本次GTC大会上的一个备受瞩目的环节,是邀请了Transformer八子进行讨论,这也是Nvidia快速发展的基石。
正是因为这篇论文,使得刚成立的OpenAI开始采用Transformer架构,开始了以堆算力和参数为基础的AI训练方法,这为今天我们所见的生成式AI革命奠定了基础。因此,这八位研究员可以称之为如今生成式AI的重要功臣。
有趣的是,以前这八位研究员从未聚在一个房间里进行面对面的讨论,他们主要通过线上合作来进行研究和办公。而这一次,除了一位女性研究员Niki Per因为家里有急事未能到场外,其他七位研究员都亲临现场。这种集体聚会对于整个领域的发展来说,这确实是非常有趣和有历史纪念意义的瞬间。
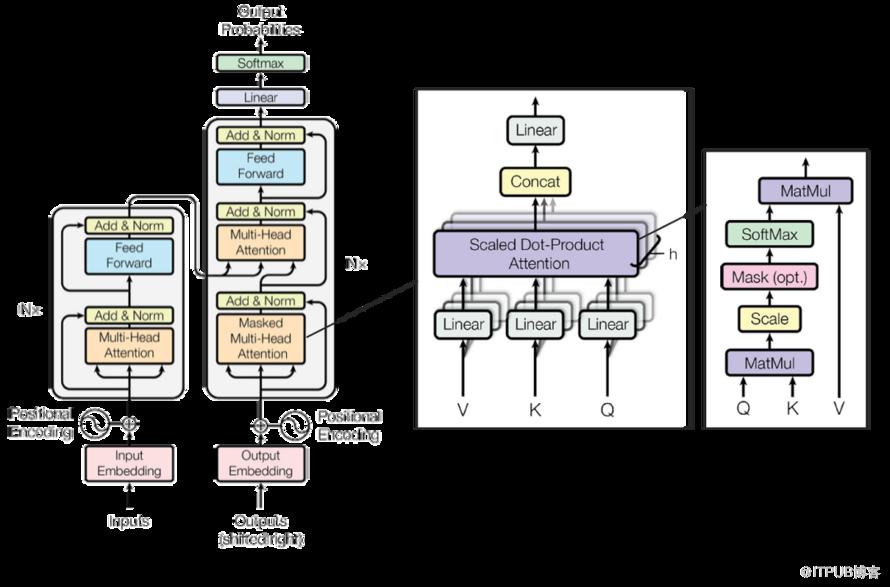
这几个Transformer作者也都一致认为,模型还需要进一步的优化,无论是在训练还是在推理上,我们还需要看到技术的持续的突破,甚至需要未来有比transformer更好的框架和模型。
而模型的演进确实一直在进行中,从transformer的变种,到论证attention还是FFN重要,到线性transformer的演进,例如mamba等架构的出现,预示着没有什么是不可替代的。
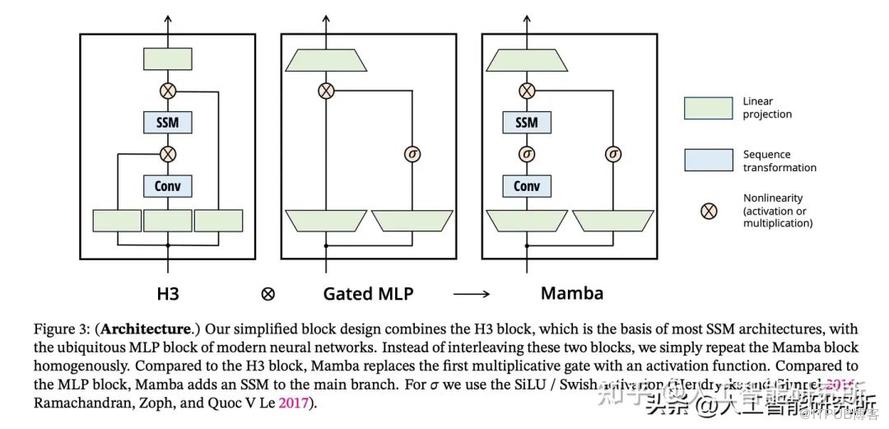
如果出现了一个更好的模型或框架,那Nvidia的GPU是否仍然是必不可少的,这确实需要打一个大大的问号。
当前Nvidia押注了Transformer模型,如果Transformer模型被替换,那么一些基于Transformer的硬件设计将失去竞争力。此外如果新的模型架构使得用更少的算力就可以训练和推理更大的模型,那么这将会是Nvidia最大的危机时刻。
但无论如何AI还是会继续的发展和变化,就如新技术的历史规律一样,从最为基础的大语言模型,将不断的先新的领域进行探索改造,图片,视频,语音,推荐,具身智能…,只有主动变化才能抵御变化。

原文作者:Tim在路上;如有侵权,请联系管理员删除。

