最近斯坦福大学研究人员推出的 Octopus v2火力,在Hugging Face上的模型一夜下载量超3k。
Octopus模型,是一个在设备上运行的语言模型,专为提高自动工作流程任务中的功能调用性能而设计。Octopus模型具有20亿参数,旨在解决大规模语言模型在云环境中运行时涉及的隐私和成本问题。该模型通过优化延迟和准确性,显著降低了上下文长度,并在性能上超越了GPT-4。
端侧 AI 其实一直非常重要优化方向,因为这块产品的落地依然存在着一些问题,不论是前一段的Groq芯片还是现在的Octopus模型,都想在未来的端侧AI进行占位。
下面我们就分析下论文,看看Octopus模型有什么玄学,到底做了什么,有什么创新点。
论文地址:https://arxiv.org/abs/2404.01744
Octopus是什么
首先需要注意的是,Octopus模型的开发目标是为了优化和提升那些自动化任务执行过程中所需的功能调用的效率和效果。在这里,"自动工作流程" 指的是通过软件自动执行一系列预定的任务或操作,而"功能调用"则是指在执行这些任务时,软件调用特定的代码块或API(应用程序编程接口)来完成特定的工作。

换句话说,假设你拥有一部安卓智能手机,并且你的手机内置了一个基于Octopus模型的智能助手。这个智能助手可以帮助你自动化日常任务和简化操作。
理解用户指令:
当你对手机说:“嘿,助手,明天早上7点的闹钟。” 智能助手使用Octopus模型理解你的自然语言指令,并识别出你想设置一个闹钟。
准确调用函数:
智能助手识别到“设置闹钟”是一个需要执行的动作,它会调用安卓系统提供的相关API函数,例如setAlarm(),来创建一个新的闹钟并设置正确的时间。
减少延迟:
在你下达指令的同时,智能助手迅速做出响应,几乎没有延迟。你几乎立刻就能在屏幕上看到新设置的闹钟确认信息。
提高效率:
智能助手在执行你的命令时,只激活了设置闹钟所需的功能,避免了不必要的后台进程和资源消耗,这样可以节省手机的电池寿命,并保持设备的流畅运行。
优化上下文处理:
如果你之前设置了多个闹钟,智能助手会根据当前的上下文信息(比如你刚刚提到的“明天早上”)来确定需要修改或设置的是哪一个闹钟,避免了混淆或重复设置。
我们可以看下论文里的这几个任务图片:

通常,检索增强生成 (RAG) 方法需要对潜在函数参数进行详细描述(有时需要多达数万个输入 token)。基于此,Octopus-V2-2B 在训练和推理阶段引入了独特的函数 token 策略,不仅使其能够达到与 GPT-4 相当的性能水平,而且还显著提高了推理速度,超越了基于 RAG 的方法,这使得它对边缘计算设备特别有利。
Octopus-V2-2B 能够在各种复杂场景中生成单独的、嵌套的和并行的函数调用。
Octopus效果如何
Octopus-V2-2B 在基准测试中表现出卓越的推理速度,在单个 A100 GPU 上比「Llama7B + RAG 解决方案」快 36 倍。此外,与依赖集群 A100/H100 GPU 的 GPT-4-turbo 相比,Octopus-V2-2B 速度提高了 168%。这种效率突破归功于 Octopus-V2-2B 的函数性 token 设计。
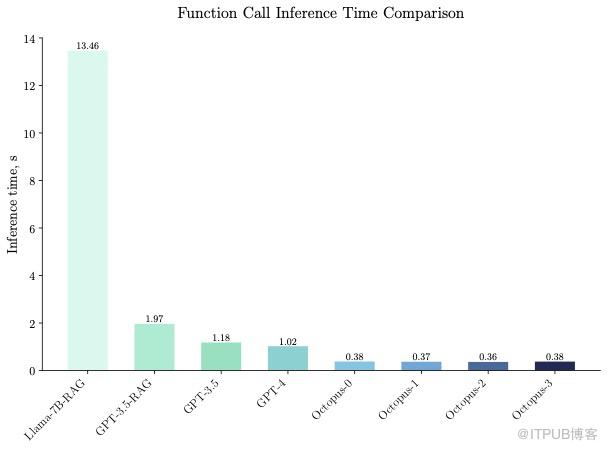
Octopus-V2-2B 不仅在速度上表现出色,在准确率上也表现出色,在函数调用准确率上超越「Llama7B + RAG 方案」31%。Octopus-V2-2B 实现了与 GPT-4 和 RAG + GPT-3.5 相当的函数调用准确率。

论文有什么创新
1. 核心函数的标记化:
Octopus模型通过将核心函数的名称标记化为特殊的功能标记(functional tokens),从而使得模型能够更准确地预测函数名称。这种方法将预测任务转化为在N个功能标记中进行单标记分类,提高了预测的准确性,并减少了生成函数名称所需的标记数量。
这种标记方式,目前在很多论文中都看到过,例如LLM x RS系统中的论文里。简单来说,就是模型中将每个核心函数都给一个对应的比较短的标记。例如,如果有一个函数用于调整音量,那么这个函数的名称可能会被标记化为一个特殊的标记,如
2. 训练数据集的构建:
为了训练、验证和测试阶段采用高质量数据集,特别是实现高效训练,研究团队用三个关键阶段创建数据集:
生成相关的查询及其关联的函数调用参数:
这个阶段的目标是创建一组数据,其中包含了用户可能发出的查询(例如语音或文本指令)以及与这些查询相对应的正确函数调用和参数。例如,如果用户想要调整智能手机的音量,那么相关的查询可能是“提高音量”,而关联的函数调用参数可能包括音量的具体调整数值。这些数据对于模型学习如何根据用户的指令正确调用API函数至关重要。
由适当的函数组件生成不相关的查询:
为了增强模型的泛化能力和鲁棒性,研究团队还生成了一些不相关的查询。这些查询虽然与模型将要执行的函数调用没有直接关联,但是可以帮助模型学习区分哪些查询是有效的,哪些是无效的。例如,如果模型收到一个与调整音量无关的查询,如“今天天气如何?”,模型应该能够识别出这个查询与音量调整功能无关。
通过 Google Gemini 实现二进制验证支持:
在模型训练过程中,为了确保生成的函数调用参数是完整和准确的,研究团队引入了二进制验证机制。这个机制使用Google Gemini API来评估生成的函数调用是否正确。如果发现错误,如缺少参数、参数类型不正确或误解了查询意图,Google Gemini会重新生成函数调用参数,直到满足准确性要求。这个过程有助于提高模型训练数据的质量,从而提升模型的性能。
通过这三个阶段,研究团队能够创建一个既包含大量相关查询和正确函数调用参数,又包含一定数量不相关查询的数据集,同时通过二进制验证机制确保数据的准确性。这样的数据集有助于训练出一个既能够准确理解用户指令,又能够在面对不相关或模糊查询时保持鲁棒性的模型。
3. 模型微调:
为了使模型理解这些特殊标记的含义,研究者将函数描述纳入训练数据集中。通过设计一个能够适应三种不同响应风格的提示模板,模型学会了如何将函数描述映射到特定的标记上。
单个函数调用模板:这种模板用于处理单个、明确的用户请求,其中模型需要调用一个特定的函数来完成任务。例如,用户可能会问:“如何设置闹钟?”模型将使用这个模板来理解请求,并生成一个调用setAlarm()函数的标记化响应。
并行函数调用模板:这种模板用于处理需要同时执行多个函数的情况。在这种情况下,模型需要学会如何组织多个函数调用,并将它们放在一起执行。例如,用户可能要求:“明天早上7点设置闹钟,并开启勿扰模式。”模型将使用这个模板来生成两个函数调用:setAlarm()和enableDoNotDisturb()。
嵌套函数调用模板:这种模板用于处理更为复杂的请求,其中包含层次结构或顺序执行的要求。模型需要理解如何按顺序或按条件执行一系列函数调用。例如,用户可能会说:“如果明天下雨,就提醒我带伞。”模型将使用嵌套模板来生成一个条件函数调用,如checkWeather()后跟 remindToBringUmbrella()(如果条件满足)。
通过这些模板,Octopus模型学会了如何根据不同的查询和上下文生成准确的函数调用。这些模板帮助模型理解函数描述与实际调用之间的关系,从而提高了模型在实际应用中的准确性和可靠性。
4. 模型训练方法:
Octopus模型采用了两种训练方法:全模型训练和LoRA(Low-Rank Adaptation)训练。全模型训练使用AdamW优化器,而LoRA训练则在特定的模型模块上应用低秩矩阵分解技术,以减少计算资源的需求。
5. 特殊标记的权重调整:
由于特殊标记在预训练数据集中不存在,因此在训练过程中引入了不平衡的数据集挑战。为了解决这个问题,研究者采用了加权交叉熵损失函数,为特殊标记分配了更高的权重,以促进模型的收敛。
总结
所以说,为什么Octopus模型在性能上比GPT-4更快。
首先,Octopus模型是一个为在设备上运行而优化的模型,它只拥有20亿参数。同时,在设计时减少了上下文长度的需求,这意味着模型在进行预测时不需要处理和记忆大量的上下文信息,从而加快了处理速度。
其次,Octopus模型使用了精心设计的训练数据集,这些数据集包含了针对特定功能调用的样本。这种针对性的训练有助于模型更快地学习和适应特定的任务。
最后,Octopus模型专门针对自动工作流程中的功能调用进行了优化。它通过特殊的标记化方法和微调,使得模型能够更直接、更高效地理解和执行特定的API调用,减少了在处理和生成响应时所需的计算资源。
创建了交流讨论的学习群欢迎扫码加入~
原文作者:Tim在路上;如有侵权,请联系管理员删除。

