关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
更快更全面获取大数据技术博客

在自然环境中,数据的产生原本就是流式的。无论是来自 Web 服务器的事件数据,证券交易所的交易数据,还是来自工厂车间机器上的传感器数据,其数据都是流式的。但是当你分析数据时,可以围绕 有界流(bounded)或 无界流(unbounded)两种模型来组织处理数据,当然,选择不同的模型,程序的执行和处理方式也都会不同。
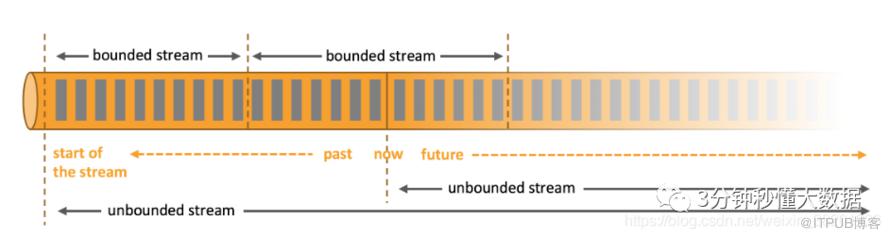
流处理 是无界数据流处理的范例。至少理论上来说,它的数据输入永远不会结束,因此程序必须持续不断地对到达的数据进行处理。
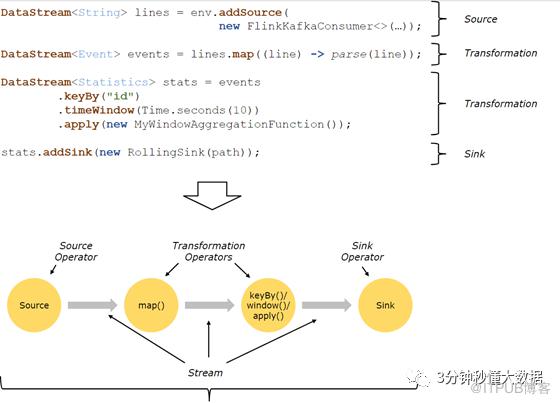
Flink 应用程序结构就是如上图所示:
Source: 数据源。Flink 在流处理和批处理上的 source 大概有 4 类:
基于本地集合的 source
基于文件的 source
基于网络套接字的 source
自定义的 source
自定义 的 source 常见的有 Apache kafka、RabbitMQ 等,当然你也可以定义自己的 sourc e。
Transformation:数据转换的各种操作。包含:
Map / FlatMap / Filter / KeyBy / Reduce / Fold / Aggregations / Window / WindowAll / Union / Window join / Split / Select等操作,操作很多,可以将数据转换计算成你想要的数据。
写入文件、打印出来
写入 socket
自定义的 sink 。
自定义的 sink 常见的有 Apache kafka、RabbitMQ、MySQL、ElasticSearch、Apa che Cassandra、Hadoop FileSystem 等,同理你也可以定义自己的 sink。

Flink程序本质上是并行的和分布式的,在执行过程中,一个流(stream)包含一个或多个流分区,而每一个operator包含一个或多个operator子任务。操作子任务间彼此独立,在不同的线程中执行,甚至是在不同的机器或不同的容器上。operator子任务的数量是这一特定operator的并行度。相同程序中的不同operator有不同级别的并行度。


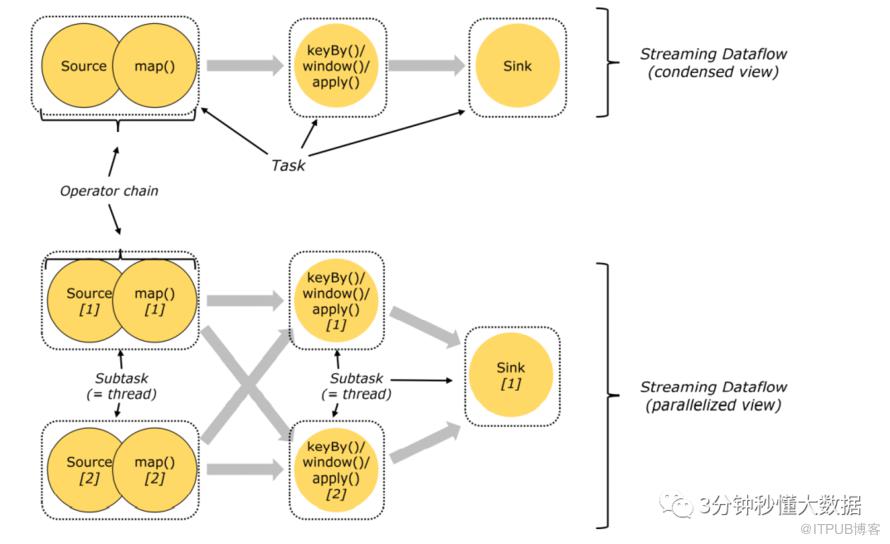

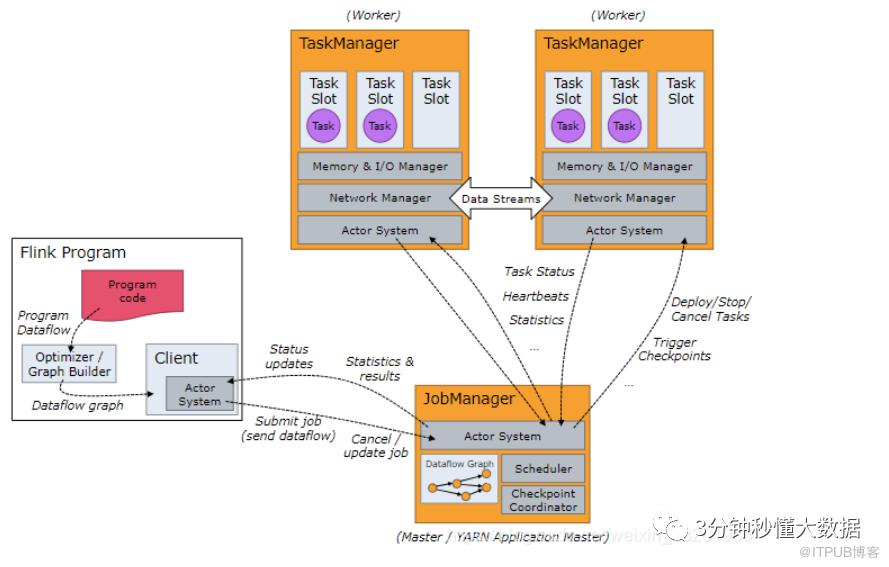
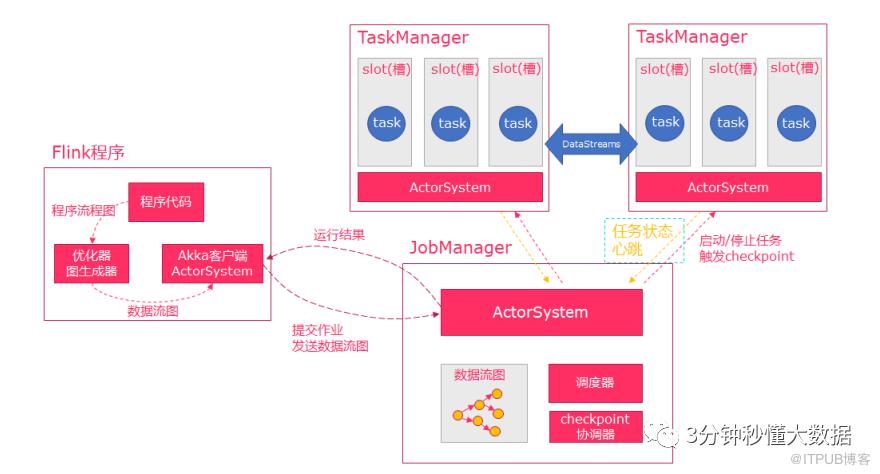
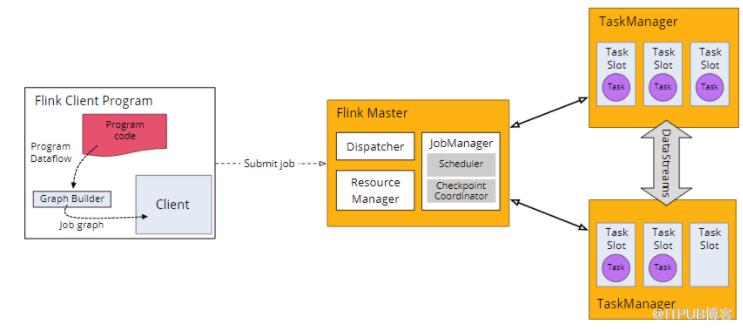
以上三个图是一个图,Flink执行流程如下:
1. 当Flink执行executor会自动根据程序代码生成DAG数据流图 ,即 Jobgraph;
2. ActorSystem创建Actor将数据流图发送给JobManager中的Actor;
3. JobManager会不断接收TaskManager的心跳消息,从而可以获取到有效的TaskManager;
4. JobManager通过调度器在TaskManager中调度执行Task(在Flink中,最小的调度单元就是task,对应就是一个线程) ;
• Job Client
– 主要职责是提交任务, 提交后可以结束进程, 也可以等待结果返回 ;
– Job Client 不是 Flink 程序执行的内部部分,但它是任务执行的起点;
• JobManager
– 主要职责是调度工作并协调任务做检查点;
– 集群中至少要有一个 master,master 负责调度 task,协调checkpoints 和 容错;
– 高可用设置的话可以有多个 master,但要保证一个是 leader, 其他是stand by;
– Job Manager 包含 Actor System、Scheduler、CheckPoint三个重要的组件 ;
• TaskManager
– 主要职责是从JobManager处接收任务, 并部署和启动任务, 接收上游的数 据并处理
– Task Manager 是在 JVM 中的一个或多个线程中执行任务的工作节点。
– TaskManager在创建之初就设置好了Slot, 每个Slot可以执行一个任务。

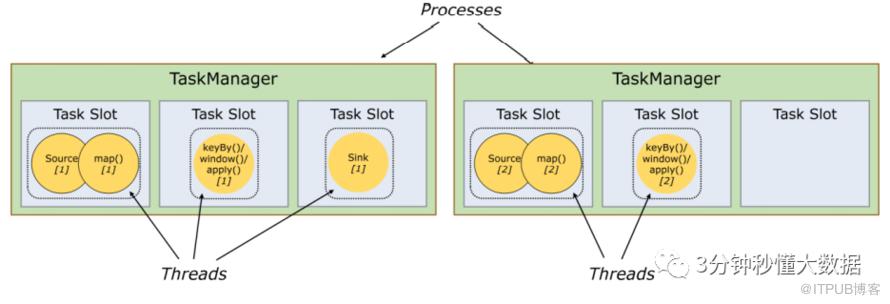
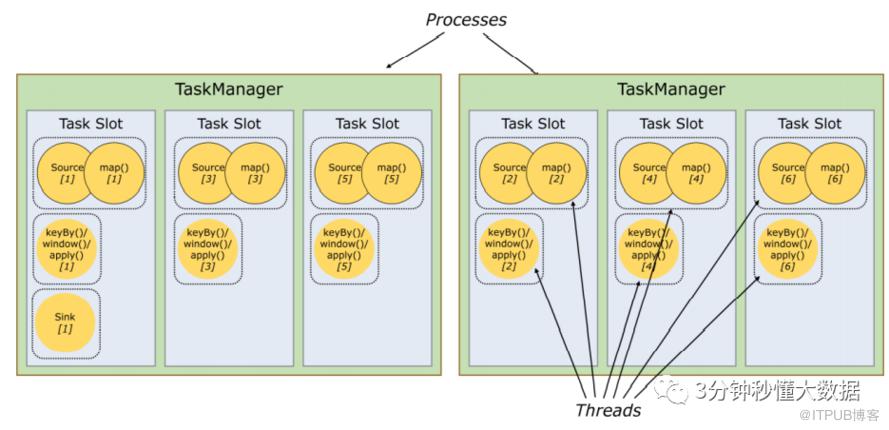
每个TaskManager是一个JVM的进程, 可以在不同的线程中执行一个或多个子任务。为了控制一个worker能接收多少个task。worker通过task slot来进行控制(一个worker
至少有一个task slot)。
1、任务槽
每个task slot表示TaskManager拥有资源的一个固定大小的子集。
一般来说:我们分配槽的个数都是和CPU的核数相等,比如8核,那么就分配8个槽。
Flink将进程的内存划分到多个slot中。
图中有2个TaskManager,每个TaskManager有3个slot,每个slot占有1/3的内存。
总结:task slot的个数代表TaskManager可以并行执行的task数。
2、槽共享
默认情况下,Flink允许子任务共享插槽,即使它们是不同任务的子任务,只要它们来自同一个作业。结果是一个槽可以保存作业的整个管道。允许插槽共享有两个主要好处:
• 有了任务槽共享,可以将基本并行度(base parallelism)从2提升到6。提高了分槽资源的利用率。同时它还可以保障TaskManager给subtask的分配的slot方案更加公平。
以上就是Flink 运行架构的讲解内容!觉得好的,点赞,在看,分享三连击,谢谢!!!

End
找各类大数据技术文章和面经,就来
<3分钟秒懂大数据>
随时更新互联网大数据组件内容
专为学习者提供技术博文
快和身边的小伙伴一起关注我们吧!
作者简介:逆流而上Mr李,秋招7offer,CSDN博客:https://blog.csdn.net/weixin_38201936
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
