关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
获取大数据技术、面经、内推信息
上一篇文章 Spark-SQL解析原来如此简单 讲到了Spark-SQL通过Antlr4生成未解析的LogicalPlan。此时的LogicalPlan是Unresolve的,需要通过Catalog来绑定UnresolvedRelation
和UnresolvedAttribute,生成解析后的LogicalPlan。
元数据(Catalog)

在Spark-SQL中,Catalog主要用于各种函数资源信息和元数据信息(数据库、数据表、数据视图、数据分区与函数等)的统一管理。Spark-SQL中的Catalog体系实现以SessionCatalog为主体,用户通过SparkSession来访问,SparkSession和SessionCatalog是一对一的关系。SessionCatalog的构造参数除了包括Spark-SQL和
Hadoop的配置外,还涉及以下四个方面的内容:
class SessionCatalog(val externalCatalog: ExternalCatalog,//外部系统CatalogglobalTempViewManager: GlobalTempViewManager,//全局临时视图管理functionRegistry: FunctionRegistry,//函数注册conf: SQLConf,//SQL配置hadoopConf: Configuration,//hadoop 配置parser: ParserInterface,functionResourceLoader: FunctionResourceLoader)//函数资源加载器
一、GlobalTempViewManager(全局临时视图管理)
对应DataFrame中的createGlobalTempView方法。GlobalTempViewManager内部通过viewDefinitions来保存视图。可进行创建、更新、删除和重命名等操作。其中viewDefinitions的key是视图名称,value是视图对应的LogicalPlan(在创建视图中生成)。
private val viewDefinitions = new mutable.HashMap[String, LogicalPlan]二、FunctionResourceLoader(函数资源加载器)
Spark-SQL中除了内置的函数外,还支持用户自定义的函数和Hive的函数,这些函数可以通过外部jar包提供,FunctionResourceLoader的作用就是加载这些函数 资源。
三、FunctionRegistry(函数注册)
用来实现对函数的注册、查找和删除,Spark-SQL中的实现类是SimpleFunctionRegistry,使用functionBuilders来保存注册的函数。key为函数名,value为函数的 描述信息。functionBuilders除了可以注册自定义函数外,还注册了很多已经定义好的内置函数。
private val functionBuilders =new mutable.HashMap[FunctionIdentifier, (ExpressionInfo, FunctionBuilder)]//保存注册的函数
object FunctionRegistry {val expressions: Map[String, (ExpressionInfo, FunctionBuilder)] = Map(expression[Sum]("sum"),//求和expression[TimeWindow]("window"),//窗口window(start, 7day, 1day)// jsonexpression[StructsToJson]("to_json"),//结构转jsonexpression[JsonToStructs]("from_json"),//json转结构)expressions.foreach {case (name, (info, builder)) => fr.registerFunction(FunctionIdentifier(name), info, builder)//注册}}
四、ExternalCatalog(外部系统Catalog)

总体来看,SessionCatalog用来管理所有表相关的元数据,包括数据库、数据表、数据视图、数据分区与函数等,其内部还用tempViews管理临时表信息,以及currentDb来表示当前操作的数据库名称。
protected val tempViews = new mutable.HashMap[String, LogicalPlan]//临时表信息protected var currentDb: String = formatDatabaseName(DEFAULT_DATABASE)//当前数据库名称
规则(Catalog)

Rule在对Unrelolve LogicalPlan逻辑算子树的操作(如绑定、优化等)中扮演非常重要的角色,在这些操作中,经常需要对逻辑算子树中某个节点进行改写,或 者对树结构进行转换。Rule提供了apply方法供子类复写,让子类可以实现特定的处理逻辑。
abstract class Rule[TreeType <: TreeNode[_]] extends Logging {val ruleName: String = {val className = getClass.getNameif (className endsWith "$") className.dropRight(1) else className}def apply(plan: TreeType): TreeType//供子类实现规则逻辑}
RuleExecutor是Rule的驱动程序,对Unrelolve LogicalPlan的绑定、优化以及后续物理算子的生成,都继承了RuleExecutor。其重要的内部成员如下:
abstract class Strategy { def maxIterations: Int }//策略case object Once extends Strategy { val maxIterations = 1 }//迭代一次case class FixedPoint(maxIterations: Int) extends Strategy//迭代maxIterations次protected case class Batch(name: String, strategy: Strategy, rules: Rule[TreeType]*)//一套规则protected def batches: Seq[Batch]//定义规则执行顺序,一套规则的集合
Strategy:策略,用于规定规则迭代执行次数,抽象类,定义了类型为int名字为maxIterations的属性;
Once:从Strategy继承,maxIterations=1,表示只迭代执 行一次规则;
FixedPoint:从Strategy继承,表示执行maxIterations次规则;
Batch:定义一套规则,包含批次名、策略、包含的规则;
batches:批次的集合, 类型为Seq[Batch],定义了规则的执行顺序,具体内容由子类去定义。
execute方法:按照batches顺序和Batch内的rules顺序,对传入的plan里的节点进行迭代处 理,具体处理逻辑由Rule子类去实现。
def execute(plan: TreeType): TreeType = {var curPlan = planbatches.foreach { batch =>val batchStartPlan = curPlanvar iteration = 1var lastPlan = curPlanvar continue = truewhile (continue) {curPlan = batch.rules.foldLeft(curPlan) {//遍历规则执行case (plan, rule) =>val result = rule(plan)result}iteration += 1if (iteration > batch.strategy.maxIterations) {continue = false}lastPlan = curPlan}}curPlan}
分析(Analyzer)

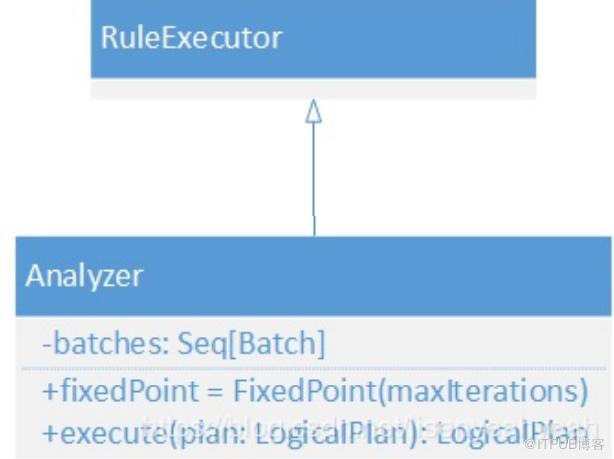
lazy val batches: Seq[Batch] = Seq(Batch("Hints", fixedPoint,new ResolveHints.ResolveBroadcastHints(conf),ResolveHints.RemoveAllHints),Batch("Simple Sanity Check", Once,LookupFunctions),Batch("Resolution", fixedPoint,ResolveRelations ::ResolveReferences ::ResolveAggAliasInGroupBy ::ResolveFunctions ::ResolveAggregateFunctions ::......
以上就是Spark - SQL 绑定第二阶段的所有内容!觉得好的,点赞,在看,分享三连击,谢谢!!!

End
往期精彩
最近整理了一份计算机类的书籍,包含python、java、大数据、人工智能等,种类特别齐全,
获取方式:关注公众号:3分钟秒懂大数据,回复:福利,就可以获得这份超级大礼!,小伙伴们快来领取吧。


点个在看你最好看
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
