关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
获取AI大数据技术、面经、内推信息
(2)Flink状态类型包含哪些?
(3)Flink 广播状态模式了解不?
(4)Flink状态接口包含哪些?
(5)Flink状态如何存储?
(6)Flink状态如何持久化?
(7)Flink状态过期后,如何清理?
(8)状态重分布什么意思?
我们可以看到,一个状态原理,就可以被问出这么多问题和知识点,所以,现在阿周就带你从头到尾,彻底搞懂Flink 状态机制,从此再也不怂面试官!
目录

01
AUTUMN
通俗理解什么是状态?
状态被称作state,在Flink中,是用来 保存 中间的 计算结果 或者 缓存数据。
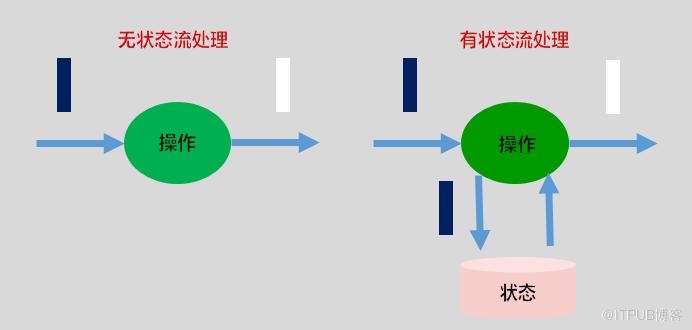
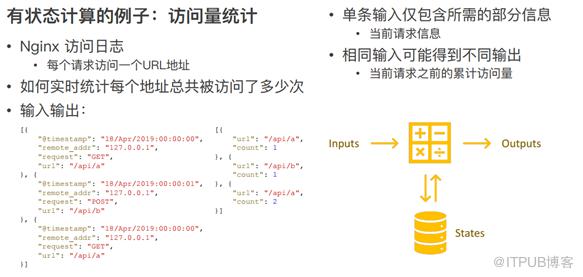
根据状态是否需要保存中间结果,分为 无状态计算 和 有状态计算。
对于流计算而言,事件持续产生,如果每次计算相互独立,不依赖上下游的事件,则相同输入,可以得到相同输出,是无状态计算。
如果计算需要依赖于之前或者后续事件,则被称为有状态计算。
02
AUTUMN
Flink状态类型包含哪些?
(1) 按照由 Flink管理 还是 用户管理,状态可以分为 原始状态(Raw State)和 托管状态(ManagedState)
原始状态(Raw State):由用户自行进行管理。
两者区别:
1. 从状态管理方式的方式来说,Managed State 由Flink Runtime 管理,自动存储,自动恢复,在内存管理上有优化;而 Raw State 需要用户自己管理,需要自己序列化,Flink 不知道 State 中存入的数据是什么结构,只有用户自己知道,需要最终序列化为可存储的数据结构。
2. 从状态数据结构来说,Managed State 支持已知的数据结构,如Value、List、Map等。而 Raw State 只支持 字节 数组,所有状态都要转换为二进制字节数组才可以。
3. 从推荐使用场景来说,Managed State 大多数情况下均可使用,而Raw State 是当 Managed State 不够用时,比如需要自定义Operator 时,才会使用 Raw State。在实际生产过程中,只推荐使用 Managed State 。
(2)State 按照是否有 key 划分为 KeyedState 和 OperatorState 两种。
keyedState特点:
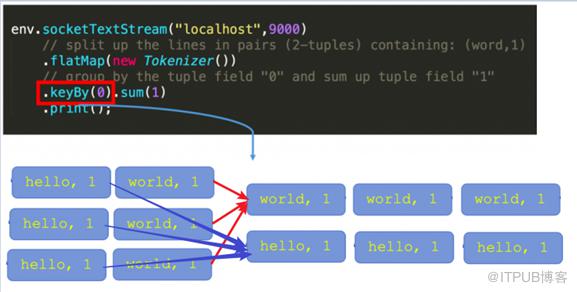
1. 只能用在keyedStream上的算子中,状态跟特定的key绑定。
2. keyStream流上的每一个key 对应一个state 对象。若一个operator 实例处理多个key,访问相应的多个State,可对应多个state。
3. keyedState 保存在StateBackend中
4. 通过RuntimeContext访问,实现Rich Function接口。
5. 支持多种数据结构:ValueState、ListState、ReducingState、AggregatingState、MapState.
OperatorState特点:
1. 可以用于所有算子,但整个算子只对应一个state。
2.并发改变时有多种重新分配的方式可选:均匀分配;
3. 实现CheckpointedFunction或者 ListCheckpointed 接口。
4. 目前只支持 ListState数据结构。

这里的fromElements会调用FromElementsFunction的类,其中就使用了类型为List state 的 operator state
03
AUTUMN
Flink广播状态了解吗?
Flink中,广播状态中叫作 BroadcastState。 在广播状态模式中使用。所谓广播状态模式, 就是来自一个流的数据需要被广播到所有下游任务,在算子本地存储,在处理另一个流的时候依赖于广播的数据.下面以一个示例来说明广播状态模式。
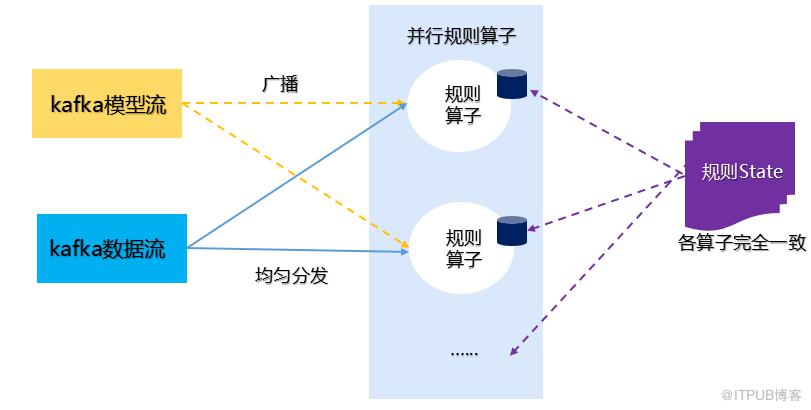
上图这个示例包含两个流,一个为kafka模型流,该模型是通过机器学习或者深度学习训练得到的模型,将该模型通过广播,发送给下游所有规则算子,规则算子将规则缓存到Flink的本地内存中,另一个为 Kafka数据流,用来接收测试集,该测试集依赖于模型流中的模型,通过模型完成测试集的推理任务。
广播状态(State)必须是MapState类型,广播状态模式需要使用广播函数进行处理,广播函数提供了处理广播数据流和普通数据流的接口。
04
AUTUMN
Flink状态接口包含哪些?
在Flink中使用状态,包含两种状态接口:
(1)状态操作接口:使用状态对象本身存储,写入、更新数据。
(2)状态访问接口:从StateBackend获取状态对象本身。
状态操作接口
Flink 中的 状态操作接口 面向两类用户,即 应用开发者 和 Flink 框架本身。 所有Flink设计了两套接口
1、面向开发者State接口
面向开发的State接口只提供了对State中数据的增删改基本操作接口,用户无法访问状态的其他运行时所需要的信息。接口体系如下图:
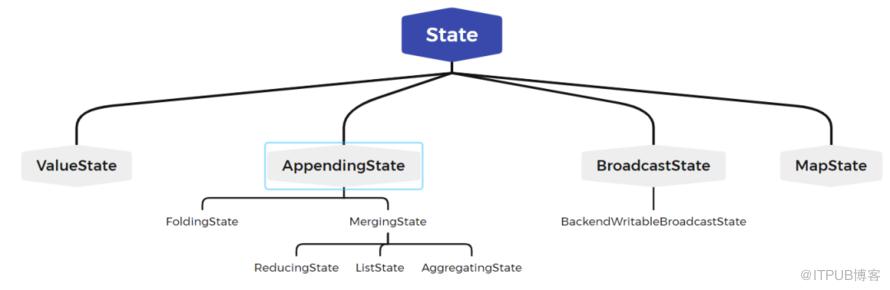
面向开发者的 State 接口体系
2、面向内部State接口
内部State 接口 是给 Flink 框架使用,提供更多的State方法,可以根据需要灵活扩展。除了对State中数据的访问之外,还提供内部运行时信息,如State中数据的序列化器,命名空间(namespace)、命名空间的序列化器、命名空间合并的接口。内部State接口命名方式为InternalxxxState。
状态访问接口
有了状态之后,开发者自定义UDF时,应该如何访问状态?
状态会被保存在StateBackend中,但StateBackend 又包含不同的类型。所有Flink中抽象了两个状态访问接口:OperatorStateStore 和 KeyedStateStore,用户在编写UDF时,就无须考虑到底是使用哪种 StateBackend类型接口。
OperatorStateStore 接口原理:
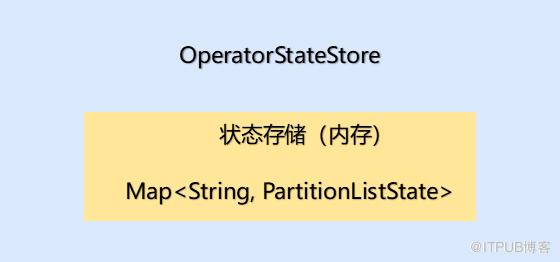
OperatorState数据以Map形式保存在内存中,并没有使用RocksDBStateBackend和HeapKeyedStateBackend。
KeyedStateStore 接口原理:
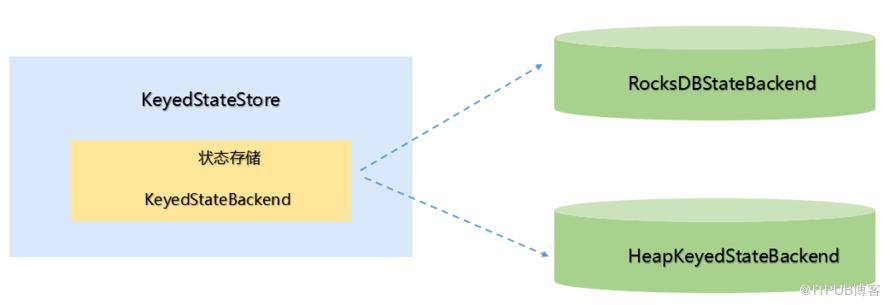
keyedStateStore数据使用RocksDBStateBackend或者HeapKeyedStateBackend来存储,KeyedStateStore中创建、获取状态都交给了具体的StateBackend来处理,KeyedStateStore本身更像是一个代理。

End
最近整理了一份计算机类的书籍,包含python、java、大数据、人工智能、算法等,种类特别齐全。
获取方式:关注公众号:3分钟秒懂大数据,回复:福利,就可以获得这份超级大礼!,小伙伴们快来领取吧。

点个在看你最好看
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
