关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
获取AI大数据技术、面经、内推信息
在上篇文章:硬核!10分钟解读Flink 状态原理(1),我们分享了Flink的状态、状态类型、广播状态、状态的接口等知识点,接下来,我们重点看看,Flink是如何存储状态,以及状态如何持久化?过期如何清理等知识点。
05
AUTUMN
Flink状态如何存储?
在Flink中, 状态存储被叫做 StateBackend , 它具备两种能力:
(1)在计算过程中提供访问State能力,开发者在编写业务逻辑中能够使用StateBackend的接口读写数据。
(2)能够将State持久化到外部存储,提供容错能力。
Flink状态提供三种存储方式:
(1)内存:MemoryStateBackend,适用于验证、测试、不推荐生产使用。
(2)文件:FSStateBackend,适用于长周期大规模的数据。
(3)RocksDB : RocksDBStateBackend,适用于长周期大规模的数据。
上面提到的 StateBackend是面向用户的,在Flink内部3种 State 的关系如下图:
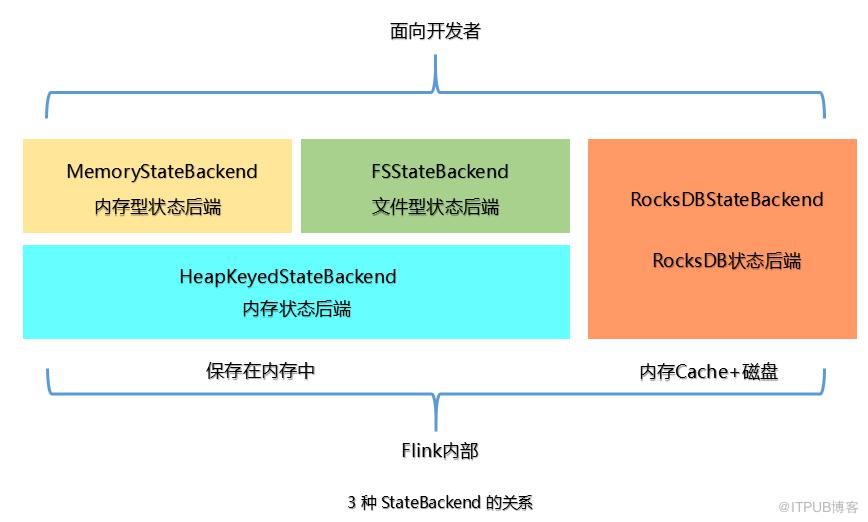
在运行时,MemoryStateBackend 和 FSStateBackend 本地的 State 都保存在TaskManager的内存中,所以其底层都依赖于HeapKeyedStateBackend。HeapKeyedStateBackend面向Flink 引擎内部,使用者无须感知。
1、内存型 StateBackend
MemoryStateBackend,运行时所需的State数据全部保存在 TaskManager JVM堆上内存中, KV类型的State、窗口算子的State 使用HashTable 来保存数据、触发器等。执行检查点的时候,会把 State 的快照数据保存到JobManager进程的内存中。
MemoryStateBackend 可以使用异步的方式进行快照,(也可以同步),推荐异步,避免阻塞算子处理数据。
基于内存的 Stateßackend 在生产环境下不建议使用,可以在本地开发调试测试 。
注意点如下 :
1) State 存储在 JobManager 的内存中.受限于 JobManager的内存大小。
2) 每个 State默认5MB,可通过 MemoryStateBackend 构造函数调整
3) 每个 Stale 不能超过 Akka Frame 大小。
2、文件型 StateBackend
FSStateBackend,运行时所需的State数据全部保存在 TaskManager 的内存中, 执行检查点的时候,会把 State 的快照数据保存到配置的文件系统中。
可以是分布式或者本地文件系统,路径如:
HDFS路径:“hdfs://namenode:40010/flink/checkpoints”
本地路径:“file:///data/flink/checkpoints”。
FSStateBackend 适用于处理大状态、长窗口、或者大键值状态的有状态处理任务。
注意点如下 :
1) State 数据首先被存在 TaskManager 的内存中。
2) State大小不能超过TM内存。
3) TM异步将State数据写入外部存储。
MemoryStateBackend 和FSStateBackend 都依赖于HeapKeyedStateBackend,HeapKeyedStateBackend 使用 State存储数据。
3、RocksDBStateBackend
RocksDBStateBackend 跟内存型和文件型都不同 。
RocksDBStateBackend 使用嵌入式的本地数据库 RocksDB 将流计算数据状态存储在本地磁盘中,不会受限于TaskManager 的内存大小,在执行检查点的时候,再将整个 RocksDB 中保存的State数据全量或者增量持久化到配置的文件系统中,
在 JobManager 内存中会存储少量的检查点元数据。RocksDB克服了State受内存限制的问题,同时又能够持久化到远端文件系统中,比较适合在生产中使用。
缺点:
RocksDBStateBackend 相比基于内存的StateBackend,访问State的成本高很多,可能导致数据流的吞吐量剧烈下降,甚至可能降低为原来的 1/10。
适用场景
1)最适合用于处理大状态、长窗口,或大键值状态的有状态处理任务。
2)RocksDBStateBackend 非常适合用于高可用方案。
3) RocksDBStateBackend 是目前唯一支持增量检查点的后端。 增量检查点非常适用于超 大状态的场景。
注意点
1)总 State 大小仅限于磁盘大小,不受内存限制
2)RocksDBStateBackend 也需要配置外部文件系统,集中保存State 。
3)RocksDB的 JNI API 基于 byte 数组,单 key 和单 Value 的大小不能超过 8 字节
4)对于使用具有合并操作状态的应用程序,如ListState ,随着时间可能会累积到超过 2*31次方字节大小,这将会导致在接下来的查询中失败。
06
AUTUMN
Flink状态如何持久化?
首选,Flink的状态最终都要持久化到第三方存储中,确保集群故障或者作业挂掉后能够恢复。
1、全量持久化策略
每次将全量的State写入到状态存储中(HDFS)。内存型、文件型、RocksDB类型的StataBackend 都支持全量持久化策略。
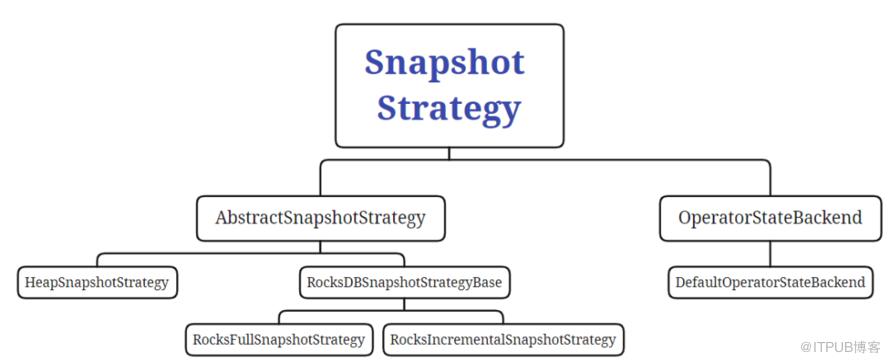
快照保存策略类体系
在执行持久化策略的时候,使用异步机制,每个算子启动1个独立的线程,将自身的状态写入分布式存储可靠存储中。在做持久化的过程中,状态可能会被持续修改,
基于内存的状态后端使用 CopyOnWriteStateTable 来保证线程安全,RocksDBStateBackend则使用RocksDB的快照机制,使用快照来保证线程安全。
2、增量持久化策略
增量持久化就是每次持久化增量的State,只有RocksDBStateBackend 支持增量持久化。
Flink 增量式的检查点以 RocksDB为基础, RocksDB是一个基于LSM-Tree的KV存储。新的数据保存在内存中, 称为memtable。如果Key相同,后到的数据将覆盖之前的数据,一旦memtable写满了,RocksDB就会将数据压缩并写入磁盘。memtable的数据持久化到磁盘后,就变成了不可变的 sstable。
因为 sstable 是不可变的,Flink对比前一个检查点创建和删除的RocksDB sstable 文件就可以计算出状态有哪些发生改变。
为了确保 sstable 是不可变的,Flink 会在RocksDB 触发刷新操作,强制将 memtable 刷新到磁盘上 。在Flink 执行检查点时,会将新的sstable 持久化到HDFS中,同时保留引用。这个过程中 Flink 并不会持久化本地所有的sstable,因为本地的一部分历史sstable 在之前的检查点中已经持久化到存储中了,只需增加对 sstable文件的引用次数就可以。
RocksDB会在后台合并 sstable 并删除其中重复的数据。然后在RocksDB删除原来的 sstable,替换成新合成的 sstable.。新的 sstable 包含了被删除的 sstable中的信息,通过合并历史的sstable会合并成一个新的 sstable,并删除这些历史sstable. 可以减少检查点的历史文件,避免大量小文件的产生。
07
AUTUMN
Flink状态过期后如何清理?
1、DataStream中状态过期
过期时间:超过多长时间未访问,视为State过期,类似于缓存。
过期时间更新策略:创建和写时更新、读取和写时更新。
State可见性:未清理可用,超时则不可用。
2、Flink SQL中状态过期
Flink SQL 一般在流Join、聚合类场景使用State,如果State不定时清理,则导致State过多,内存溢出。清理策略配置如下:
StreamQueryConfig qConfig = ...//设置过期时间为 min = 12小时 ,max = 24小时qConfig.withIdleStateRetentionTime(Time.hours(12),Time.hours(24));

End
最近整理了一份计算机类的书籍,包含python、java、大数据、人工智能、算法等,种类特别齐全。
获取方式:关注公众号:3分钟秒懂大数据,回复:福利,就可以获得这份超级大礼!,小伙伴们快来领取吧。

点个在看你最好看
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
