关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
获取AI大数据技术、面经、内推信息
Hello 各位小伙伴:
前面我们一直在分享关于大数据的技术知识,但同时呢,阿周我也是一名工程算法人员,今天呢,我们分享一个使用深度学习Tensorflow进行模型训练的知识点,都是在工作中实际操作的干货呦,话不多说,直接开干!

LOVE
1、导包,查看Tensorflow版本

from __future__ import absolute_import, division, print_functionimport numpy as npimport pandas as pdimport tensorflow as tffrom tensorflow import feature_columnfrom tensorflow.keras import layers,Sequentialfrom tensorflow.keras.layers import DenseFeatures,Densefrom sklearn.model_selection import train_test_splitprint(tf.__version__) # 2.4.1

LOVE
2、使用Pandas加载CSV文件

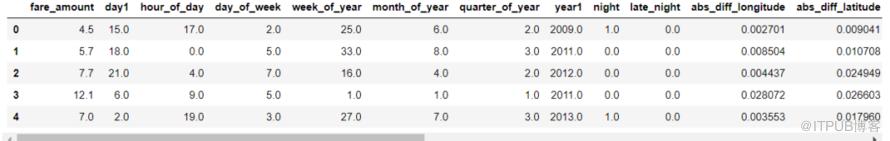
通过read.csv读取文件,然后通过shape方法查看行列,通过head方法查看数据:
dataframe = pd.read_csv('/root/anaconda3/envs/rlink/lyz/tensorflow_incremental_training/test_data.csv')print(dataframe.shape) # (250, 20)dataframe.head(5)

LOVE
3、通过sklearn - train_test_split划分数据集和测试集

通过train_test_split 将数据集按照6:2:2的比例划分成训练集、验证集、测试集数据,但是划分完的数据格式依旧还是pandas.core.frame.DataFrame 格式。
train, test = train_test_split(dataframe, test_size=0.2)train, val = train_test_split(train, test_size=0.2)print(len(train), '训练数据') # 160 训练数据print(len(val), '验证数据 ') # 40 验证数据print(len(test), '测试数据') # 50 测试数据print(type(train)) # <class 'pandas.core.frame.DataFrame'>

LOVE
4、将dataframe格式转为tensorflow能识别的 dataset格式

def df_to_dataset(dataframe, shuffle=True, batch_size=32):dataframe = dataframe.copy()labels = dataframe.pop('fare_amount') #label为目标值字段,可以根据要求更换列名ds = tf.data.Dataset.from_tensor_slices((dict(dataframe), labels))if shuffle:ds = ds.shuffle(buffer_size=len(dataframe))ds = ds.batch(batch_size)return dsbatch_size = 5train_ds = df_to_dataset(train, batch_size=batch_size)val_ds = df_to_dataset(val, shuffle=False, batch_size=batch_size)test_ds = df_to_dataset(test, shuffle=False, batch_size=batch_size)# <class 'tensorflow.python.data.ops.dataset_ops.BatchDataset'>通过自定义方法,我们可以看到数据变为dataset_ops.BatchDataset方式。

LOVE
5 、从CSV中的列映射到用于训练模型的输入要素。

for feature_batch, label_batch in train_ds.take(1):feature = list(feature_batch.keys())print('feature list:', feature)print('A batch of targets:', label_batch )# 可以打印出来,看看特征值如下:# feature list: ['day1', 'hour_of_day', 'day_of_week', 'week_of_year', 'month_of_year', 'quarter_of_year', 'year1', 'night', 'late_night', 'abs_diff_longitude', 'abs_diff_latitude', 'pickup_distance_jfk', 'dropoff_distance_jfk', 'pickup_distance_ewr', 'dropoff_distance_ewr', 'pickup_distance_lgr', 'pickup_distance_downtown', 'dropoff_distance_downtown', 'manhattan']

LOVE
6、 构建Dense类型输入层

feature_columns = []# 遍历特征列表featurefor header in feature:feature_columns.append(feature_column.numeric_column(header))feature_layer = DenseFeatures(feature_columns)print(feature_layer(next(iter(train_ds))[0]).numpy())#print(type(feature_column.numeric_column(header))) #可以看到转换类型#<class 'tensorflow.python.feature_column.feature_column_v2.NumericColumn'>print(type(feature_layer))#<class 'tensorflow.python.keras.feature_column.dense_features_v2.DenseFeatures'>

LOVE
7、使用keras进行模型训练

model = Sequential([feature_layer,Dense(128, activation='relu'),Dense(128, activation='relu'),Dense(1, activation='sigmoid')])model.compile(optimizer='adam',loss='binary_crossentropy',metrics=['accuracy'])model.fit(train_ds, validation_data=val_ds,epochs=5)
通过上述完整过程,就可以得到一个训练的深度学习模型。

End
最近整理了一份计算机类的书籍,包含python、java、大数据、人工智能、算法等,种类特别齐全。
获取方式:关注公众号:3分钟秒懂大数据,回复:福利,就可以获得这份超级大礼!,小伙伴们快来领取吧。

点个在看你最好看
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
