标注并标星 3分钟秒懂大数据
每天1次,打卡阅读
获取AI大数据技术、面经、内推信息
在通过Flink设计评估策略时,其中涉及到一个机器学习中的AUC计算问题,就百度搜了一下,发现概念还挺复杂,于是详细了解了一下,写了下面的这篇文章。
要想了解什么是AUC,首先得了解什么是混淆矩阵和ROC曲线。
1
混淆矩阵
那什么是混淆矩阵呢? 其实就是把所有类别的预测结果与真实结果按类别放置到了同一个表里,形成一个矩阵,在这个矩阵中我们可以清楚看到每个类别正确识别的数量和错误识别的数量。
混淆矩阵中包含几个二分类问题中常用的概念:True Positive, False Positive, True Negative, False Negative。它们是根据真实类别与预测类别的组合来区分的。
假设有一批test样本,这些样本只有两种类别:正例和反例。机器学习算法预测类别如下图(左半部分预测类别为正例,右半部分预测类别为反例),而样本中真实的正例类别在上半部分,下半部分为真实的反例。
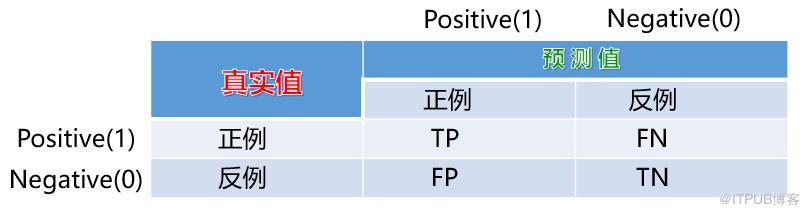
TP:真实类别为1,且预测结果为1的样本个数,预测正确
FP:真实类别为0,且预测结果为1的样本个数,预测错误
TN:真实类别为0,且预测结果为0的样本个数,预测正确
FN:预测类别是1,且预测结果为0的样本个数,预测错误
2
ROC曲线
有混淆矩阵可以计算得到 ROC曲线的关键参数:TPR(真正率)和 FPR(假正率)。
计算公式如下:


TPR表示:将正例预测为正例的比例,FPR表示:将负例预测成正例的比例
ROC曲线以 TPR为Y轴,FPR为X轴,画出如下曲线图:

当TPR越趋近于1,证明真的被预测成真的概率越高
当FPR越趋近于1,证明假的被预测成真的的概率越高
而AUC是计算ROC曲线下的面经,要想面积大,就得TPR越大,FPR越小。
Sklearn给出了一个计算ROC的例子。
y = np.array([0, 0, 1, 1])scores = np.array([0.1, 0.4, 0.35, 0.8])fpr, tpr, thresholds = metrics.roc_curve(y, scores, pos_label=2)
通过计算,得到的结果(TPR, FPR, 截断点)为:
fpr = array([ 0. , 0.5, 0.5, 1. ])tpr = array([ 0.5, 0.5, 1. , 1. ])thresholds = array([ 0.8 , 0.4 , 0.35, 0.1 ])#截断点
3
TPR,FPR 详细计算过程
上例给出的数据如下:
y = np.array([0, 0, 1, 1])scores = np.array([0.1, 0.4, 0.35, 0.8])fpr, tpr, thresholds = metrics.roc_curve(y, scores, pos_label=2)
用这个数据,计算TPR,FPR的过程是怎么样的呢?
1. 分析数据
y 是一个一维数组(样本的真实分类)。数组值表示类别(一共有两类,0和1)y_true = [0, 0, 1, 1]
score 即各个样本属于正例的概率。
2. 针对score,将数据排序
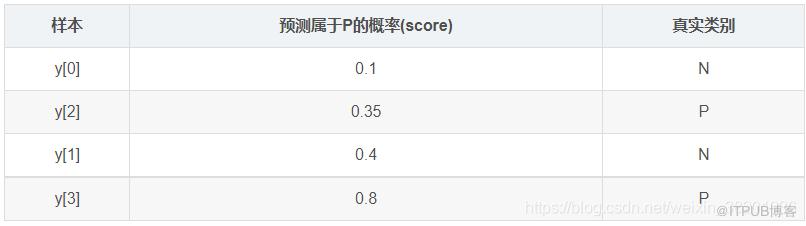
3. 将截断点依次取为score值
将截断点依次取值为0.1,0.35,0.4,0.8时,计算TPR和FPR的结果。
3.1 截断点为 0.1
说明 只要 score>=0.1,它的预测类别就是正例。
此时,因为4个样本的 score都大于等于0.1,所以,所有样本的预测类别都为P。
scores = [0.1, 0.4, 0.35, 0.8]y_true = [0, 0, 1, 1]y_pred = [1, 1, 1, 1]
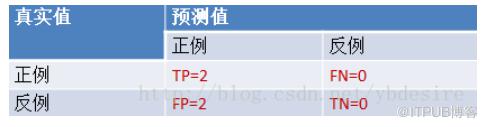
TPR = TP/(TP+FN) = 1 , FPR = FP/(TN+FP) = 1
3.2 截断点为0.35
说明只要score>=0.35,它的预测类别就是P。
此时,因为4个样本的score有3个大于等于0.35。所以,所有样本的预测类有3个为P(2个预测正确,1一个预测错误);1个样本被预测为N(预测正确)。
scores = [0.1, 0.4, 0.35, 0.8]y_true = [0, 0, 1, 1]y_pred = [0, 1, 1, 1]
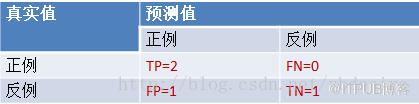
TPR = TP/(TP+FN) = 1 FPR = FP/(TN+FP) = 0.5
3.3 截断点为0.4
说明只要score>=0.4,它的预测类别就是P。
此时,因为4个样本的score有2个大于等于0.4。所以,所有样本的预测类有2个为P(1个预测正确,1一个预测错误);2个样本被预测为N(1个预测正确,1一个预测错误)。
scores = [0.1, 0.4, 0.35, 0.8]y_true = [0, 0, 1, 1]y_pred = [0, 1, 0, 1]
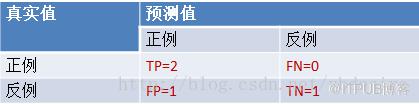
TPR = TP/(TP+FN) = 0.5,FPR = FP/(TN+FP) = 0.5
3.4 截断点为0.8
说明只要score>=0.8,它的预测类别就是P。所以,所有样本的预测类有1个为P(1个预测正确);3个样本被预测为N(2个预测正确,1一个预测错误)。
scores = [0.1, 0.4, 0.35, 0.8]y_true = [0, 0, 1, 1]y_pred = [0, 0, 0, 1]
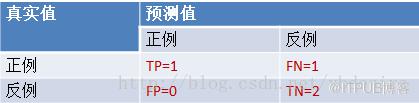
TPR = TP/(TP+FN) = 0.5,FPR = FP/(TN+FP) = 0
最后y 和score 计算出来的 tpr 和 fpr 如下:
y = np.array([0, 0, 1, 1])scores = np.array([0.1, 0.4, 0.35, 0.8])tpr = [0.5,0.5,1,1]fpr = [0,0.5,0.5,1]

知道AUC的详细计算结果后,然后使用Java代码设计出AUC的计算方式,最终土哥完美实现了Flink评估策略 。
往期推荐
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
