一 谈模型压缩
最近我其实在琢磨模型压缩,做了不少尝试。上次我在极视角直播的时候说,模型压缩加速的主要方向是如何提高二值化网络的精度。屌丝的我也一直在琢磨这玩意,渴望能搞点黑科技感受满大街白花花大腿和遍地的黄金。现在,我跟大伙说声对不起,要拍拍拍打脸了。我觉得这个方向不可行哎。
模型压缩,包括韩松的,bengio的,XNOR-net,说白了,后面的数学功底就两件事情,一、模型weights的正则化,二值化,量化,编码都是的(韩松的那个哈弗曼编码另算)。如果你不明白,我再讲浅一点,一个网络结构展开后,无外乎就是一个方程咯。比如:方程M=w1f(w2g(x))+w3g1(w4h2(w5p(x)))......,我们学到的权值参数就是这些w1,w2,w3,w4,w5,然后对他进行量化,32位转8位,甚至大于0为1,小于0为0,或者说如韩松的,1.8,2.1,2,2统统搞成2,你想想,这个是不是权值的正则化?L2?
另一件事情其实就是奥卡姆剃刀原理。你想想看,剪枝,比如说上面的方程M,其中的参数W3=0.03。果断把他置为0(这里插一句,其实置为0后,怎么让pb文件里面回收掉这个内存空间,其实我没能搞定,大家谁做出来了的帮帮我啊。),那么是不是模型结构变简单了?因为这个参数小,本来就对模型的影响不大。所以是有道理的。
回过头来,其实这个正则化和模型结构简化都是些边边角角的东西了,不是模型的主体。如果你二值化后其实是大动干戈,总归是没法保证精度的。因此,这个方向动脑筋,可以从一定程度上得到一些想要的东西,如压缩、加速,但没法从根本上解决问题。
二、谈谷歌的MobileNets。

我看文章喜欢用一句话概括一下,那么今天这篇文章一句话讲就是:以前我们的卷积核,都是长这样的:X*X*T,X是卷积核的大小,T是卷积核的通道,现在,谷歌的MobileNets把它一分为二:一个卷积核是X*X*1,一个卷积核是1*1*T。
上面的图a就是标准的卷积核,b、c就是他改造后的。
他这个鬼东西是有数学根底的,因为他没有动根本的东西,信号还是一样的传播,但是他把一步分为两步走,这样可以大大降低模型的参数了。为啥,说白了以前的参数量是?*T的,现在变成?+T了。
想想看,他这玩意还有什么好处?乘法变加法?这不是online judge刷题的那个可以降低时间复杂度的东西么?OK,就是这样,他就是达到了模型加速的效果。
其实他这个真的很简单,是不是?当初你我为啥都没有想到了?
前面说的其实主要是为了浅易的讲明白,其实并不严谨的。要严谨的推一推,你还是看论文吧。我就不贴论文的公式了。
顺道说一下,论文里有个印刷的小错误。以免初学者搞蒙了。就是这里:
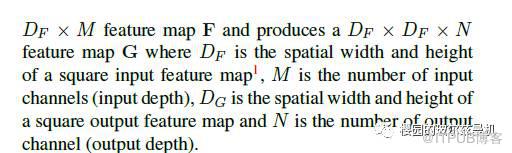
后面那个Df*Df*N 应该是Dg*Dg*N,否则输入输出的高度宽度一样了,后面他说的Dg也不知道怎么来的了。
三、谈开源
开源是大格局真生意。现在你想搞个sdk或者一些通用的架构挣钱是不可能的了。谷歌就是一个大森林,他希望其他人是小树,依偎在森林里。谷歌开源东西还很快,其他人就在亦步亦趋的跟着学跟着走吧。
开源能不能挣钱?开源能圈到用户啊,互联网思维,用户才是王道的。你说开源挣不了钱的话,那你问360它免费的360卫士怎么挣钱的好了。开源真的是大格局真生意。
老是跟在别人屁股后面走感觉好难受。之前我从caffe换到tensorflow就感觉很别扭的。没办法,屌丝嘛。
三、谈些感想
最近我有些浮躁,老是在群里推自己的文章。从今以后我不再在群里推文章了。打扰到大家了我道歉。老是推文章浪费精力。我得沉下来干点正事。
其实推文章主要是我的文章经常被抄袭。真的。所以我想扩大一些传播圈。这样看抄袭的人会不会传播圈缩小点。
举个例子:
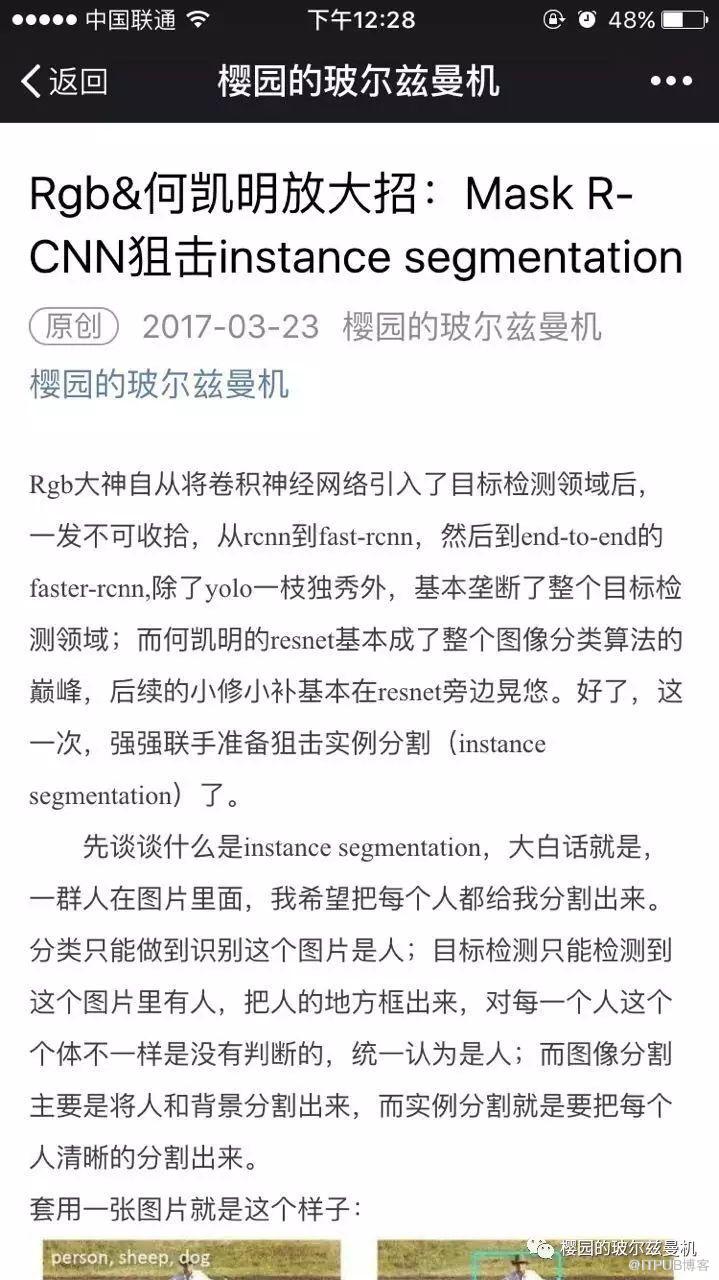

不过无所谓,大家都不容易。
那么,最后,我想说。
走过路过不要错过,关注主播不迷路。每晚1点大秀哦。
然后是:
看都让你全看了,也不关注一下,关注了也不转发分享,分享了连1块钱也不给我。
我可是把我的心(核心思想)都给了你。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

