其实我不太喜欢跟风,跟着新闻走。最近世俗了一把,一狠心好好的琢磨了一下这个mobilenets。
琢磨它的理论思想的话,论文里都有,之前也写了个小的论文笔记。我想琢磨点深的,尝试从理论的来源和实战来分享自己的经验。
一、科学家的潜意识
很多论文的idea,包括竞赛的许多tricks,说出来了大家都觉得没什么。So TM what!事实上,怎么样才能想到这样的idea,其实是弥足珍贵的。很多看似平常的思想,常人是想不到的,科学家也不是凭空想到的,他应当也是试探了不少路子,然后才找到这样一条看似简单实则不容易想到的路子。而想到这样的路子最根本的还是科学家的潜意识。
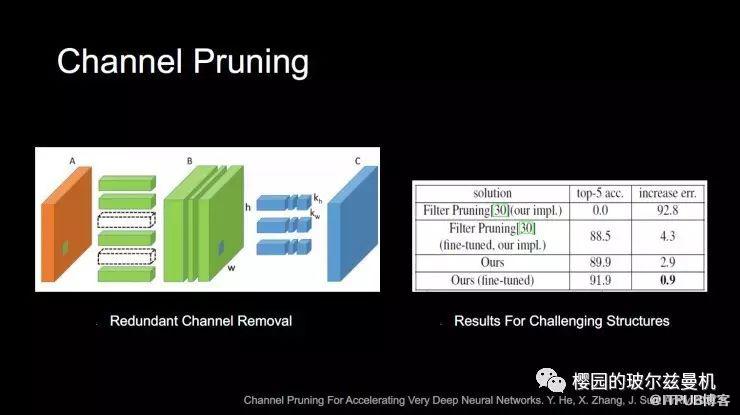
在卷积核的通道数上动脑筋,其实之前已经有些研究了。最近我粗略看了face++的几篇CVPR论文,其中就有一篇文章Channel pruning for accelerating very deep neural networks:
其次,谈一个我觉得应该是科学家的潜意识的东西。
众多女神的公公王健林说,先定一个可以实现的小目标;吴恩达也告诫大家一段时间内专注做一件事情;雷军大大也说,专注的时候,当你的专注点集中到一个针尖,你可以插进任何书桌,而手指则不行。
我觉得科学家有这样一个潜意识,当问题复杂时,为解决问题需要化繁为简,常用的方法就是分解大问题为小问题,分步解决。
今天文章算不上什么干货,纯当饭后闲扯。主要是如果大家搞paper思路受阻的时候,不妨尝试这个思想。
Mobilenet的思想根源不就是把一个标准卷积核一拆为二嘛,分步进行,这样就带来了不少好处。
事实上,我觉得残差网络也有这一层的思想。例如:如果网络只留下那些跳跃连接的层,那么这个网络就是一个浅层网络,能学习到主体信号特征;然后那些非跳跃连接的层,在每个跳跃连接的这个区间里面,学习一些边边角角的特征,就是学习残差,这样他不需要分心关注主体信号特征,能学得更好。
二、实战小分享
恋爱中的姑娘都说:我从来不听你说了什么,而是看你做了什么。口口声声说对我好,其实就一张嘴。
那么,学术研究也是这样。老是看论文吹牛我也不好意思。还是写点代码吧。
网上github上已经有不少实现了。我用的是一个tensoflow版的,发现是个假的,根本不收敛,网络也没有学到东西,预测的时候全预测成0类别了。索性自己搞了一个,由于自己搞的东西只是一个大工程的一小块,不太方便开源,后续我理一理好好的开源一下。
写好的代码跑出来的ckpt是37M。
实现一下论文里的代码,有一些细节我想说一下,我也说不准我实现的对不对,但我觉得这样可以得到比较好的结果,我运行后在我的小训练集上精度1,在验证集上精度0.86.
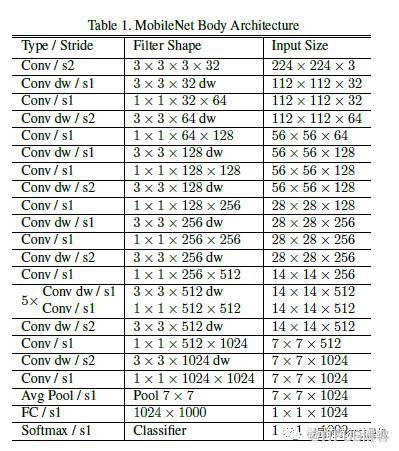
有以下几点需要注意:
1、你看图上,它有几个地方是降维了的,例如112*112*64转变到56*56*64,应该是有滑动窗口2,然后padding=1。
2、他里面有一个重复了五次的卷积核组合,14*14*512的。我觉得他这个不是凭空而来的,这个搞5个一样的卷积核组,位置在整个网络的中间偏后,这样可以提更高层的特征,而且不会带来太多的参数。另外可以好好琢磨下,三个怎么样,或者在网络中间搞一些其它组合又如何?
3、他这个卷积网络只有一个下采样层,而且是平均值下采样。是不是跟你想像中的长得不一样。
一言以概括,他这个网络结构不单单是我前一篇所说的那一句话,就是把一个标准卷积核一分为二,事实上,那只是一个点,其实它是一个精巧设计的网络。
我尝试过的一些想法给大家分享一下:
1、alexnet是一个540M左右的网络,我把其中的一层网络,卷积核是5*5*256,输入96维,输出256维的。我把他改成两层,一个是5*5*1,一个是1*1*256。结果压缩了30M的样子,然后是精度降低了不少。训练集上只有0.75,验证集上只有0.60.
2、我继续尝试,把卷积核改成一个是5*5*96,一个是1*1*256,只压缩了8M的样子,因此,对于一个有全连接层的网络来说,这种压缩微不足道。精度的话没什么影响。训练速度变快了。
3、我继续按2的方法再改掉一个标准卷积层,发现训练速度又快了,但是,收敛速度变慢了许多。测试发现精度也有变化,训练集达到0.89,验证集0.80。
4、大概就这些了。分享给大家。简单真诚是我的信条。
明天是全新的一天。各位小伙伴,请祝我好运。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

