强化学习在今年成为了AI界的核心。最近也在用强化学习做项目,项目上线了再给大家汇报。强化学习目前来看是deepmind和openAI两家在争霸。
强化学习有一个跟一般机器学习不一样的地方:他的数据集不是固定的,他需要不断获取状态参数,这样导致复现论文很难,有可能状态值某一步有些偏差,影响到了action,导致结果误差较大。
Deepmind前段时间开源了trfl框架,可以用python2.7,这个框架给了你很多基础组件,你可以很方便的重复出论文的实验。这几天,openAI也开源了自己的库spinningUp,这个库里面就内置了不少案例,同时你也可以拿来复现论文。非常方便。不过这个库要求的包都比较新,python要3.6,tensorflow需要1.10以上吧。同时搞两个环境得自己建一个虚拟python环境了。
两个项目的地址都给大家献上:
Trfl: https://github.com/deepmind/trfl
spinningUP: https://github.com/openai/spinningup
总体评价:trfl更好玩,可以直接拿来开发一些自己的项目;spinningUp相对来说是类似一个入门的教程。
入门三部曲:理论、环境搭建、代码走读。
一、浅谈理论。

这个图还是比较经典的,他就是要给知识树,你可以按这棵树的框架把强化学习的知识理清楚。简单的说,强化学习按对下一步的状体和回报是否可以预测,分为model-free和model-based,model-free只能对未来的回报做预测,他需要往后推测很多步才知道奖励和惩罚。而下围棋这种,下完这一步整盘棋是否赢需要往后推很多步,但是你走这一步后哪些子没气是可以直接预知的,因而都是model-based RL 。
知识树上每个点是啥意思大家自己去学吧。
二、环境搭建
按他的文档就可以搭建。写几个注意事项吧。
http://spinningup.openai.com/en/latest/user/installation.html
1、mujoco是一个c++的库,不免费的。你下载了编译好的.so文件后,记得在主目录下建一个隐藏文件家.mujoco。把下载好的zip包解压到这个目录下,把获得的license的mjkey.txt也放下面。这样才能安装mujoco-py package。否则会报错。
2、spinningup下面的安装pip install –e .会下载安装很多包,前期你最好用的是anaconda,否则容易下载时间过长而安装失败。网也要好,最好有vpn。
如果你能跑出这个:
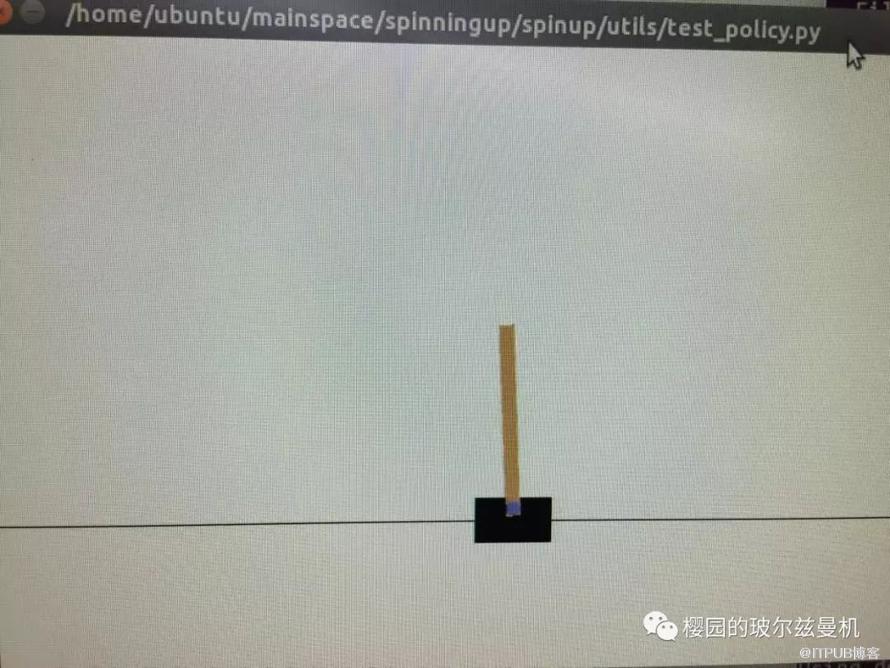
你就安装好了环境。
解释一下这个图片的意义:
这个就是一个典型的增强学习策略场景:这个底下的托盘要护住上面的棍子不倒,棍子往右倒,托盘往要往右走,要不然棍子就倒下了。这个在知识树上就是Model-base的分支。
三、代码走读:
入门建议看这个代码:
https://github.com/openai/spinningup/blob/master/spinup/examples/pg_math/1_simple_pg.py
清晰有条理。简单做一个代码走读:
1、 整个模拟仿真环境是gym写的。
2、 强化学习的几个要素:
Action:就是底下的滑板是往左还是往右走。本质是带方向和速度的,方向就是[+1,-1],速度是根据权值weight来学的。
对应代码是23-35行这些。
n_acts = env.action_space.n
action_masks = tf.one_hot(act_ph, n_acts)
状态:状态的值一直是通过gym获得的。
奖励和惩罚:就是棍子的偏移角度。batch_lens.append(ep_len),batch_rets.append(ep_ret)这些代码。
训练好后的模型保存在spinningUp的data目录下。Pb文件和pkl。
欢迎大家上手玩,跟进openAI 的步伐。玩这个比你简单跑一个强化学习玩鸟的demo要有价值些。代码结构很强化学习玩flappybird的有些类似,但也有不同。可以在这个基础上把一些过往的论文demo跑起来。然后实践一些新的idea。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

