人群计数问题我一直在关注,苦于目前的技术不能落地而作罢。早在便利蜂的时候,我们就专门做了这个数人流的事情,一个运营把一个摄像设备摆在某个角落拍商场的大门,看有多少人经过多少人进出大门,AI效果很一般,就招兼职专门人来数人数了,成本很高的。数人流很有商业价值的,黄金旺铺选址非常重要,人流量大的地方你的获客成本低。人群计数问题就是一张图片,你把人头的密度图画出来,然后sum人头密度图,就是人数。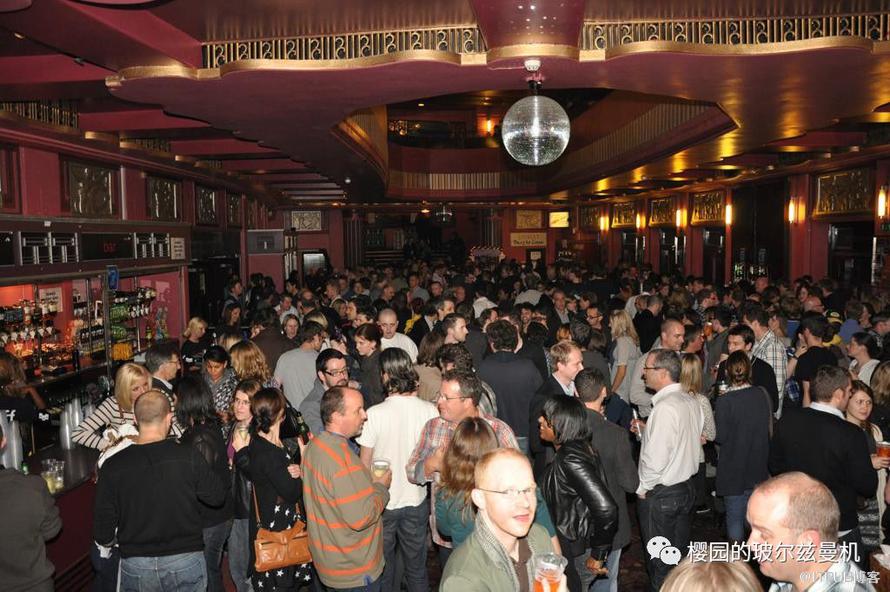
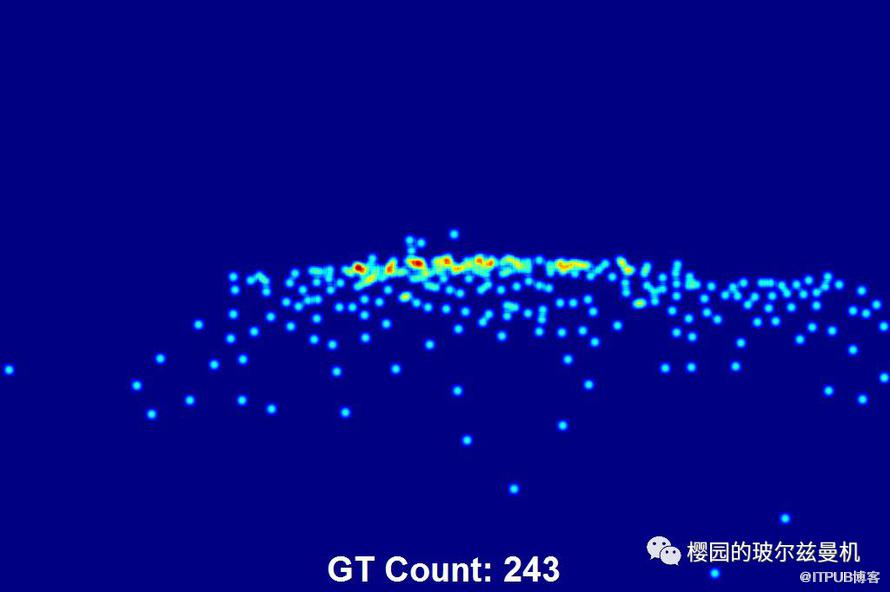
上面是原图,下面是密度图,每个绿点相当于一个人头,然后计数是243个。目前来看,几个方法中,HyGNN的效果是最好的。比较的图表如下:
|
|
|
|
|
|
|
| TEDNet (Jiang et al. 2019) |
|
|
| ADCrowdNet (Liu et al. 2019) |
|
|
|
|
|
|
|
|
|
当然,高君宇最近做的AAAI2020的SCAR:NWPU-Crowd: A Large-Scale Benchmark for Crowd Counting方法没有统计进去,因为他没有刷Shanghai techA数据集,刷的是自己的数据集。不过我觉得不会比HyGnn更好了。因为他们两个比较来说:前面的网络结构是一样的,后面decode的时候,SCAR是加了两个注意力机制层,一个空间层的注意力层,一个通道层面的注意力层,两个叠加在一起;HyGnn则是decode的时候加了grapha-nnet,形象一点说,graphanet是自动学习一个注意力机制,他比手工设计的注意力机制要更全面一些。我们来看看HyGNN干了啥活。我也只是昨天才开始看这个文章,今天基本搞明白了主要问题,由于没有源码,要想通过pytorch实现它对我来说还有一定难度。因为里面有很多花招,而且我还找不到一些对应的算子。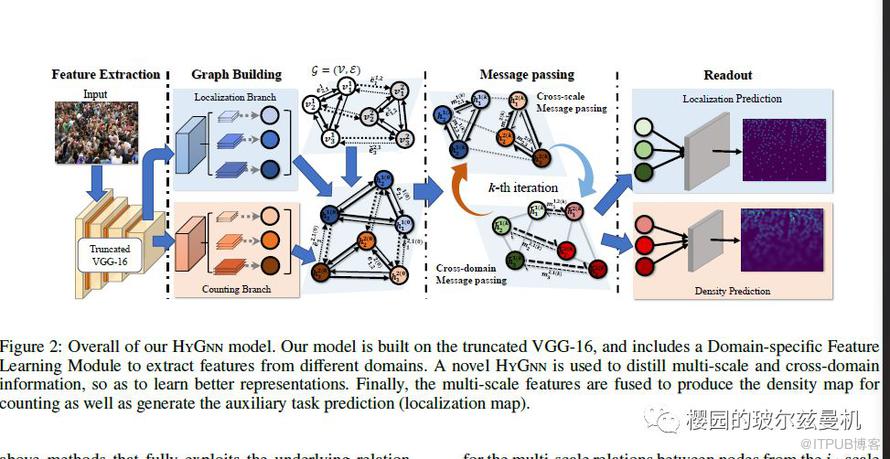
整个结构就在上面这个图里了。我们先说主要粗线条一二三,然后一点点剥出问题一二三。输入输出与loss函数。输入是原始图片,监督信号label是密度图,loss函数是平方误差损失函数,这里有两个损失:一个是直接预测密度图的,跟标记的密度图直接的平方损失loss1,一个是预测人头定位的,也是跟标记的密度图的平方损失loss2,总损失等于loss1+loss2*0.001。密度图求loss没问题,人头定位图跟密度图怎么求loss?为啥第二个loss的权重那么低?论文中写了,他没有额外的人头定位图label,是复用的密度图。仔细看一下预测的人群密度图和人头定位图,发现人头定位图更内聚,但有值的地方其实跟密度图是重叠的,其实也是可以求loss,当然他的loss就很大了,因此乘参数0.001,另外,这个人头定位图加上去,就是为了让预测的密度图不要打太散了,没人头的地方不要有预测值,因此他的作用类似于注意力机制里的参数。一张图片经过VGG16的前10层提取feature map后,同一个feature map兵分两路,去生成一个graph,一个是人头定位,一个是密度图的,因此是两个graph,然后,每个graph内部学习规律信息,同时,两个graph之间还学习交互信息,学到的交互信息融合进了每条支线的三个顶点里,然后每三个顶点concat到一起,接下来decode成一个密度图/人头定位图,去end-to-end训练loss。Graph neural net的图是怎么建立的,建立一个图需要顶点和邻边,那么顶点和邻边都啥意思,看框架图中这个有向图代表的是什么意思。总共只有3个顶点,文章测试发现3个顶点效果比较好。每个顶点都是feature map = Fnode,他是通过对Fvgg进行不同的空洞卷积率卷积而来,空洞卷积就是说每个卷积核是空心的,不懂的自己知乎下。处理的方式都是一样的,由于是兵分两路,任务不一样,从而学习到的卷积核的参数不同。文章将这个生成顶点的模块叫做 Domain-specific Feature Learning Module (DFL).。这个中间三个操作,一个空洞卷积,一个金字塔采样模块,然后归一化到统一尺度。每个顶点都有边相连,每条边的值有意思了,你看图1中,有的顶点之间是实线相连,有的是虚线,实线代表的是一个领域的顶点,比如都是预测人头位置的顶点域,虚线则是跨顶点域之间的连线。实线的值是两个顶点的feature map相减,然后加一个卷积层,就代表了这条边的值了。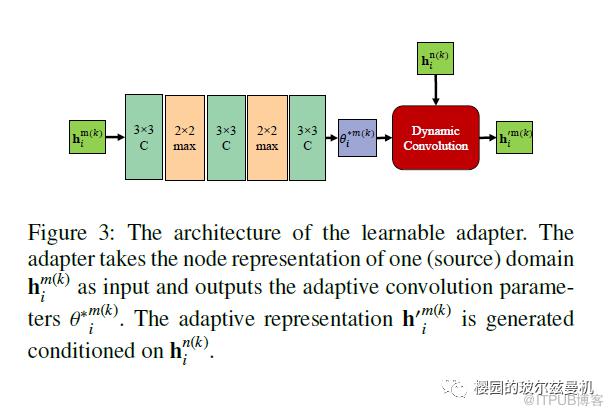
虚线的值就复杂些,比如说Fnode1和Fnode2相连,首先将Fnode1做了个花招,变成Fnode1’,这个适配器如图2所示,首先将Fnode1卷积下采样后,变成了一个卷积核!!!然后通过动态卷积操作跟Fnode2相合,就生成了Fnode1’。接下来就是跟实线一样的算边的值了。顶点和边的值都讲清楚了。接下来激动人心的时候到了。前面的都是铺垫,所谓的hybrid graph是怎么学习信号的才是核心。同一个问题域内不同空洞卷积率得到的节点之间的学习是这样的:通过一个2D map操作,将边的值变成一个权重值,乘到node的embedding上,得到一个值叫m,然后通过 Gated Recurrent Unit封闭循环神经源对他和 Fnode做操作,就得到一个迭代更新后的Fnode’。跨域的信号学习也是一样的,只是中间生成m的时候用到了图2中的适配器。他先学跨域的信号,再学同域节点之间的信号,来更新Fnode的值。最终,将3个节点的值concat起来,然后decode成密度图。完成整个end-to-end过程。适配器的算子和 Gated Recurrent Unit算子我其实不会的。不知道在pytorch里是怎么实现的。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

