疫情之下,最近比较闲比较闲,总觉得日子过得有些简单。索性刷个榜玩玩吧。说实话,我对人群密度估计这个小的学科领域一开始是一窍不通的,后来琢磨了一下,然后花了三周刷了个小榜。数据集是AAAI2020年才公开的,可能刷榜的人不多吧。https://www.crowdbenchmark.com/nwpucrowd.html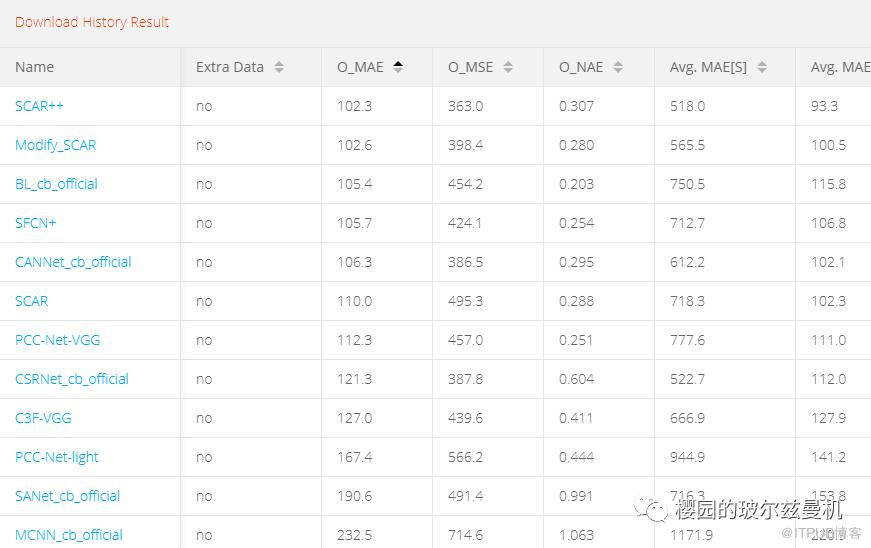
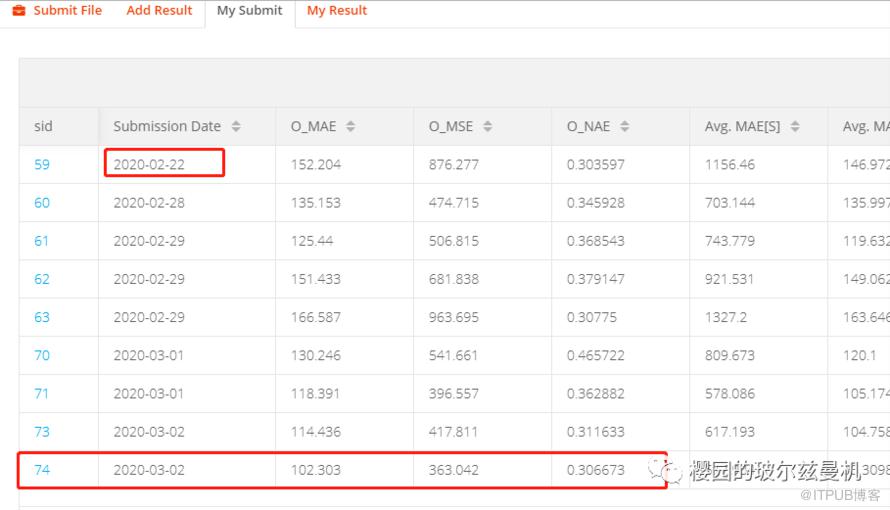
其实我也没什么了不起的。了不起的是做这个数据集的小伙伴。万事开头难嘛,定义问题做数据集建baseline是很辛苦的。疫情开始的时候就想找点活干,然后最近也没有被业务需求追着跑了,就把之前惦记着的人群人数统计的问题重新拿出来看了看,发现最近有不少新思路。我们17年一开始的时候也就是用detection的方法,效果很差的,然后想做多人的行人跟踪就更不准确了,翻了翻就发现了一个框架 C-3-Framework,然后下载了数据集 shanghai Tech。把数据集的输入输出,img和label搞明白了,其实搞了好阵子才知道他的label是怎么生成的,而且sum(人群密度图)就是人头个数。随后上手pytorch跑model,我对pytorch是小白水平,以前一直用tensorflow,用了pytorch后再也不想回去了,tensorflow写代码太心累,还是pytorch是我这样的python_boy的菜,清晰而简洁,有可读性和扩展性。跑通了之后,发现随便在网上找了张图片测试,效果很一般的,原因是训练数据集是那种高清俯拍图,都是有人的,而没人的,多角度多视野的就人群统计的很差了。后来就开始看看AAAI2020的论文,本来是关注RL方向的,后来就找了找人群计数的论文,发现这个文章:SCAR: Spatial-/Channel-wise Attention Regression Networks for Crowd Counting接着就看到这个数据集了。这数据集还是比较丰富的,各种角度有人没人的都有,就开始刷榜了。一开始自己训练model提交总是效果很差的,还有些怀疑论文的baseline是不是假的,后来代码跑顺溜了,改了几个bug,才算进入正轨了。中间又多看了几篇paper,发现SCAR可以做不少优化,然后就优化了一波,至少优化了3个方向吧,结果等着跑数据,跑的很慢的,一个epoch需要470s,我就一块1080ti的卡,好在白天黑夜都可以跑,跑完发现三个方向都没任何效果。总结反思了一下,又重新设计的实验的方向。结果跑着跑着看着收敛的越来越好了。昨晚发现迭代了274个epoch的模型在VAL数据集上MAE达到了80.4,MSE达到了340.2,就提交了一把,发现可以屠榜了。总结一点:其实也就是站在巨人肩膀上,多走了一步而已。跑跑实验刷榜还不错,要把这个写成paper就有些琐碎了。代码在我手里,想要的拿去写paper也可以,首先要对这个领域有深入理解的。否则我也不可能手把手教你玩。而且话说回来,目前这点微弱优势不一定能保持,还需再在一些思路上迭代优化的吧。事实上,写代码发论文是简单的,核心的是商业模式探索和积淀,因为写代码实现一些idea是一维空间上的探索,而商业需要多维多目标优化。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

