今天看了篇好玩的论文。简单干净。容易组装,可以火线上生产玩。不过还没试。应该效果不错。 文章名字:Gradient Surgery for Multi-Task Learning 代码链接:https://github.com/tianheyu927/PCGrad 会议:34th Conference on Neural Information Processing Systems (NeurIPS 2020), Vancouver, Canada. 有人可能觉得是一个trick,我觉得是一个很脑暴的好思路。 所谓跷跷板问题,就是说多目标优化的时候,任务A优化好了,结果发现任务B效果不好。解决这个问题的方法有很多,一个是帕累托最优,每次迭代的时候求一个可执行域,可执行域保证每个任务都是有优化的,然后在这个可执行域迭代求个任务的最优解;这个方法简单粗暴,解决多目标优化构建了一个监督信号,只要能收敛肯定保证了多个目标都得到了比初始值好的效果,但就是很容易不收敛,甚至可执行域都求不出来。最近为了能降低NAN的错误次数,出来了一篇small tower,后面有空分享一下;然后呢,有在模型结构上动脑筋的,之前分享的腾讯的PLE的文章,这里不赘叙。 今天这个文章又往下走了,直接优化了梯度优化的优化器。让优化器走的方向不再是梯度方向,而是根据情况调整的“伪梯度方向”。当然,在单个任务上这个肯定收敛会变慢,但他在优化器的层面保证了多个任务的协调步调。跟帕累托比较,相当于提前解决了冲突,而不是非得的等到最后任务前向传播算一个结果值发现不在执行域的时候再重新算,提前在梯度传播的时候就保证了步调一致,这样总的多任务收敛会更快。
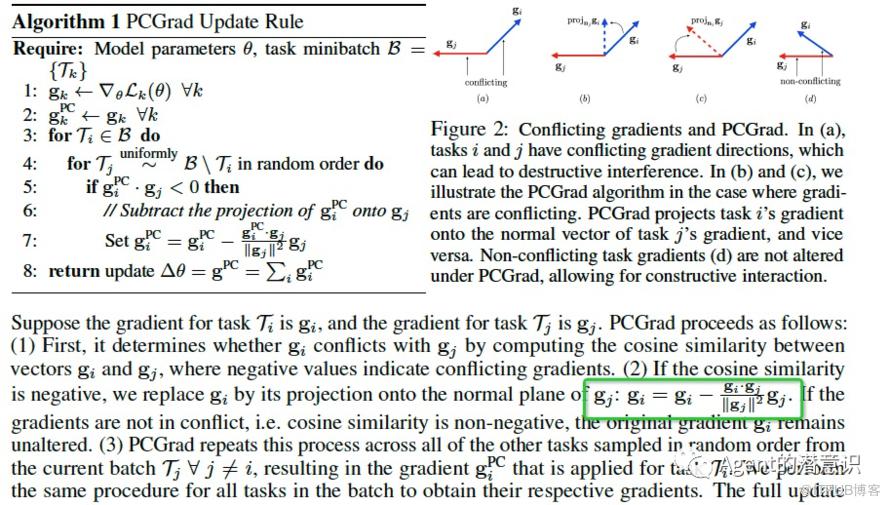
左边是算法伪代码,右边是图示。其实非常简单。Gi和gj代表两个梯度向量,如果这两个向量之间的夹角为钝角,那么,可想而知,他们其实在往不同方向拉优化方向,怎么解决呢?一个梯度向量gi往另一个梯度向量gj的法线上投影,用这个投影的新向量gi’代替之前的gi,这样gi’和gj之间的角度就是一个直角,能形成更大的合力。虽然对任务gi来说,他的梯度向量变短了。 公式就更简单了。就是一个简单的向量计算,图中的绿色标示的地方。
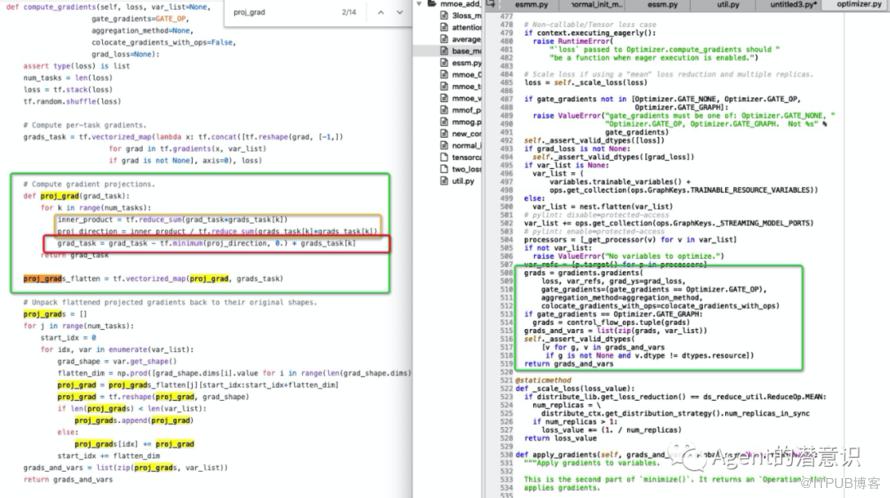
单独看他公布的代码可能还有些绕,我把他的优化器和tensorflow里的默认优化器做了一个对比图,左边是他的代码,右边是默认优化器。他的核心代码在绿色框里。 首先,他们的返回值名字都是一样的。grads_and_vars =list(zip(proj_grads, var_list))。只是他的优化器对梯度做了变化,图中左边的黄色小框这两句话在算两个梯度的余弦值,红色小框这句话:如果余弦值小于0,就算将梯度i调整为梯度i在梯度K上的投影,否则不动。 非常action!不花里胡哨,有创意!这个组件应该成为多目标优化的公用组件才对!
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。