今天给大家分享一篇有意思的文章。腾讯和吉林大学发表在AAAI2021的。他们设计了一个新的模型结构,多目标优化+强化学习,来优化实收保费这一最终目标。 文章名称:RevMan: Revenue-aware Multi-task Online Insurance Recommendation。论文现在还没放出来,我也是3月10日今晚7点才拿到手。我提前把他放百度云盘了。直接在公众号回复revman下载。 在线卖保险成为了电子商务指数增长的新方式。一个可以提升多个保险售卖场景全部收入的推荐算法成为了核心。以前的推荐算法干不了这个活:他们只能优化转化率,没有优化实收保费这一目标的;同时,这些老推荐算法不能抽取到多个售卖场景下多个保险产品之间的千丝万缕的联系,更进一步,由于在线保险的商业逻辑,收集最大化全部保费的训练集也不可行。为此,我们提出了一个新算法 RevMan,一个多任务在线保险推荐算法网络,它采用了自适应注意力机制。让复杂的多个保险业务场景任务同享特征,同时在一个离线数据集上,设计了提升保费和提升转化率的两个排序算法,离线和在线评测表名,我们的算法最优。

整个模型结构图就在上面了。Stage1是训练了一个转化率模型。这个模型有三层,第一层是共享层,第二层是自适应注意力机制层,第三层是finetune层。模型W1训练好后,不是直接排序得线上结果。线上的结果是Stage2得到的。右边第二阶段的意思是:一个Agent在不断学习Discount (折扣率),然后最终的保费是折扣率和产品价格和转化率模型W2计算得来的。这里之所以写成W2,是因为折扣率变化后,转化率预估的值有变化。第二阶段就有了一个根据实收保费排序的线上结果了。
文章还是很有意思的。先离线训练一个多任务的转化率模型,然后再通过强化学习在线实时学习一个保险产品的折扣权重,然后在更新折扣权重后的基础上上,按实收保费最大化来重新排序。同时细节上也做了一些处理,例如做了debias,排序位置不一样,转化率计算值不一样。不过有些地方写的稍显稚嫩。比如这段话,我觉得有些多余:

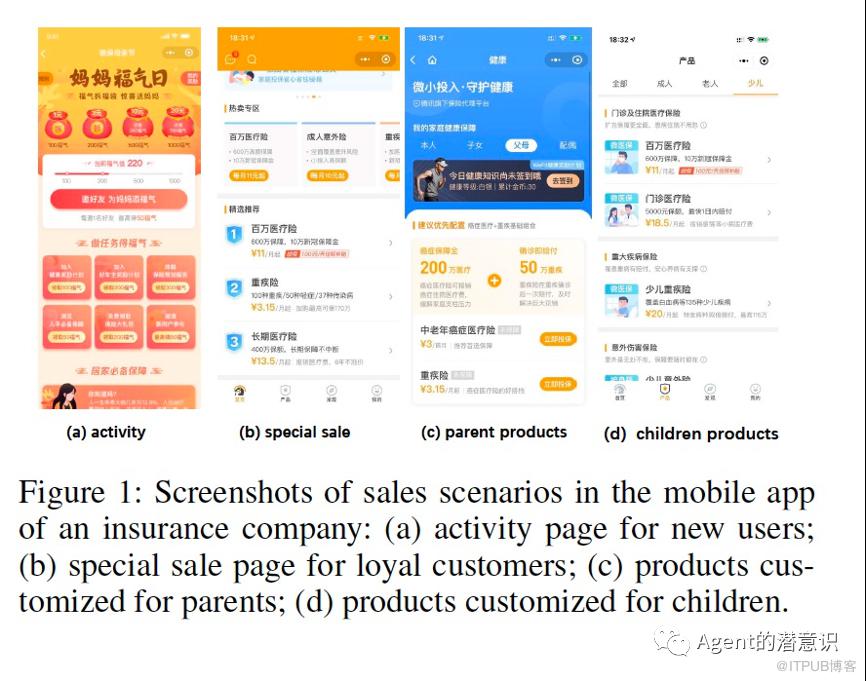
我们用relu,因为他比sigmoid和tanh都好,这也太老的东西了吧。 首先他这个是多任务学习,不是多个目标(转化率、点击率、实收保费、年化保费)。他的多任务的意思是:多个场景下的训练集联合训练。有哪几个场景呢?就是文章开篇说的4个:
这4个场景虽然产品迥异,但是有千丝万缕的联系,例如有人从来没有在平台上买过保险的,在新手区有很大优惠买了车险,然后顺带逛逛给爸妈买了个防癌险,又给小孩买了个健康险。因此这个多任务学习框架希望可以学到这层联系。
首先把用户画像、产品画像、u2i的行为数据做了3层卷积,在embedding层后,兵分两路:TSNA是跟没个任务相关的,每个任务独立一个分支网络,用来学每个任务独有的信号;而GEN层是所有任务共享的,每个任务都有,然后独有的TSNA分支和共享的GEN分支通过一个注意力层来统筹,统筹完后,跟TSNA分支结合一起,接一个MLP层,来对每个任务进行学习。Router的意思是来区分每个任务的。
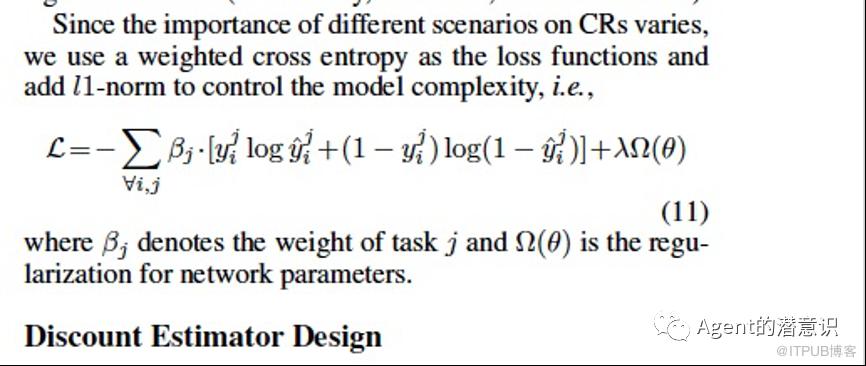
这部分我感觉有个地方没搞明白,他结尾处说他加了一个L1正则项,来限制模型的复杂程度,这个我也是头一次看到,应该是不需要的。你需要防止过拟合的话你可以加一层dropout吧。再说这个L1正则项写代码里不好写,模型参数那么多。
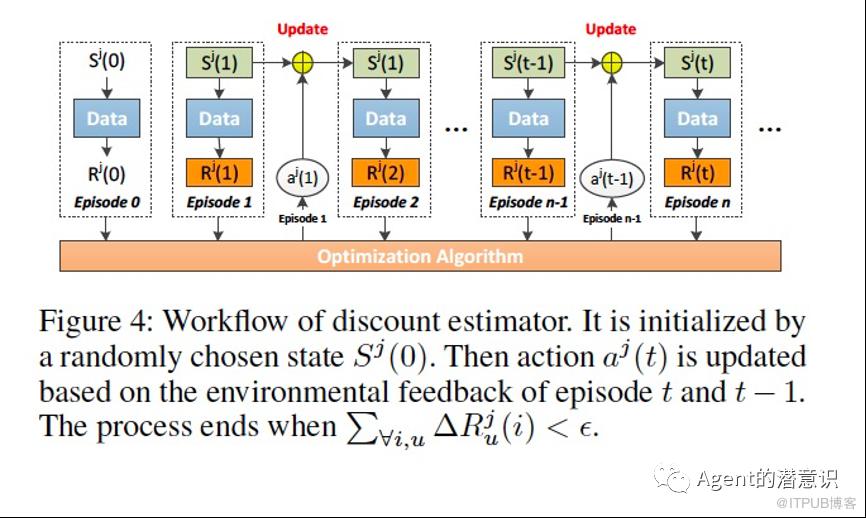
状态:在某折扣率下,展示顺序和各转化率值。
动作:折扣率的变化
奖惩:一个周期内的全部实收保费。
初始化状态函数和动作空间后,计算一个小周期时间t内的实收保费的变动值,然后调整一下折扣率,重新生成状态空间,再计算一个相同周期内的全部实收保费。不断迭代下去。直到实收保费的变动小于一个超参数为止。
这篇文章底层含义有点像那种超市大卖场,通过水、方便面卖的很便宜来吸引顾客往一个区域走,然后一些零食诸如酸梅、巧克力卖的比其他地方贵,来增收。通过多个场景一起联动来增加实收保费。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。