图片文字识别,就在我们身边,并且给我们带来了不少好处。不知大家有没发现,PC版的微信现在是支持复制图片上的文字的,在工作和生活中都给我们带来了不少便利。
什么是OCR?
OCR泛指文本图像中的文字检测和识别,是一种从图像中识别出文字的技术。简单是说:OCR识别是基于深度学习算法,利用光学字符识别技术,将图片上的文字内容,直接转换为可编辑文本。
OCR可以做什么?
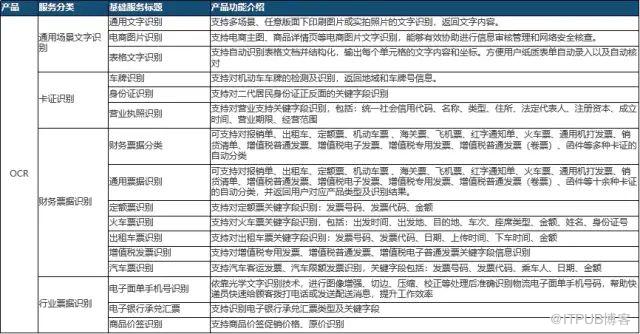
OCR可以提供精准的通用文字识别、丰富的卡片证照识别,专业的票据单据识别,灵活的自定义模板文字识别,快速对接应用,可广泛应用于身份认证、票据单据识别、内容监管与审核等场景,支持提供定制化服务,可以有效地代替人工录入信息。让应用看图识字,提升输入效率,优化用户体验。
OCR的应用场景有哪些呢?
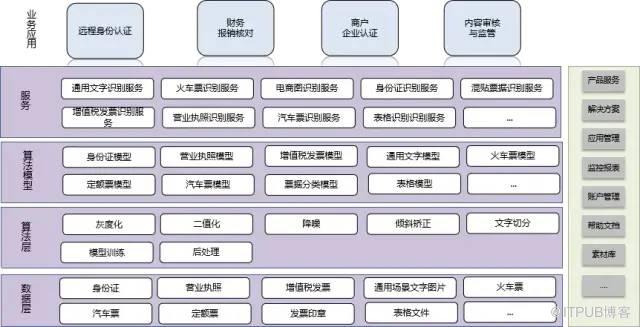
OCR中台产品架构
OCR需要大量数据采集,通过数据标注进行我们的算法模型的训练,主要流程环节有:图像的输入、图像预处理、文本行检测、字符切割、字符识别、后处理,算法模型完成后,封装成标准的API服务,面向用户提供识别能力。
如何基于paddle实现OCR?
1、环境准备
安装python3、pip、conda
相关环境准备可参考:
https://www.paddlepaddle.org.cn/
2、代码测试
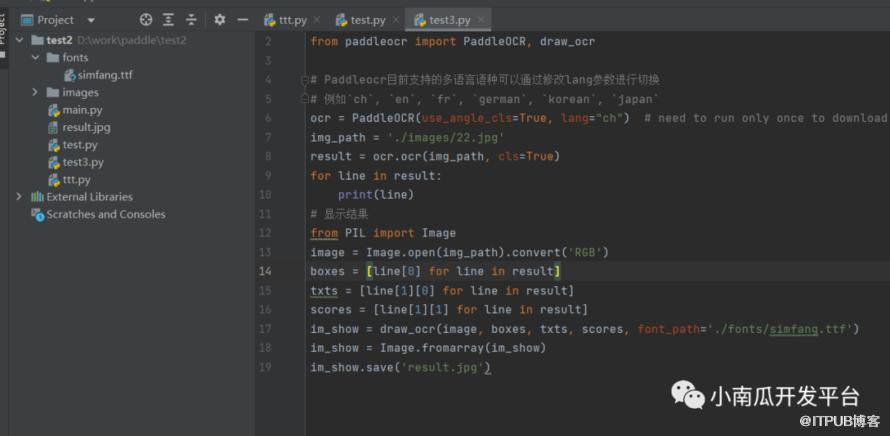
环境安装好后,可以在pycharm中输入如下代码
from paddleocr import PaddleOCR, draw_ocr# Paddleocr目前支持的多语言语种可以通过修改lang参数进行切换# 例如`ch`, `en`, `fr`, `german`, `korean`, `japan`ocr = PaddleOCR(use_angle_cls=True, lang="ch") # need to run only once to download and load model into memoryimg_path = './images/22.jpg'result = ocr.ocr(img_path, cls=True)for line in result:print(line)# 显示结果from PIL import Imageimage = Image.open(img_path).convert('RGB')boxes = [line[0] for line in result]txts = [line[1][0] for line in result]scores = [line[1][1] for line in result]im_show = draw_ocr(image, boxes, txts, scores, font_path='./fonts/simfang.ttf')im_show = Image.fromarray(im_show)im_show.save('result.jpg')
整体目录结构如下:
3、待识别图片

4、识别后输出识别到文字的内容图像
从图像中可以看到,已100%将图片中的文字识别出来

5、内容封装
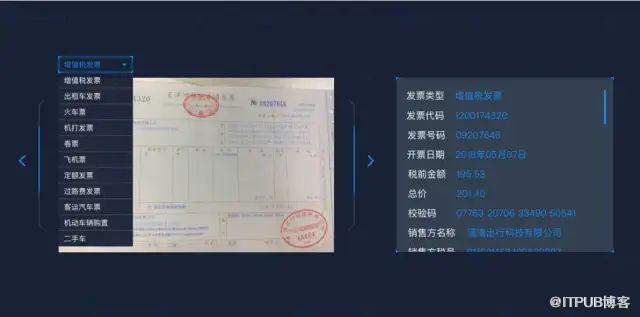
根据不同的场景和算法,将图片识别出来的文字进行训练,以便满足业务场景的需求:下图是识别出来的文字内容,具体可根据场景进行接口的封装和调用。

例如以下场景的封装:
其他问题参考文档:
1、创建 conda虚拟环境命令
conda create --name paddle_env python=3.10 --channel https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/
2、激活您刚刚创建的 Conda 环境,请在命令行中输入以下命令:
#激活 paddle_env 环境
conda activate paddle_env
3、#查看python的当前位置
where python
4、安装相关库
pip install paddleocr -i http://pypi.douban.com/simple --trusted-host pypi.douban.com
https://zhuanlan.zhihu.com/p/561569555
总结
OCR识别涵盖通用类、票据类、证件类、定制类,典型的应用场景有商品图片中的敏感词文字检测及识别,企业和个人证件信息的自动识别和提取,财务税票的文字检测及识别,文档或者宣传资料中的文字检测识别等。由于深度学习和图像检测技术的发展,使得上述场景中的文字的检测和识别效果越来越好,使得机器自动识别成为可能,助力企业提高生产力,降低运营成本。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

