1. 向量检索系统介绍
检索系统存在于我们日常使用的很多产品中,比如商品搜索系统、学术文献检索系等等,百度PaddleNLP团队提供了检索系统完整实现。限定场景是用户通过输入检索词 Query,快速在海量数据中查找相似文档。
所谓语义检索(也称基于向量的检索),是指检索系统不再拘泥于用户 Query 字面本身,而是能精准捕捉到用户 Query 后面的真正意图并以此来搜索,从而更准确地向用户返回最符合的结果。通过使用最先进的语义索引模型找到文本的向量表示,在高维向量空间中对它们进行索引,并度量查询向量与索引文档的相似程度,从而解决了关键词索引带来的缺陷。
例如下面两组文本 Pair,如果基于关键词去计算相似度,两组的相似度是相同的。而从实际语义上看,第一组相似度高于第二组。
车头如何放置车牌 前牌照怎么装车头如何放置车牌 后牌照怎么装
语义检索系统的关键就在于,采用语义而非关键词方式进行召回,达到更精准、更广泛得召回相似结果的目的。
2. 产品功能介绍
本项目提供了低成本搭建端到端语义检索系统的能力。用户只需要处理好自己的业务数据,就可以使用本项目预置的语义检索系统模型(召回模型、排序模型)快速搭建一个针对自己业务数据的问答系统,并可以提供 Web 化产品服务。以下是使用预置模型的教程,如果用户想训练并接入自己训练的模型,模型训练可以参考Neural Search(https://github.com/PaddlePaddle/PaddleNLP/tree/develop/
applications/neural_search)。
2.1 系统特色
端到端
提供包括数据建库、模型服务部署、WebUI 可视化一整套端到端语义检索系统能力
多源数据支持: 支持对 Txt、Word、PDF、Image 多源数据进行解析、识别并写入 ANN 数据库
效果好
依托百度领先的NLP技术,包括ERNIE语义理解技术与RocketQA开放域问答技术
预置领先的深度学习模型
3. 快速开始: 快速搭建语义检索系统
以下是针对mac和linux的安装流程,windows的安装和使用流程请参考windows(https://github.com/PaddlePaddle/PaddleNLP/blob/develop/pipelines/examples/semantic-search/Install_windows.md)
3.1 运行环境和安装说明
本实验采用了以下的运行环境进行,详细说明如下,用户也可以在自己 GPU 硬件环境进行:
a. 软件环境:
python >= 3.7.0
paddlenlp >= 2.2.1
paddlepaddle-gpu >=2.3
CUDA Version: 10.2
NVIDIA Driver Version: 440.64.00
Ubuntu 16.04.6 LTS (Docker)
b. 硬件环境:
NVIDIA Tesla V100 16GB x4卡
Intel(R) Xeon(R) Gold 6148 CPU @ 2.40GHz
c. 依赖安装:首先需要安装PaddlePaddle,
pip install paddlepaddle # for cpupip install paddlepaddle-gpu # for gpu
然后安装下面的依赖:
# pip 一键安装pip install --upgrade paddle-pipelines -i https://pypi.tuna.tsinghua.edu.cn/simple# 或者源码进行安装最新版本cd ${HOME}/PaddleNLP/pipelines/pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simplepython setup.py install
【注意】以下的所有的流程都只需要在pipelines根目录下进行,不需要跳转目录
3.2 数据说明
语义检索数据库的数据来自于DuReader-Robust数据集,共包含 46972 个段落文本,并选取了其中验证集1417条段落文本来搭建语义检索系统。
3.3 一键体验语义检索系统
3.3.1 快速一键启动
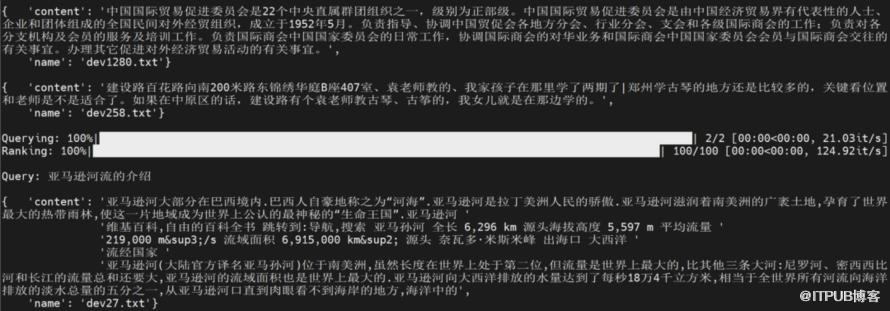
预置了基于DuReader-Robust数据集搭建语义检索系统的代码示例,您可以通过如下命令快速体验语义检索系统的效果
# 我们建议在 GPU 环境下运行本示例,运行速度较快# 设置 1 个空闲的 GPU 卡,此处假设 0 卡为空闲 GPUexport CUDA_VISIBLE_DEVICES=0python examples/semantic-search/semantic_search_example.py --device gpu \--search_engine faiss# 如果只有 CPU 机器,可以通过 --device 参数指定 cpu 即可, 运行耗时较长unset CUDA_VISIBLE_DEVICESpython examples/semantic-search/semantic_search_example.py --device cpu \--search_engine faiss
3.4 构建 Web 可视化语义检索系统
整个 Web 可视化语义检索系统主要包含 3 大组件: 1. 基于 ElasticSearch 的 ANN 服务 2. 基于 RestAPI 构建模型服务 3. 基于 Streamlit 构建 WebUI,接下来我们依次搭建这 3 个服务并最终形成可视化的语义检索系统。
3.4.1 启动 ANN 服务
参考官方文档下载安装 elasticsearch-8.3.2 并解压。
启动 ES 服务 首先修改
config/elasticsearch.yml的配置:
xpack.security.enabled: false然后启动:
./bin/elasticsearch如果报java错误,可以在config/elasticsearch.yml的网络部分中增加 ingest.geoip.downloader.enabled: false
检查确保 ES 服务启动成功
curl http://localhost:9200/_aliases?pretty=true备注:ES 服务默认开启端口为 9200
3.4.2 文档数据写入 ANN 索引库
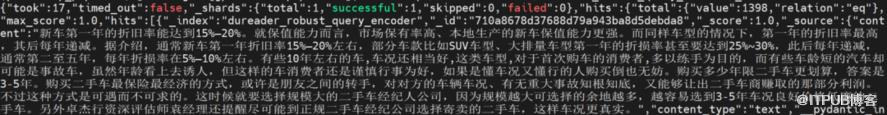
# 以DuReader-Robust 数据集为例建立 ANN 索引库python utils/offline_ann.py --index_name dureader_robust_query_encoder \--doc_dir data/dureader_dev \--search_engine elastic \--delete_index
可以使用下面的命令来查看数据:
curl http://localhost:9200/dureader_robust_query_encoder/_search
参数含义说明
index_name: 索引的名称doc_dir: txt文本数据的路径host: ANN索引引擎的IP地址port: ANN索引引擎的端口号search_engine: 选择的近似索引引擎elastic,milvus,默认elasticdelete_index: 是否删除现有的索引和数据,用于清空es的数据,默认为false
3.4.3 启动 RestAPI 模型服务
# 指定语义检索系统的Yaml配置文件export PIPELINE_YAML_PATH=rest_api/pipeline/semantic_search.yaml# 使用端口号 8891 启动模型服务python rest_api/application.py 8891
Linux 用户推荐采用 Shell 脚本来启动服务::
sh examples/semantic-search/run_search_server.sh启动后可以使用curl命令验证是否成功运行:
curl -X POST -k http://localhost:8891/query -H 'Content-Type: application/json' -d '{"query": "衡量酒水的价格的因素有哪些?","params": {"Retriever": {"top_k": 5}, "Ranker":{"top_k": 5}}}'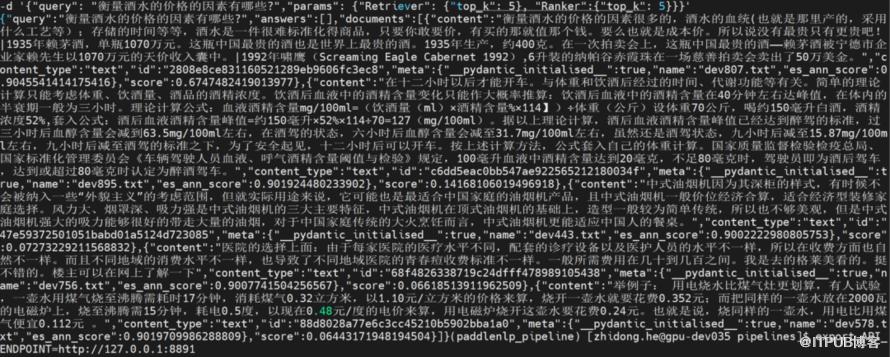
3.4.4 启动 WebUI
# 配置模型服务地址export API_ENDPOINT=http://127.0.0.1:8891# 在指定端口 8502 启动 WebUIpython -m streamlit run ui/webapp_semantic_search.py --server.port 8502
Linux 用户推荐采用 Shell 脚本来启动服务::
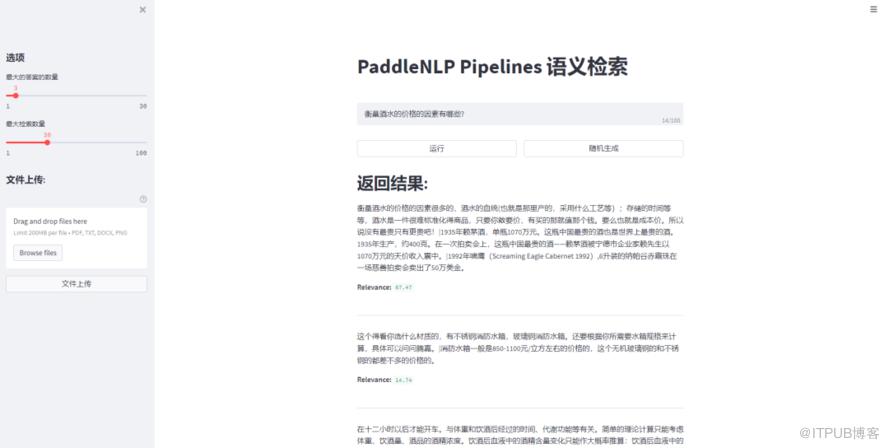
sh examples/semantic-search/run_search_web.sh到目前为止,语义检索系统就搭建好了,本地可以通过http://127.0.0.1:8502访问,服务器可以通过http://${linux server ip}:8502/来访问,如下图所示:
3.4.5 数据更新
数据更新的方法有两种,第一种使用前面的 utils/offline_ann.py进行数据更新,第二种是使用前端界面的文件上传(在界面的左侧)进行数据更新。对于第一种使用脚本的方式,可以使用多种文件更新数据,示例的文件更新建索引的命令如下,里面包含了图片(目前仅支持把图中所有的文字合并建立索引),docx(支持图文,需要按照空行进行划分段落),txt(需要按照空行划分段落)三种格式的文件建索引:
python utils/offline_ann.py --index_name dureader_robust_query_encoder \--doc_dir data/file_example \--port 9200 \--search_engine elastic \--delete_index
对于第二种使用界面的方式,支持txt,pdf,image,word的格式,以txt格式的文件为例,每段文本需要使用空行隔开,程序会根据空行进行分段建立索引,示例数据如下(demo.txt):
兴证策略认为,最恐慌的时候已经过去,未来一个月市场迎来阶段性修复窗口。从海外市场表现看,对俄乌冲突的恐慌情绪已显著释放,海外权益市场也从单边下跌转入双向波动。长期,继续聚焦科技创新的五大方向。1)新能源(新能源汽车、光伏、风电、特高压等),2)新一代信息通信技术(人工智能、大数据、云计算、5G等),3)高端制造(智能数控机床、机器人、先进轨交装备等),4)生物医药(创新药、CXO、医疗器械和诊断设备等),5)军工(导弹设备、军工电子元器件、空间站、航天飞机等)。
原文作者:ArronAI;如有侵权,请联系管理员删除。

最新文章
- LLM之RAG实战(四十三)| 使用模型监控pipeline构建端到端RAG Pipeline
- MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL
- MLLM(一)| 文/图生视频任务大升级,BigModel 开源了视频模型CogVideoX
- LLM之RAG理论(十二)| RAG和Graph RAG对比
- LLM之RAG实战(四十二)| 如何在LlamaIndex和LangChain中正确选择RAG开发框架
- LLM之Prompt(四)| OpenAI、微软发布Prompt技术报告
- LLM漫谈(七)| 使用PyTorch从零构建LLM
- LLM之RAG实战(四十)| 使用LangChain SQL Agent和MySQL搭建多层RAG ChatBot
- LLM之RAG实战(三十九)| 高级RAG技术全面解析(附代码)
- LLM之RAG理论(十一)| 面向生产的RAG应用程序的12种调整策略指南
