中文分词
三种分词模式,满足各类分词需求
from paddlenlp import Taskflow# 默认模式————实体粒度分词,在精度和速度上的权衡,基于百度LAC> seg = Taskflow("word_segmentation")> seg("近日国家卫健委发布第九版新型冠状病毒肺炎诊疗方案")['近日', '国家卫健委', '发布', '第九版', '新型', '冠状病毒肺炎', '诊疗', '方案']# 快速模式————最快:实现文本快速切分,基于jieba中文分词工具> seg_fast = Taskflow("word_segmentation", mode="fast")> seg_fast("近日国家卫健委发布第九版新型冠状病毒肺炎诊疗方案")['近日', '国家', '卫健委', '发布', '第九版', '新型', '冠状病毒', '肺炎', '诊疗', '方案']# 精确模式————最准:实体粒度切分准确度最高,基于百度解语# 精确模式基于预训练模型,更适合实体粒度分词需求,适用于知识图谱构建、企业搜索Query分析等场景中> seg_accurate = Taskflow("word_segmentation", mode="accurate")> seg_accurate("近日国家卫健委发布第九版新型冠状病毒肺炎诊疗方案")['近日', '国家卫健委', '发布', '第九版', '新型冠状病毒肺炎', '诊疗', '方案']
批量样本输入,平均速度更快
输入为多个句子组成的list,平均速度会更快。
> from paddlenlp import Taskflow> seg = Taskflow("word_segmentation")> seg(["第十四届全运会在西安举办", "三亚是一个美丽的城市"])[['第十四届', '全运会', '在', '西安', '举办'], ['三亚', '是', '一个', '美丽', '的', '城市']]
自定义词典
你可以通过传入user_dict参数,装载自定义词典来定制分词结果。在默认模式和精确模式下,词典文件每一行由一个或多个自定义item组成。词典文件user_dict.txt示例:
平原上的火焰上 映
在快速模式下,词典文件每一行为一个自定义item+"\t"+词频(词频可省略,词频省略则自动计算能保证分出该词的词频),暂时不支持黑名单词典(即通过设置”年“、”末“,以达到切分”年末“的目的)。词典文件user_dict.txt示例:
平原上的火焰 10加载自定义词典及输出结果示例:
> from paddlenlp import Taskflow> seg = Taskflow("word_segmentation")> seg("平原上的火焰宣布延期上映")['平原', '上', '的', '火焰', '宣布', '延期', '上映']> seg = Taskflow("word_segmentation", user_dict="user_dict.txt")> seg("平原上的火焰宣布延期上映")['平原上的火焰', '宣布', '延期', '上', '映']
参数说明
mode:指定分词模式,默认为None。batch_size:批处理大小,请结合机器情况进行调整,默认为1。user_dict:自定义词典文件路径,默认为None。task_path:自定义任务路径,默认为None。
文档智能
以多语言跨模态布局增强文档预训练模型ERNIE-Layout为核心底座
输入格式
[{"doc": "./invoice.jpg", "prompt": ["发票号码是多少?", "校验码是多少?"]},{"doc": "./resume.png", "prompt": ["五百丁本次想要担任的是什么职位?", "五百丁是在哪里上的大学?", "大学学的是什么专业?"]}]
默认使用PaddleOCR进行OCR识别,同时支持用户通过word_boxes传入自己的OCR结果,格式为List[str, List[float, float, float, float]]。
[{"doc": doc_path, "prompt": prompt, "word_boxes": word_boxes}]
支持单条、批量预测
支持本地图片路径输入
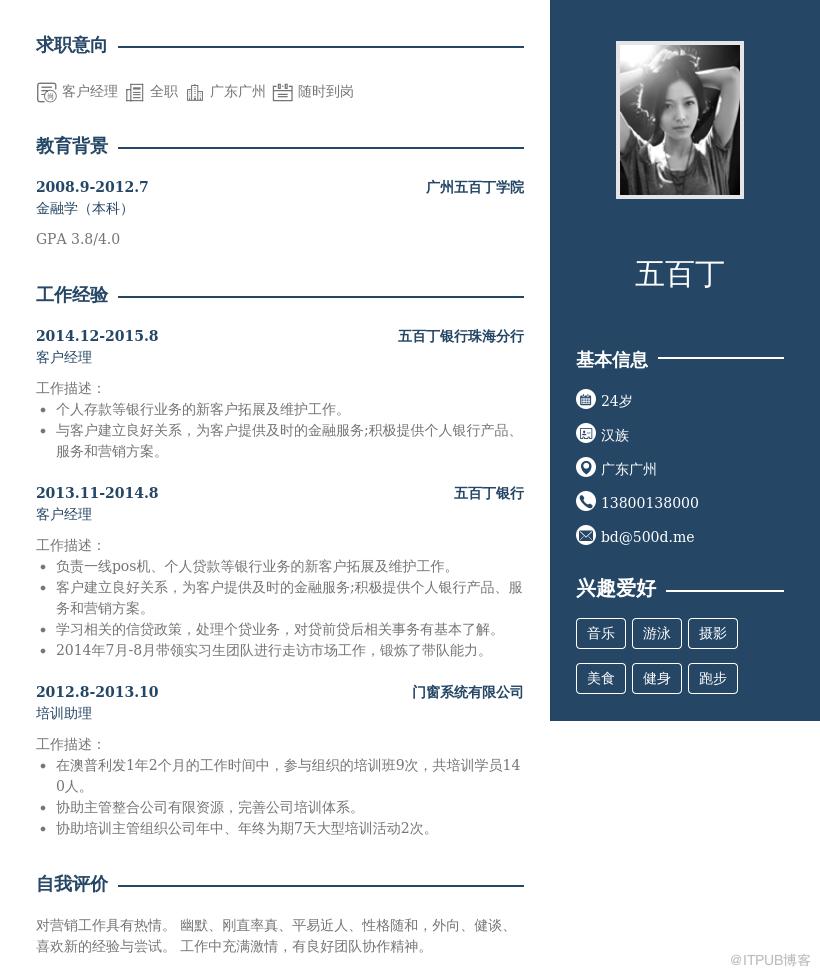
from pprint import pprintfrom paddlenlp import Taskflowdocprompt = Taskflow("document_intelligence")pprint(docprompt([{"doc": "./resume.png", "prompt": ["五百丁本次想要担任的是什么职位?", "五百丁是在哪里上的大学?", "大学学的是什么专业?"]}]))[{'prompt': '五百丁本次想要担任的是什么职位?','result': [{'end': 7, 'prob': 1.0, 'start': 4, 'value': '客户经理'}]},{'prompt': '五百丁是在哪里上的大学?','result': [{'end': 37, 'prob': 1.0, 'start': 31, 'value': '广州五百丁学院'}]},{'prompt': '大学学的是什么专业?','result': [{'end': 44, 'prob': 0.82, 'start': 38, 'value': '金融学(本科)'}]}]
http图片链接输入
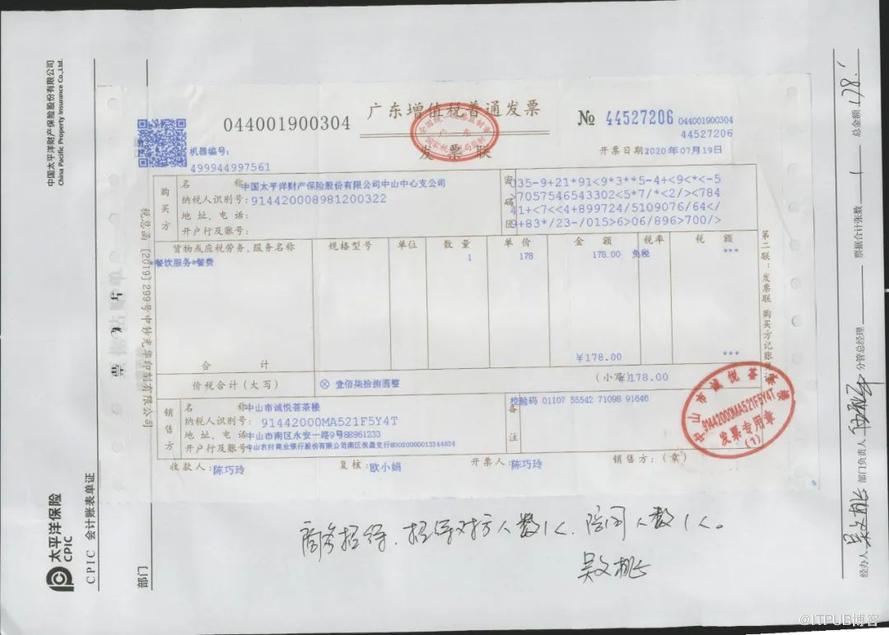
from pprint import pprintfrom paddlenlp import Taskflowdocprompt = Taskflow("document_intelligence")pprint(docprompt([{"doc": "https://bj.bcebos.com/paddlenlp/taskflow/document_intelligence/images/invoice.jpg", "prompt": ["发票号码是多少?", "校验码是多少?"]}]))[{'prompt': '发票号码是多少?','result': [{'end': 2, 'prob': 0.74, 'start': 2, 'value': 'No44527206'}]},{'prompt': '校验码是多少?','result': [{'end': 233,'prob': 1.0,'start': 231,'value': '01107 555427109891646'}]}]
可配置参数说明
batch_size:批处理大小,请结合机器情况进行调整,默认为1。lang:选择PaddleOCR的语言,ch可在中英混合的图片中使用,en在英文图片上的效果更好,默认为ch。topn: 如果模型识别出多个结果,将返回前n个概率值最高的结果,默认为1。
PART Ⅱ 定制化训练
这里我们以命名实体识别Taskflow("ner", mode="accurate")为例,展示如何定制自己的模型。
调用Taskflow接口后,程序自动将相关文件下载到$HOME/.paddlenlp/taskflow/wordtag/,该默认路径包含以下文件:
$HOME/.paddlenlp/taskflow/wordtag/├── model_state.pdparams # 默认模型参数文件├── model_config.json # 默认模型配置文件└── tags.txt # 默认标签文件
参考上表中对应示例准备数据集和标签文件
tags.txt,执行相应训练脚本得到自己的model_state.pdparams和model_config.json。根据自己数据集情况,修改标签文件
tags.txt。将以上文件保存到任意路径中,自定义路径下的文件需要和默认路径的文件一致:
custom_task_path/├── model_state.pdparams # 定制模型参数文件├── model_config.json # 定制模型配置文件└── tags.txt # 定制标签文件
通过
task_path指定自定义路径,使用Taskflow加载自定义模型进行一键预测:
from paddlenlp import Taskflowmy_ner = Taskflow("ner", mode="accurate", task_path="./custom_task_path/")

