问答系统(Question Answering System, QA)是信息检索系统的一种高级形式,它能用准确、简洁的自然语言回答用户用自然语言提出的问题。问答系统在搜索引擎、智能客服和智能助手等应用场景中都发挥着重要作用。检索式问答系统是问答系统的重要类别,它能从大量文本中检索出问题的答案。下图是检索式问答系统的功能示意。
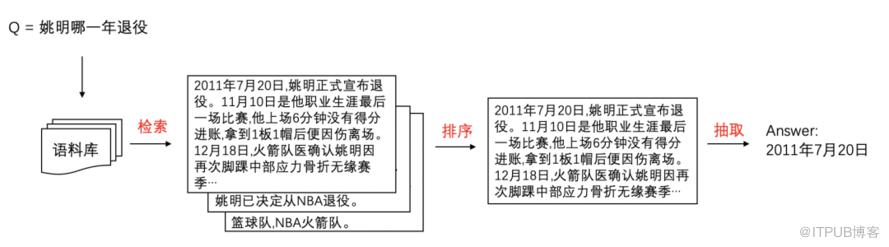
主流的检索式问答系统通常包含检索(retriever)、排序(reranker)和答案抽取(reader)等多个串行模块。随着大规模预训练模型的发展,研究人员开始探索基于深度语义表示的问答模型。得益于预训练模型生成的高质量语义表示空间和端到端的训练方法,语义模型能够提供更优质的结果,并且简化了传统问答系统的级联架构和特征工程方案,使系统的复杂性大大降低。
在此背景下,百度NLP提出了一系列基于语义的问答模型--RocketQA。RocketQA系列工作不仅被自然语言处理领域的多个国际顶级会议录取,也在百度的搜索业务中发挥了重要作用。为了使更多研发人员能够方便地获取最先进的问答语义检索与排序技术,百度NLP联合飞桨共同发布了基于RocketQA的开发工具。
本示例介绍了RocketQA开发工具的功能,演示如何基于该工具搭建一套问答系统。
RocketQA工具的基本功能
1、提供训练好的RocketQA模型和简单易用的模型预测api。
2、提供基于RocketQA模型搭建问答系统的简单方案。
项目亮点
1、领先的问答模型:
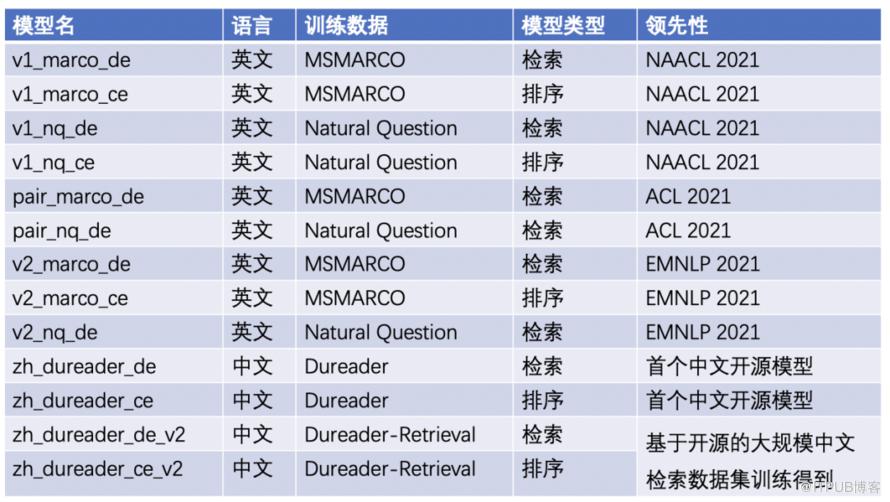
RocketQA开发工具提供13个业界领先的预置模型,包括3篇顶会论文的共9个英文开源模型,和首个中文的开源语义检索、排序模型。
2、强大的中文能力:
RocketQA提供首个开源的中文端到端问答模型。模型是在强大的预训练语言模型ERNIE上,用百万量级人工标注数据集DuReader和精细标注的检索数据集Dureader-Retrieval训练得到的,效果出众。
3、简单的开发接口:
RocketQA开发工具可以通过pip一键安装,同时也提供了装有所有依赖的docker镜像。
工具提供精简的开发接口和使用样例,仅需两行命令即可搭建自己的问答系统。
项目详情和源码见:
https://github.com/PaddlePaddle/RocketQA
使用说明
1、安装
# pip安装RocketQA工具包
!pip install rocketqa
# 查看RocketQA提供的预置模型
import rocketqa
rocketqa_models = rocketqa.available_models()
for m_name in rocketqa_models:
print (m_name)v1_marco_de
v1_marco_ce
v1_nq_de
v1_nq_ce
pair_marco_de
pair_nq_de
v2_marco_de
v2_marco_ce
v2_nq_de
zh_dureader_de
zh_dureader_ce
zh_dureader_de_v2
zh_dureader_ce_v2
2、使用预置模型完成预测
# 使用RocketQA预置的模型做预测

import rocketqa

query_list = ["交叉验证的作用"]
para_list = ["交叉验证(Cross-validation)主要用于建模应用中,例如PCR 、PLS回归建模中。在给定的建模样本中,拿出大部分样本进行建模型,留小部分样本用刚建立的模型进行预报,并求这小部分样本的预报误差,记录它们的平方加和。"]
title_list = ["交叉验证的介绍"]

# load model - RocketQA中文检索模型(de),在DuReader数据集中训练得到
dual_encoder = rocketqa.load_model(model="zh_dureader_de_v2") # for cpu
# dual_encoder = rocketqa.load_model(model="v1_marco_de", use_cuda=True, device_id=0, batch_size=16) # for gpu

# encode query & para
q_embs = dual_encoder.encode_query(query=query_list)
p_embs = dual_encoder.encode_para(para=para_list, title=title_list)


# compute dot product of query representation and para representation
dot_products = dual_encoder.matching(query=query_list, title=title_list, para=para_list)
print (dot_products)
3、搭建自己的检索式问答系统
A. 搭建问答系统的流程

如上图,问答系统分为离线和在线两个部分。
离线部分,需要将待检索的文档转成向量,并建立向量索引。
在线部分,需要将查询语句转成向量,用向量从索引中检索相关内容(通常返回不止一条结果),再对相关内容进行更精细的排序,得到最佳答案。
为了方便开发者使用,本项目提供了搭建问答系统的简单样例。
B. 使用Faiss搭建自己的问答系统
第一步:安装依赖
pip install faiss-cpu==1.5.3
git clone https://github.com/PaddlePaddle/RocketQA.git
cd RocketQA/examples/faiss_example/
第二步:准备数据
按如下格式准备候选文档:
每一行是一条文档数据,包含文档标题和文档内容,标题与内容用\t分隔。如果没有标题,可用空字符串或'-'代替
例如:
广西壮族自治区新型冠状病毒感染的肺炎 \t 感谢社会各界对我区抗击新型冠状病毒感染的肺炎疫情所给予的关心和大力支持!...
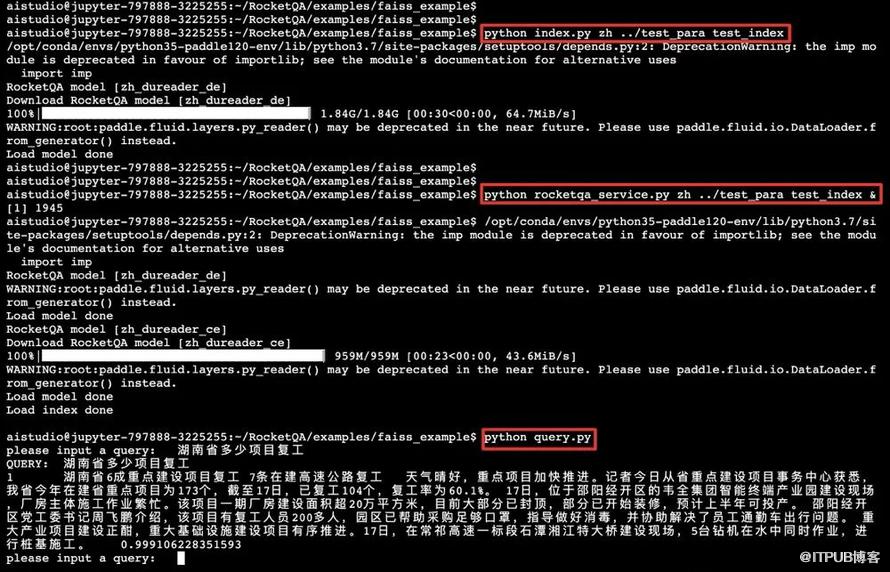
第三步:建索引并启动检索服务
# 建立索引库
python index.py zh ${your_data} ${index_name}

# 启动检索服务
python rocketqa_service.py zh ${your_data} ${index_name} &
第四步:检索
python request.py
运行结果见下图:
C. 使用Jina搭建自己的问答系统
Jina是基于深度学习模型搭建搜索引擎的开源框架,将RocketQA模型嵌入Jina框架能更加便捷的搭建检索式问答系统。具体步骤如下:
第一步:安装依赖
git clone https://github.com/PaddlePaddle/RocketQA.git
cd RocketQA/examples/jina_example
pip install -r requirements.txt
第二步:准备数据
按如下格式准备候选文档:
每一行是一条文档数据,包含文档标题和文档内容,标题与内容用\t分隔。如果没有标题,可用空字符串或'-'代替
例如:
广西壮族自治区新型冠状病毒感染的肺炎 \t 感谢社会各界对我区抗击新型冠状病毒感染的肺炎疫情所给予的关心和大力支持!...
第三步:建索引并启动检索服务
python rocketqa_jina.py index ${your_data}
第四步:检索
python rocketqa_jina.py query_cli
4、训练自己的模型
第一步:训练模型
import rocketqa

# 加载初始化模型
cross_encoder = rocketqa.load_model(model="zh_dureader_ce", use_cuda=False)
# cross_encoder = rocketqa.load_model(model="zh_dureader_ce", use_cuda=True, device_id=0, batch_size=32)

# 基于初始化模型,用自己的数据finetune。finetune模型的参数与初始化模型一致,相关配置文件可以在初始化模型的地址找到(~/.rocketqa/zh_dureader_ce)。建议用GPU机器
cross_encoder.train('./RocketQA/examples/data/cross.train.tsv', 2, 'ce_models', save_steps=1000, learning_rate=1e-5, log_folder='log_ce')
第二步:加载训练模型
import rocketqa

# 加载自己训练的模型,模型地址及相关配置写在config.json中
cross_encoder = rocketqa.load_model(model="./examples/ce_models/config.json", use_cuda=True, device_id=0, batch_size=16)
其中config.json的格式如下:
{
"model_type": "cross_encoder",
"max_seq_len": 384,                  # 与训练时的设置保持一致
"model_conf_path": "zh_config.json", # 与训练(初始化模型)保持一致,文件可以在初始化模型的地址找到(~/.rocketqa/{初始化模型})
"model_vocab_path": "zh_vocab.txt",  # 与训练(初始化模型)保持一致,文件可以在初始化模型的地址找到(~/.rocketqa/{初始化模型})
"model_checkpoint_path": ${YOUR_MODEL}, # 模型地址
"for_cn": true,                      # 中文设置为true,英文为false
"share_parameter": 0                 # 若初始化模型为pair系列模型,则设置为1;否则为0
}
原文作者:ArronAI;如有侵权,请联系管理员删除。

最新文章
- LLM之RAG实战(四十三)| 使用模型监控pipeline构建端到端RAG Pipeline
- MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL
- MLLM(一)| 文/图生视频任务大升级,BigModel 开源了视频模型CogVideoX
- LLM之RAG理论(十二)| RAG和Graph RAG对比
- LLM之RAG实战(四十二)| 如何在LlamaIndex和LangChain中正确选择RAG开发框架
- LLM之Prompt(四)| OpenAI、微软发布Prompt技术报告
- LLM漫谈(七)| 使用PyTorch从零构建LLM
- LLM之RAG实战(四十)| 使用LangChain SQL Agent和MySQL搭建多层RAG ChatBot
- LLM之RAG实战(三十九)| 高级RAG技术全面解析(附代码)
- LLM之RAG理论(十一)| 面向生产的RAG应用程序的12种调整策略指南
