引言
随着数据规模及复杂度呈指数级攀升,企业面临传统数据存储和分析架构难以为继的挑战。在这一背景下,湖仓一体化应运而生,作为大数据技术发展的新趋势,它为企业提供了更灵活、高效的数据管理方案。本文将深入探讨湖仓一体化的概念以及其广泛的应用场景。
湖仓一体化的定义
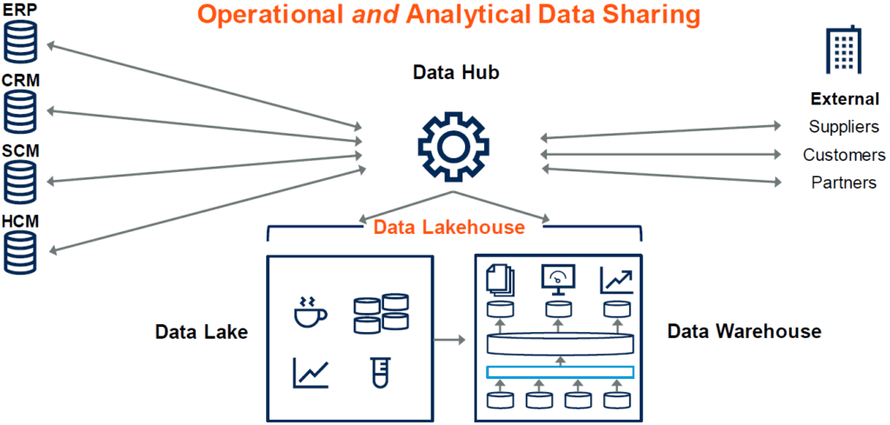
湖仓一体化(Lakehouse)是一种新型开放式架构,它将数据湖和数据仓库的优势充分结合,构建在数据湖低成本的数据存储架构之上,同时继承了数据仓库的数据处理和管理功能,打通数据湖和数据仓库两套体系,让数据和计算在湖和仓之间自由流动。
简而言之,湖仓一体化不是简单地将“数据湖”和“数据仓库”拼接在一起,而是一种全新的数据管理模式,将数据仓库构建在数据湖之上,有效简化了企业数据的基础架构,提升数据存储弹性和质量的同时还能降低成本,减小数据冗余 。
湖仓一体化的关键特性
湖仓一体化具有以下核心特性 :
- 事务支持:支持 ACID 事务,确保数据并发访问的一致性与正确性。
- 模式实施和数据治理:支持各类数据模型的实现和转变,具有健全的治理和审计机制。
- BI 支持:可直接在源数据上使用 BI 工具,提升分析效率、降低数据延时。
- 存储与计算分离:采取存算分离架构,能够根据业务需求动态扩缩容。
- 开放性与兼容性:提供丰富的 API 支持,采用开放、标准化的存储格式。
- 支持多种数据类型:可存储、优化、分析和访问结构化、半结构化和非结构化数据。
- 支持各种工作负载:包括数据科学、机器学习、SQL 查询、分析等多种计算场景。
- 端到端流式任务:支持实时报告和流式处理,消除对专门服务实时数据应用的单独系统需求。

湖仓一体化的应用场景
1. 在线数据抽取场景
传统模式中,业务常从线上 MySQL 库表以离线方式抽取全量数据到 Hive 表,这种方式存在诸多痛点:每天全量查询消耗大量资源,业务 MySQL 库压力大;抽取任务延迟高导致下游无法及时获取数据;分库分表维护成本高等。
湖仓一体可通过准实时入湖方式解决这些问题:
- 链路更加稳定,减少线上库集群压力
- 效率提升,延迟较低,提升数据时效性
- 大大降低维护成本,只需维护较少离线任务
- 业务扩展:一份存储多种用途,方便扩展到准实时场景
2. 部分列更新场景
原有 Flink 多流实时 join 场景中,多个指标数据进行关联时可能出现时间差较大的异常情况,且维持大状态会给内存带来压力。湖仓一体方案可将原有计算侧 join 改为存储侧自动处理,通过 Hudi 的自定义 payload 策略实现高效稳定的关联处理。
3. 与 AI 结合的机器学习场景
面对数据应用场景的持续扩展,企业对底层数据平台提出更高的敏捷性、易用性、实时性和智能化要求。湖仓一体通过对机器学习和 AI 算法的支持,构建数据湖+数据仓库的闭环,配合上层多样化的计算生态,帮助企业实现大数据能力的提升。
4. 分布式多级数据湖场景
随着企业发展,产生的不同业务库、数据仓库和数据湖形成了数据孤岛。湖仓一体平台可打破这些孤岛,实现数据联动和统一分析,无需数据搬迁就能实现快速分析。同时,通过多租户、数据权限和资源隔离等机制保障数据安全,满足大型央国企和金融客户的多湖多租户需求。
5. 数据中台的实时数仓场景
在数据中台中,对数据库的分析处理过程提出了事务一致性要求,同时需要保持低延迟和提升实时处理能力,湖仓一体技术能够针对这些需求提供支持。
湖仓一体架构的典型应用场景包括
“在线数据抽取场景”和“
数据中台的实时数仓场景”,StarRocks 作为一款湖仓分析引擎,可以增强湖仓一体的实时数据处理能力。StarRocks 可以在这些场景中发挥作用:
- 湖仓一体需要处理准实时入湖和低延迟数据访问的需求
- StarRocks 的计算节点设计支持弹性扩展,可以根据负载情况灵活添加或移除节点
- StarRocks 提供灵活的缓存机制,可根据实际情况优化查询性能,特别适合需要快速响应的场景
实施建议:在构建湖仓一体架构时,可利用 StarRocks 的计算节点和缓存机制,为实时数据分析场景提供支持,尤其是对于需要低延迟查询响应的业务场景,StarRocks 的弹性计算能力可以有效满足这一需求。
湖仓一体化的核心优势
- 统一的数据管理:提供完善的数据管理能力,包括数据源、连接、格式、Schema 以及权限管理 。
- 多模态的存储引擎:内置多模态存储引擎,满足不同应用对数据访问的需求,提供可插拔式存储框架 。
- 丰富的计算引擎:提供从批处理、流式计算、交互式分析到机器学习等各类计算引擎 。
- 数据全生命周期管理:对数据的全生命周期进行管理,包括数据的定义、接入、存储、处理、分析、应用的全过程 。
- 批流融合:在表格式层统一 流和批表,实现存储资源节省,通过 CDC 能力实现从数据入湖、湖内建仓整个数据链路的批流融合 。
- 降本增效:简化数据架构,减少数据重复建设和移动,提高资源利用率 。
湖仓一体化实践应用案例
1. 腾讯微信:StarRocks + Iceberg 的实时湖仓融合
微信在视频号直播、微信键盘等业务中构建湖仓一体架构,将实时数据写入 Iceberg 表,并通过 StarRocks 直接查询 Iceberg 数据,实现准实时分析。数据冷热分层管理:热数据实时接入 StarRocks 数仓,冷数据存储在 Iceberg 数据湖中,通过 Meta Server 统一元数据管理,支持跨源联邦查询,无需 ETL 即可分析湖中数据。
-
核心技术:
- 外表物化视图:通过 StarRocks 外表直接关联 Iceberg 表,实现湖仓数据的透明加速查询。
- Iceberg Routine Load:支持 Iceberg 数据的分钟级增量刷新,优化资源利用和实时性。
-
成效:
- 集群规模达数百台机器,数据接入量近千亿。
- 直播业务场景中,数据开发任务数减半,存储成本降低 65% 以上,离线任务产出时间缩短 2 小时。
2. 同程旅行:StarRocks + Paimon 的流批一体湖仓
同程旅行通过 Paimon 实现流式数仓升级,覆盖 ODS 层(原始数据入湖)、DWD 层(数据清洗与打宽)、DWS 层(聚合计算)和 ADS 层(分析查询),并借助 StarRocks 作为核心查询引擎,支持分钟级延迟的高效分析。数据存储依托 Paimon,计算由 Flink 引擎完成,支持流批一体处理。
-
核心技术:
- Paimon 特性:主键表支持高效实时更新,Partial Update 技术优化订单处理,Time Travel 实现历史数据回溯。
- StarRocks 外表查询:通过 Paimon Catalog 直接查询外部表,结合 Data Cache 缓存热数据,TPCH 10G 数据集查询性能较 Trino 提升 4-10 倍。
-
成效:
- ODS 层同步任务资源消耗减少 30%,写入效率提升 3 倍,存储总量达 600TB。
- 替换原有 Hudi 表后,点查场景性能显著优化,并实现全量 Hudi 表下线。
StarRocks + Iceberg 更适用于冷热数据分层、联邦查询场景,强调存储成本与实时分析的平衡。
StarRocks + Paimon 则聚焦流批一体和实时更新场景,适合需要高写入效率和灵活查询的业务。两者均通过湖仓融合实现了存储与计算的解耦,显著降低运维复杂度并提升性能。
结语
总体趋势表明,湖仓一体将在未来的数据分析中发挥关键作用,预测表明,到 2025 年, 超过一半的分析工作负载将在湖仓一体架构上运行。 这种转变是由成本节约、灵活性和开放数据格式的标准化推动的。
推荐阅读:领取 StarRocks Lakehouse 白皮书进一步学习
Gartner D&A 趋势:https://www.gartner.com/en/data-analytics/topics/data-trends
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70038017/viewspace-3082248/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从 StarRocks 到 MIP:数据平台的下一步是“理解”
- Semantic View技术解析(三):指标、关系与过滤规则如何约束查询结果
- Semantic View 技术解析(二):业务口径如何进入数据库执行路径
- 从单条 SQL 到完整任务:Agent 带来的五个数据负载变化
- 从 DBA 经验到 Agent:镜舟如何构建生产级智能排障体系
- 为什么 Text-to-SQL 总是停在 Demo?
- AI 能写 SQL,但它真的理解数据吗?镜舟 Semantic View 如何补齐语义缺口
- 一句话发起排障,镜舟 DevOps Agent 正式上线
- WAIC 2026 交卷时刻:Agent落地新标尺是什么?
- Databricks 再提 LTAP,AI 时代的数据底座为何重回大一统叙事?
