2026 年 10 月 20 日,镜舟科技举办线上产品发布会,正式发布企业级 AI 数据平台 MIP(MirrorShip Intelligence Platform)。
MIP 以高性能分析引擎为基础,将企业业务定义、上下文知识与 Data Agent 连接起来,支持企业在明确的数据范围和权限边界内,开展自然语言问数、数据探索、异常分析与报告交付。这也是镜舟产品战略的一次延伸:在实时分析能力之上,构建统一的数据分析与智能平台。
发布会上, 镜舟科技 CEO 孙文现、CTO 陈鹏、MIP 产品负责人董颖婷 分别介绍了产品方向、平台架构与实际使用方式。 阿里云开源 OLAP 团队、StarRocks TSC Member 周康,以及广州市海捷计算机科技有限公司大数据架构师李宝,进一步分享了多模态数据湖检索与企业数据平台演进的实践。
从生成回答,到按企业口径完成分析
“上季度收入是多少?”看似是一项简单的查询,但在企业内部,答案取决于一系列业务定义:采用什么收入口径,退货如何处理,跨期交易如何统计。同样,分析高价值会员流失,需要明确会员与订单、营销活动之间的关联,也需要先定义什么是“高价值”和“流失”。
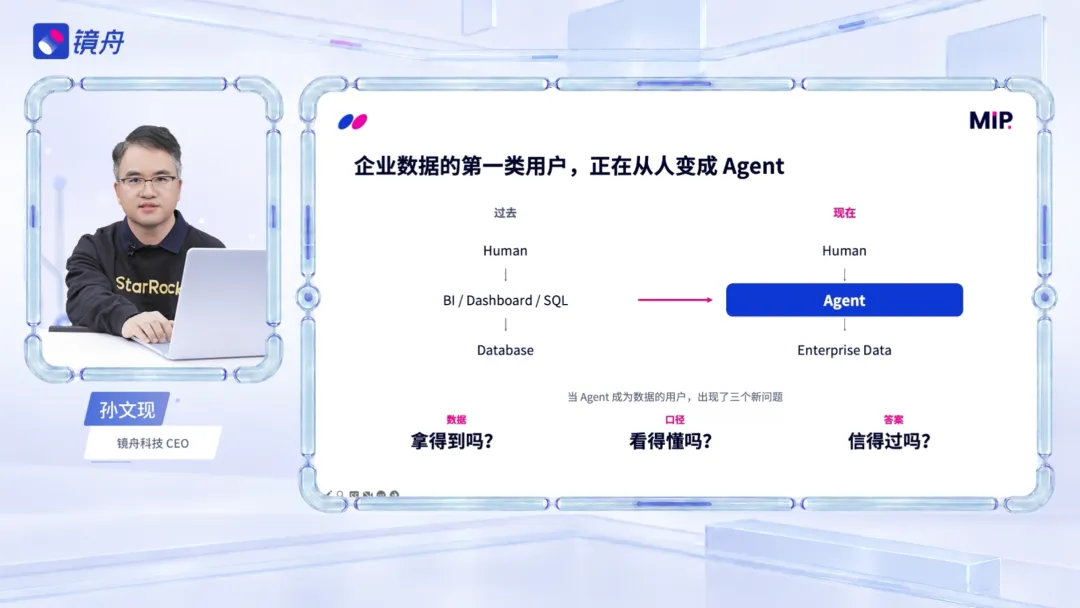
镜舟科技 CEO 孙文现 在分享中指出,大模型越来越擅长给出答案,但理解一家企业的数据,仍然需要真实数据、业务知识与明确的计算规则。对于经营分析,结果不仅要能生成,还要能够说明采用了什么口径、依据了哪些数据,以及结论如何得出。
与此同时,Agent 正在成为数据平台的新用户。与分析师手工编写少量 SQL 不同,Agent 可能将一个业务问题拆解为多步任务,连续发起查询、检索和关联分析。这要求数据平台不仅提供低延时、高并发的执行能力,也要让业务定义、访问权限与分析依据进入实际执行过程。
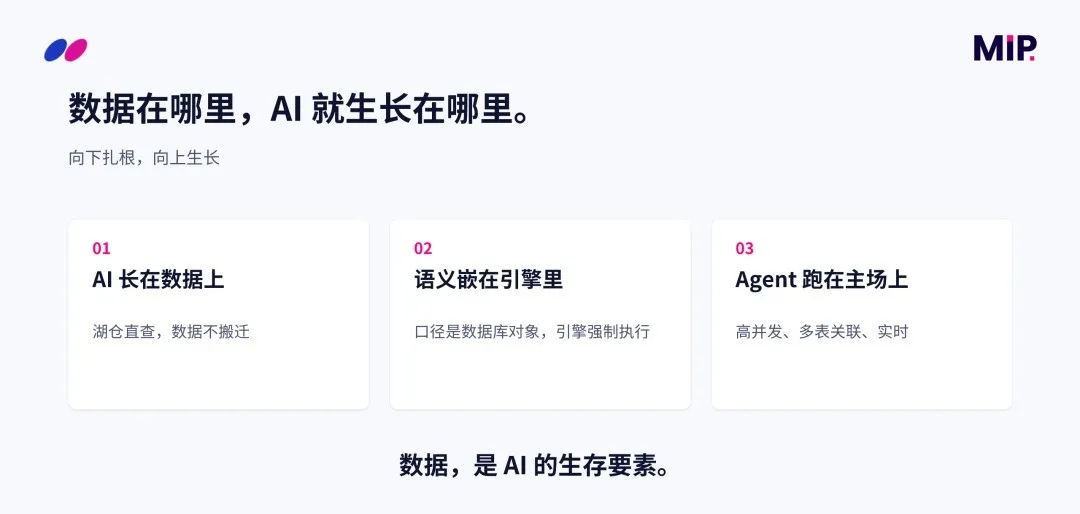
MIP 围绕这些要求,将数据查询、业务口径与分析过程连接起来。在数据能够被高效查询的基础上,进一步让 AI 按企业确认的定义使用数据,并使分析过程与结果可以核对、追溯。
三层架构,连接数据访问、业务理解与分析交付
MIP 的整体架构由 MirrorData、MirrorMind、MirrorPilot 三层组成,MirrorControl 贯穿其中,提供治理、安全、访问追踪与运维支撑。
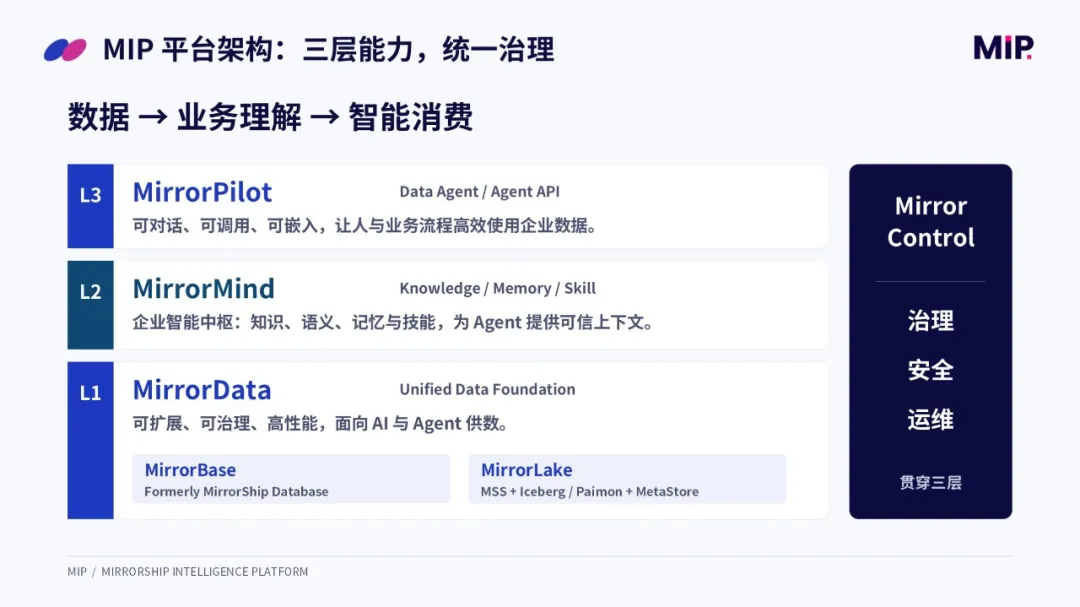
镜舟科技 CTO 陈鹏 在发布会上介绍,StarRocks 仍是 MIP 实时分析能力的重要技术基础。已有报表、应用分析和湖上查询可以继续获得更好的支持,新的 AI 分析需求则在同一平台架构上发展,减少重复建设多套分析体系的复杂度。
1. MirrorData:统一访问数据,缩短分析链路
MirrorData 是 MIP 的统一数据底座,由实时分析引擎 MirrorBase 与开放湖仓存储 MirrorLake 共同支撑。MirrorBase 主要基于 StarRocks,延续高并发、低延时的分析能力;MirrorLake 面向开放湖仓存储,结合对象存储、Iceberg、Paimon 等能力,支撑湖上数据与多模态数据的使用。
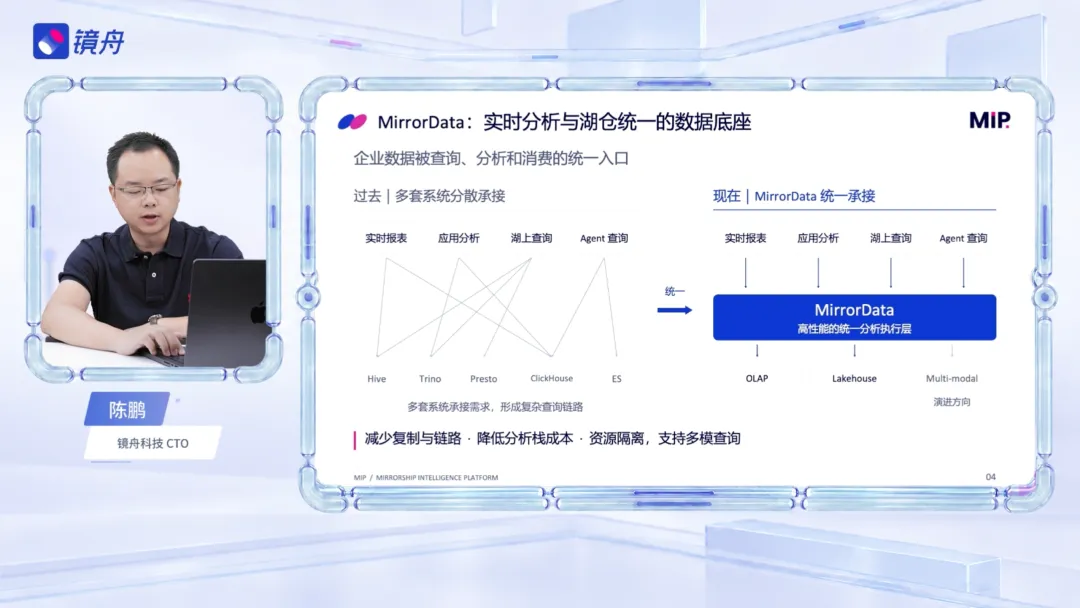
对于企业,统一数据底座的价值在于:实时报表、交互式分析、数据应用和 Agent 可以共用查询与计算能力,减少为不同应用重复复制数据、维护多套分析链路的工作。通过资源管控与隔离,平台也为 Agent 查询和既有业务负载并行运行提供支撑。
在数据访问上,MirrorData 支持内表与 Paimon、Iceberg、Hive 等湖表的统一接入;对于已有的非结构化文件,可以保留原始文件位置,将相关向量与索引纳入检索,并将检索结果继续用于关联分析。
2. MirrorMind:统一指标口径,减少反复沟通与核对
MirrorMind 是 MIP 的企业级语义层,由 Semantic View(语义视图)与 Knowledge Context(上下文知识)两部分组成。
Semantic View 定义指标、维度、表间关系与计算规则,回答“应该怎么算”,确保口径计算的准确性。企业可以明确一个指标使用哪些字段、采用什么统计粒度、在哪些时间窗口、允许按哪些维度分析,使业务定义成为查询生成与计算执行的依据,而不是让 Agent 每次自行推断。
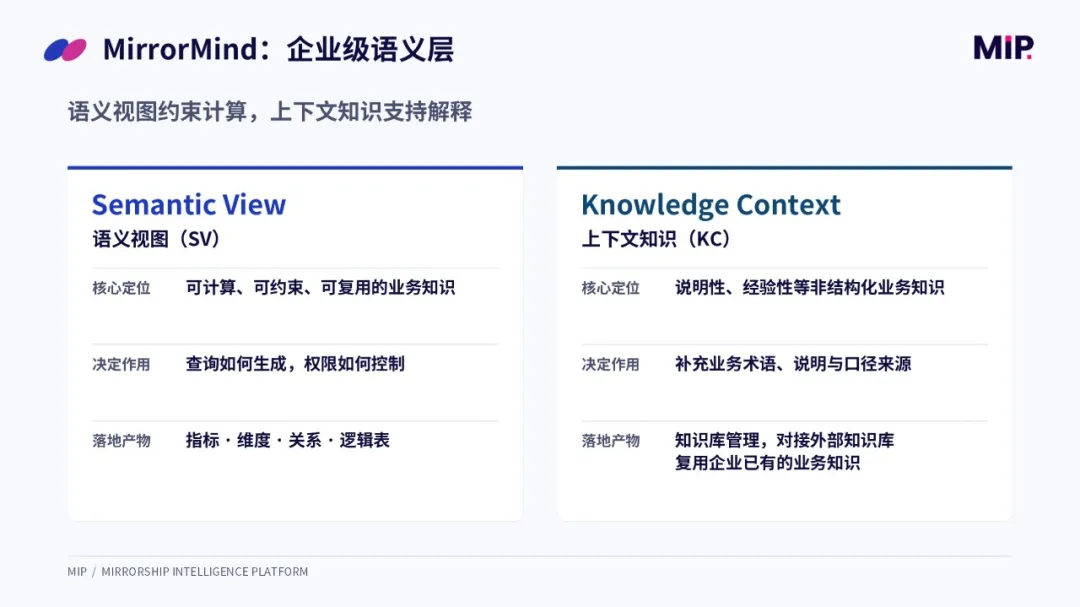
Knowledge Context 则补充“为什么这样算、应该怎样分析”,包括术语解释、口径来源、业务规则、内部文档和标准分析流程等,也可以连接企业已有的外部知识库。
针对业务知识持续变化的问题,MIP 提供类似 Git 的上下文版本管理方式,支持分支、版本回溯、冲突检测与访问控制。经过业务确认的版本再用于线上任务,让不同 Agent 能够复用同一套已确认的知识,减少重复整理和维护。Semantic View负责“算得准确”,Knowledge Context保证“解释清楚”,二者相互配合使用,让用户的AI / Agent对数据的访问获得精准结果并能得到合理准确的洞察分析。
3. MirrorPilot:融入现有系统,复用分析能力
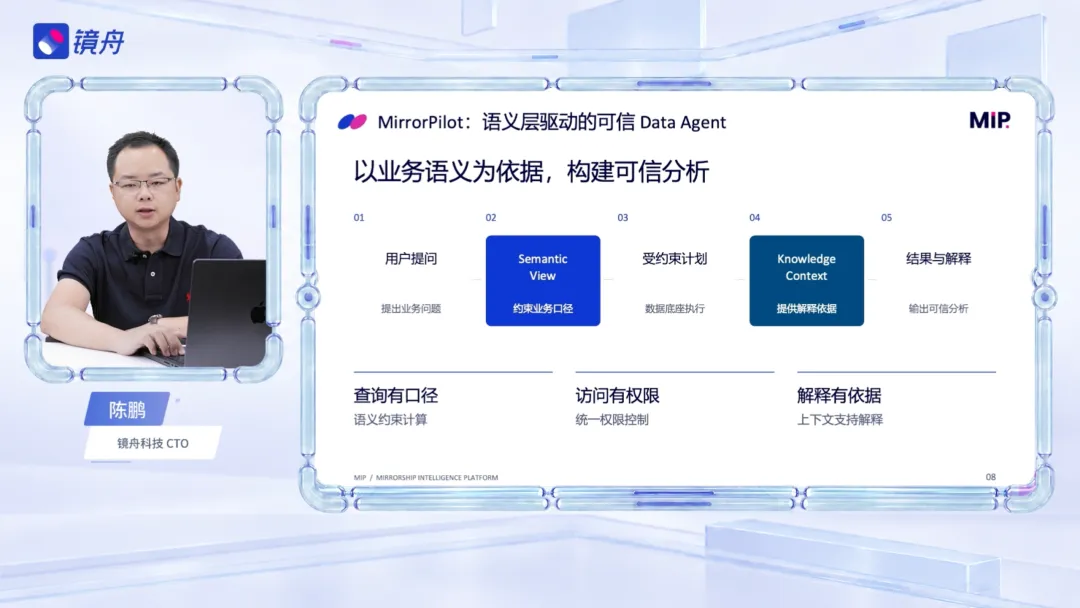
MirrorPilot 是语义层驱动的 Data Agent,也是 Agent 的运行与交付环境。用户提出问题后,Agent 结合相关上下文与 Skill 组织分析,调用 Semantic View 获取业务定义,由数据底座执行查询,再形成分析结果与解释。
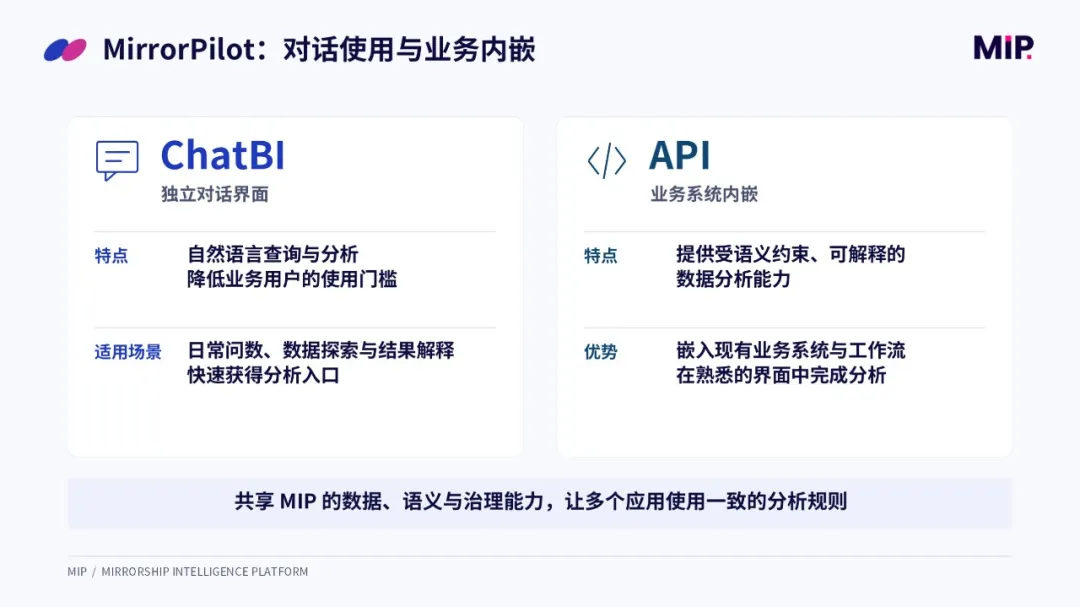
企业既可以通过独立的对话式入口开展日常问数、数据探索和追问,也可以通过我们提供的 API 将分析能力接入已有 BI、业务工作流或业务Agent。自定义 Skill 与 SQL 模板则用于复用已有分析方法,逐步扩展任务处理能力。
分析交付也不止于一段文字。MirrorPilot 可以呈现丰富的图标、灵活下钻、展示所用 SQL,并生成可导出的分析报告。执行过程中保留指标、时间范围、计算规则与查询记录,便于业务人员核对答案,并继续追问。
此外,伴随 MIP 的发布,我们会同步发布面向数据平台人员的 DevOps Agent,提供 MirrorData 的智能调优、智能巡检以及智能运维能力。
产品演示:让结论有依据,让分析可追溯
发布会上, 镜舟科技 MIP 产品负责人董颖婷 通过具体演示,展示了数据底座、业务语义与 Agent 如何协同工作。
1. 一张售后图片,结合文本与业务条件完成检索
在模拟售后场景中,用户上传一张破损图片,系统生成向量后检索相似记录,再结合日期范围、破损描述等条件缩小结果集。
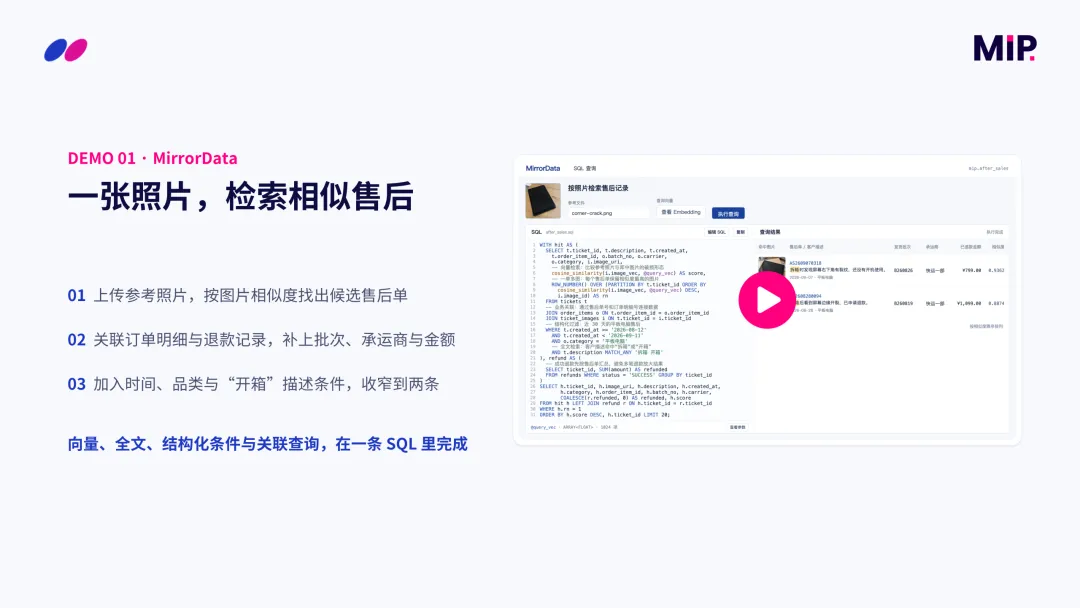
这一演示将向量相似度、文本检索与结构化过滤放在一条 SQL 中完成,说明多模态检索不必止于“找到相似图片”,也可以与业务条件共同参与查询,为后续分析提供数据。
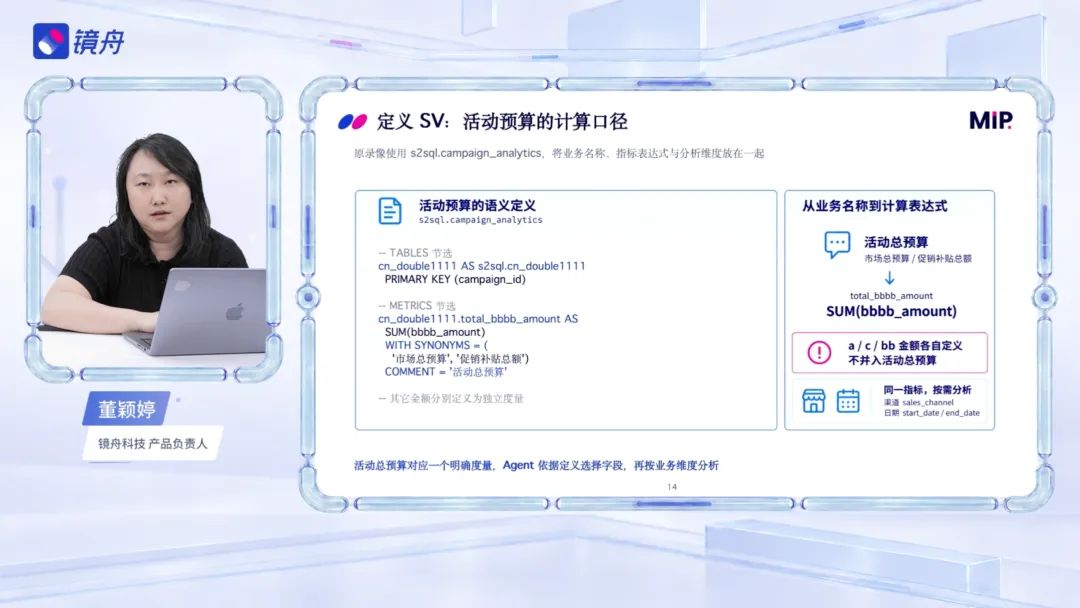
2. 同一个预算问题,先明确指标再计算
在另一项对比演示中,面对“公司的活动总预算是多少”这一问题,直接查询底表的 Agent 将多个不相关的金额字段一并求和,得到了错误结果。
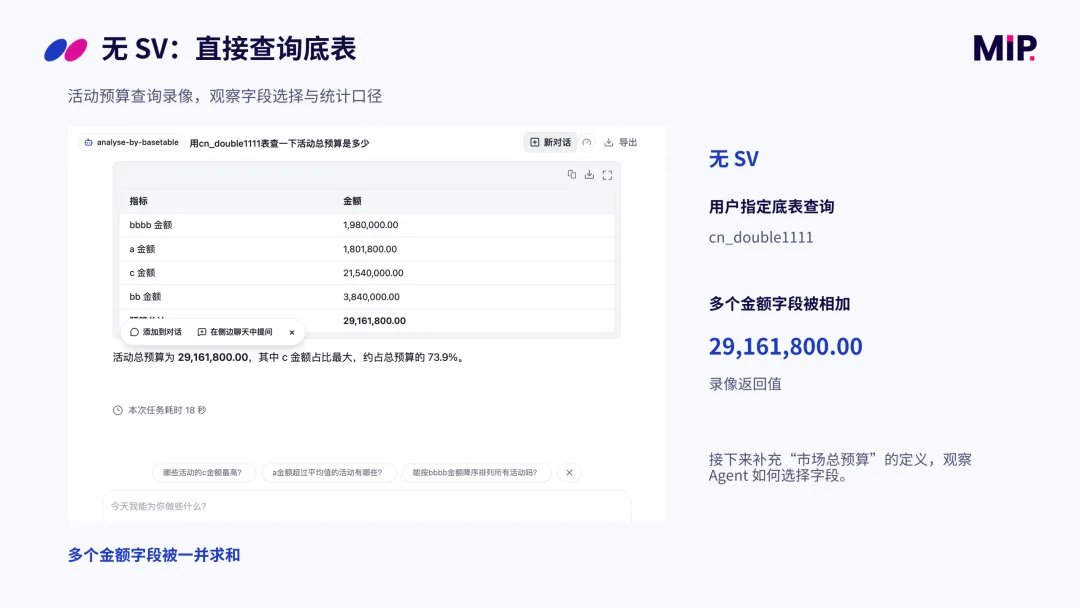
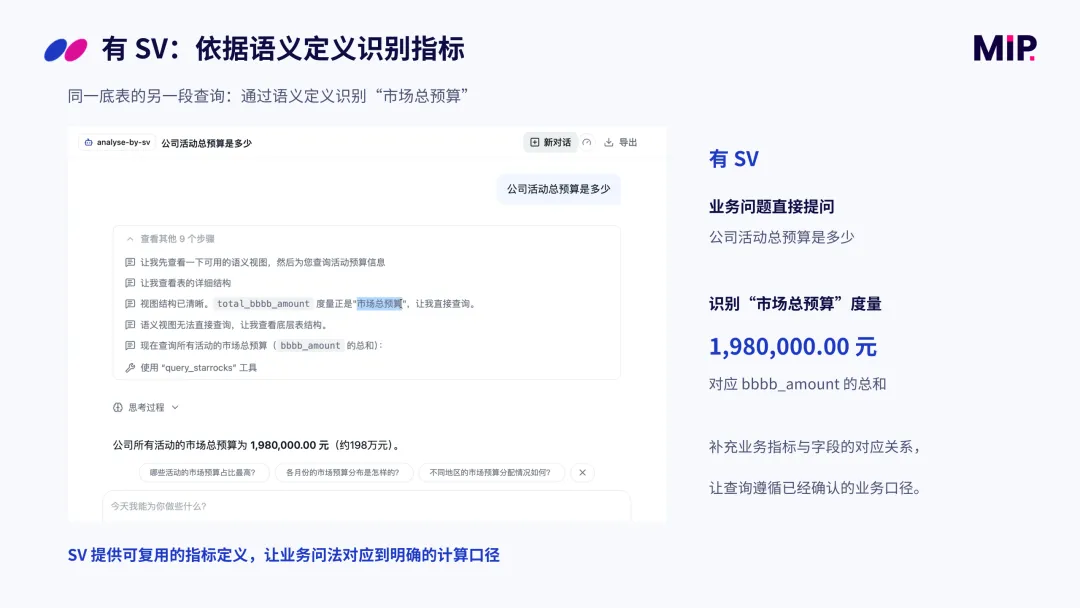
引入 Semantic View 后,系统先匹配已定义的预算指标,明确应使用的字段与汇总方式,再执行查询。演示说明,SQL 能够执行,并不意味着计算符合业务要求;企业指标需要先有明确的定义,再由 Agent 使用。
3. 从销售拆分、异常追问,到生成分析报告
以零售客户的经营分析场景为例,董颖婷展示了 Agent 从配置到使用的完整流程:先限定数据范围、Semantic View、知识库与 Skill,再由用户通过自然语言提问,按渠道拆分销售表现,并进一步追问订单取消率是否异常、变化原因是什么。
在追问过程中,Agent 调用企业已有的异常判断规则与分析 SOP,继续下钻分析,展示相关查询与分析依据,最后生成包含图表和分析过程总结的 HTML 报告。用户不仅能看到结论,也能查看所用指标、时间范围和 SQL。
从检索实践,看企业数据平台如何服务 Agent
除了 MIP 产品演示,发布会讨论了数据平台向 AI 场景演进的实际要求。
阿里云开源 OLAP 团队、StarRocks TSC Member 周康 结合 StarRocks 与 Paimon,介绍了多模态数据从存储、检索到关联分析的完整链路:原始图片、视频等对象保留在对象存储中,提取出的文本、标签与向量围绕样本建立关联,再通过结构化过滤、全文检索和向量检索找到相关内容,继续关联业务记录开展分析。
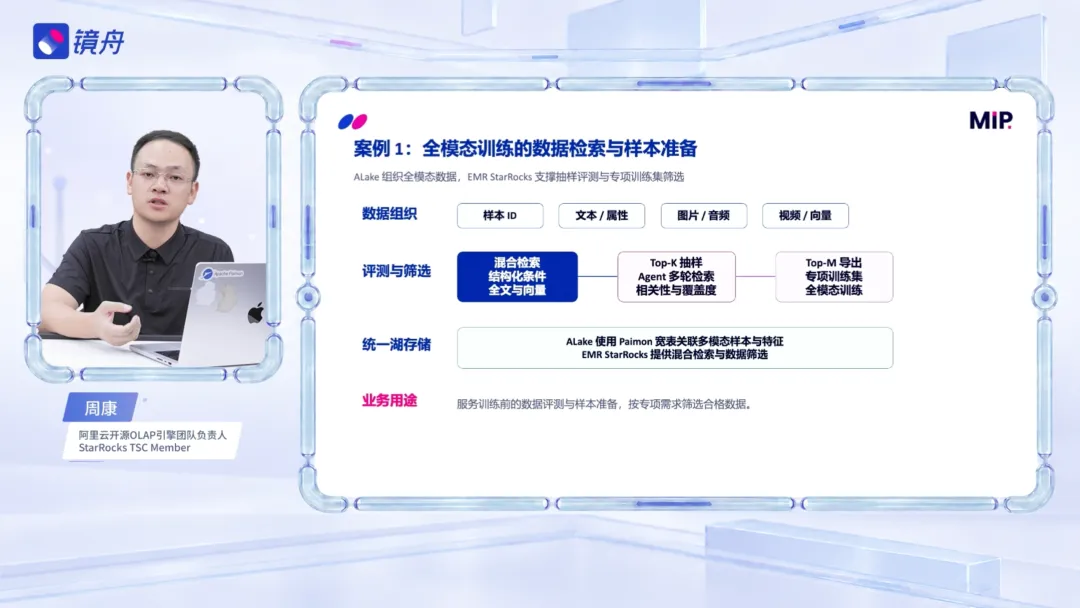
在其分享的阿里集团 A Lake 实践中,Paimon 宽表用于关联多模态样本与特征,阿里云 EMR StarRocks 提供混合检索与数据筛选,服务于模型训练前的样本准备。在智能驾驶场景中,检索还需要与车型、模型版本、评测记录等信息关联,帮助工程师定位问题、寻找相似样本,并判断现有数据是否覆盖目标场景。
这些实践也明确了技术分工:数据平台负责样本组织、检索与分析,采集、标注、训练和部署平台共同完成后续流程。
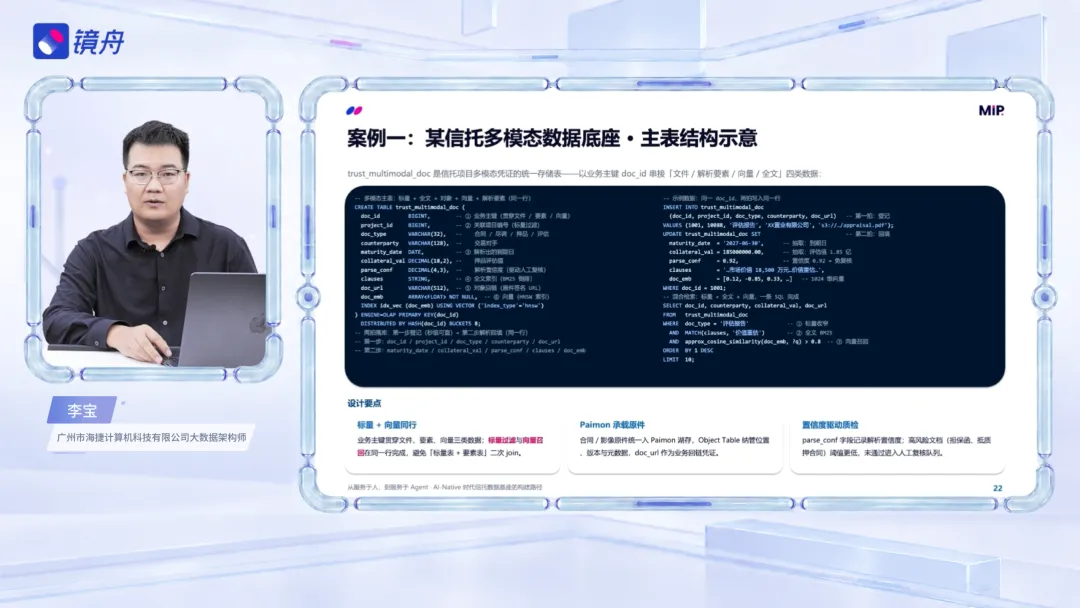
广州市海捷计算机科技有限公司大数据架构师李宝 则结合金融信托业务需求,讨论了数据平台如何从服务报表使用者,走向同时服务业务人员与 Agent。合同、尽调报告、抵质押影像等非结构化资料,需要与交易、账户、经营指标建立关联;看板刷新、监管跑批和智能问数等负载,也需要统筹考虑资源与执行能力。
这一演进并非推翻已有数仓与湖仓,而是在原有数据资产上继续建设:让业务口径由语义层统一管理,让非结构化资料进入可检索、可分析的范围,并为 Agent 的高频访问提供支撑。
让企业的数据投入更直接地服务业务
对于企业,AI 分析的落地不只是接入模型,更涉及数据范围、业务定义、知识维护、访问权限与结果验证。
MIP 并不以无边界地回答所有问题为目标。孙文现强调,可靠的企业 AI 分析,需要建立在可信的数据域与业务语义之上,并保留人的反馈和修正。
企业可以围绕具体分析任务,先明确数据范围与指标定义,再配置相关业务知识和分析流程,通过实际查询与业务反馈验证效果,逐步扩展应用范围。这也使已有数据基础设施、业务规则与分析经验能够继续服务新的 AI 应用。
从实时分析到湖仓统一,再到连接数据、业务语义与 Data Agent,MIP 延续的是同一条产品主线:让企业的数据投入更直接地服务业务。在 AI 成为数据新用户之后,这一目标进一步落在可执行的业务定义、可控的数据访问,以及可核对的分析过程上。
发布会完整回放整理中:https://mirrorship.ai/zh/events/mip-launch
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70038017/viewspace-3186337/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 镜舟科技 CTO 陈鹏:从实时分析到统一的数据分析与智能平台
- 从 StarRocks 到 MIP:数据平台的下一步是“理解”
- Semantic View技术解析(三):指标、关系与过滤规则如何约束查询结果
- Semantic View 技术解析(二):业务口径如何进入数据库执行路径
- 从单条 SQL 到完整任务:Agent 带来的五个数据负载变化
- 从 DBA 经验到 Agent:镜舟如何构建生产级智能排障体系
- 为什么 Text-to-SQL 总是停在 Demo?
- AI 能写 SQL,但它真的理解数据吗?镜舟 Semantic View 如何补齐语义缺口
- 一句话发起排障,镜舟 DevOps Agent 正式上线
- WAIC 2026 交卷时刻:Agent落地新标尺是什么?
