在当今数据驱动的业务环境中,选择合适的数据库架构已成为企业技术决策的关键。然而,面对事务型数据库和分析型数据库的选择,许多技术团队往往陷入困境:日常运行良好的系统在数据量激增时性能骤降,简单的查询在复杂分析场景下变得异常缓慢。这些问题的根源往往在于对两类数据库本质差异的理解不足。
本文将深入剖析这两类数据库的核心区别,并提供一个实用的选型决策框架,帮助您在特定业务场景下做出最优选择。
一、基础认知:两类数据库的本质区别

1. 事务型数据库的核心特征
事务型数据库(如 MySQL、Oracle、SQL Server)设计之初就是为了支持事务处理场景。它采用行式存储结构,将一行数据作为基本操作单元,这种设计使得单条记录的增删改查操作非常高效。
事务型数据库的核心特征包括:
- 行式存储结构:数据按行连续存储,适合处理完整记录
- ACID 事务支持:确保数据一致性和可靠性
- 严格的数据一致性模型:通过锁机制和事务隔离级别保证数据准确性
- 适合高频率、小批量的数据操作:如订单创建、用户注册等
2. 分析型数据库的设计理念
分析型数据库(如 ClickHouse、Greenplum、StarRocks)则采用完全不同的设计理念。它专为复杂的数据分析和报表查询而生,核心是列式存储结构,将同一列的数据物理上存储在一起。
分析型数据库的关键特点:
- 列式存储结构:同一列数据物理相邻,便于大规模聚合计算
- 高并发查询能力:能同时处理数百甚至数千个复杂查询
- 面向大数据量分析:轻松处理 TB 甚至 PB 级数据集
- 优化的压缩算法:同质数据集中存储带来更高的压缩比
3. 典型应用场景对比
两类数据库的设计差异直接决定了它们的最佳应用场景:
OLTP(联机事务处理)场景:
- 电商交易系统
- 银行账户管理
- CRM 客户关系管理
- 实时库存管理
OLAP(联机分析处理)场景:
- 用户行为分析
- 销售趋势报表
- 大规模数据挖掘
- 商业智能分析
二、关键差异点解析
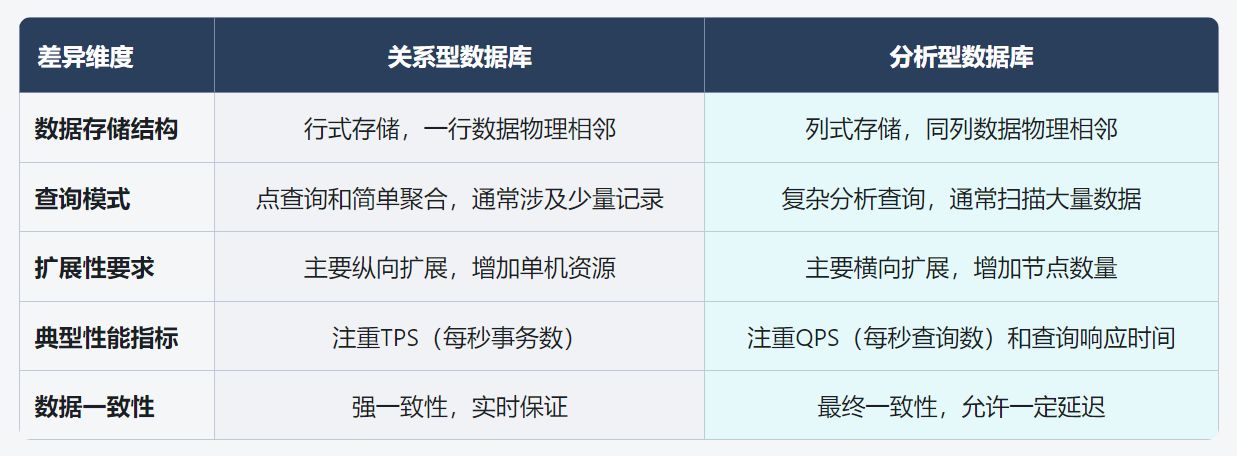
1. 数据存储结构差异
行式存储和列式存储的物理实现差异是两类数据库最根本的区别:
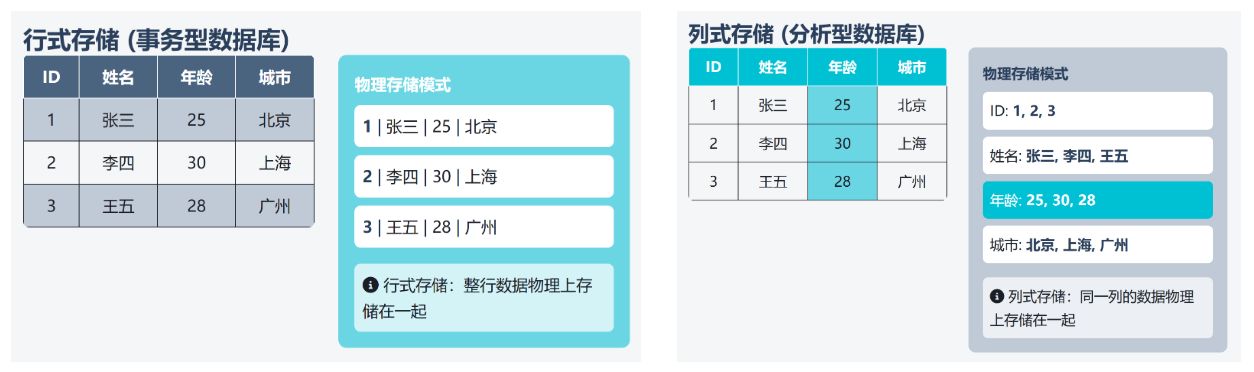
行式存储: 在事务型数据库中,表的每一行数据被存储在一起。当需要访问一条完整记录时,这种结构非常高效。例如,查询"用户 ID 为 10001 的客户信息"时,只需一次磁盘 IO 就能获取该用户的所有字段。
行式存储适用场景:当查询模式主要是基于主键或索引的单条记录操作时,行存储结构效率最高。
列式存储: 分析型数据库将同一列的所有值存储在一起。这种结构在需要聚合计算时优势明显。例如,计算"所有用户的平均年龄"时,只需读取年龄列的数据,而不必加载其他无关字段,大幅减少 IO 开销。
列式存储适用场景:当查询只涉及表中的少数几列,但需要处理大量行时,列存储结构效率最高。
2. 查询模式对比
 两类数据库针对不同的查询模式进行了优化:
事务型操作: 事务型数据库擅长处理高频率、小批量的数据操作,如单条记录的增删改查。它们通过索引、缓存和事务机制保证这类操作的高效执行。
复杂分析查询: 分析型数据库针对涉及大量数据的复杂聚合查询进行了优化。它们通常采用向量化执行、并行计算等技术,能够高效处理"按地区统计过去一年的销售额"等复杂分析需求。
3. 扩展性要求
 面对数据量增长,两类数据库采用不同的扩展策略:
纵向扩展: 事务型数据库主要通过增加单机资源(CPU、内存、存储)来提升性能,这种方式简单直接,但存在物理上限。
横向扩展: 分析型数据库通常采用分布式架构,通过增加节点数量来线性提升性能和容量。这种方式理论上可以无限扩展,但增加了系统复杂度。
4. 典型性能指标
 两类数据库关注的核心性能指标也有明显差异:
TPS(每秒事务数): 事务型数据库重点关注系统每秒能处理的事务数量,这直接关系到业务系统的并发处理能力。
QPS(每秒查询数)和查询响应时间: 分析型数据库更关注复杂查询的执行效率和系统的并发查询能力,尤其是在大数据量下的表现。
三、选型决策框架:5 个关键评估维度
选择合适的数据库架构需要综合考虑多个因素。以下是一个实用的决策框架,包含 5 个关键评估维度:

1. 数据规模边界判断
TB 级以下数据: 对于数据总量在数 TB 以下的应用场景,事务型数据库通常能够胜任。现代事务型数据库通过优化可以处理相当规模的数据集。
PB 级数据: 当数据规模达到 PB 级别,分析型数据库的优势开始显现。它们的列式存储和分布式架构能够更有效地管理海量数据。
2. 查询复杂度评估
简单 CRUD 操作: 如果系统主要执行简单的增删改查操作,事务型数据库是更合适的选择。
多表关联分析: 对于需要频繁执行复杂 JOIN、聚合计算的场景,分析型数据库能提供更好的性能。特别是当这些查询涉及大量历史数据时,差距更为明显。
3. 实时性要求分级
毫秒级响应: 对于需要毫秒级响应的交易系统,事务型数据库的行存储结构更有优势。
分钟级延迟: 如果业务可以接受分钟级的数据延迟,分析型数据库的批处理模式能够提供更高的吞吐量和更优的资源利用率。
4. 并发压力测试预期
百级并发: 对于并发用户数在数百级别的系统,事务型数据库通常能够提供良好的性能。
万级并发: 当系统需要支持数千甚至数万用户同时执行复杂查询时,分析型数据库的并行处理能力显得尤为重要。
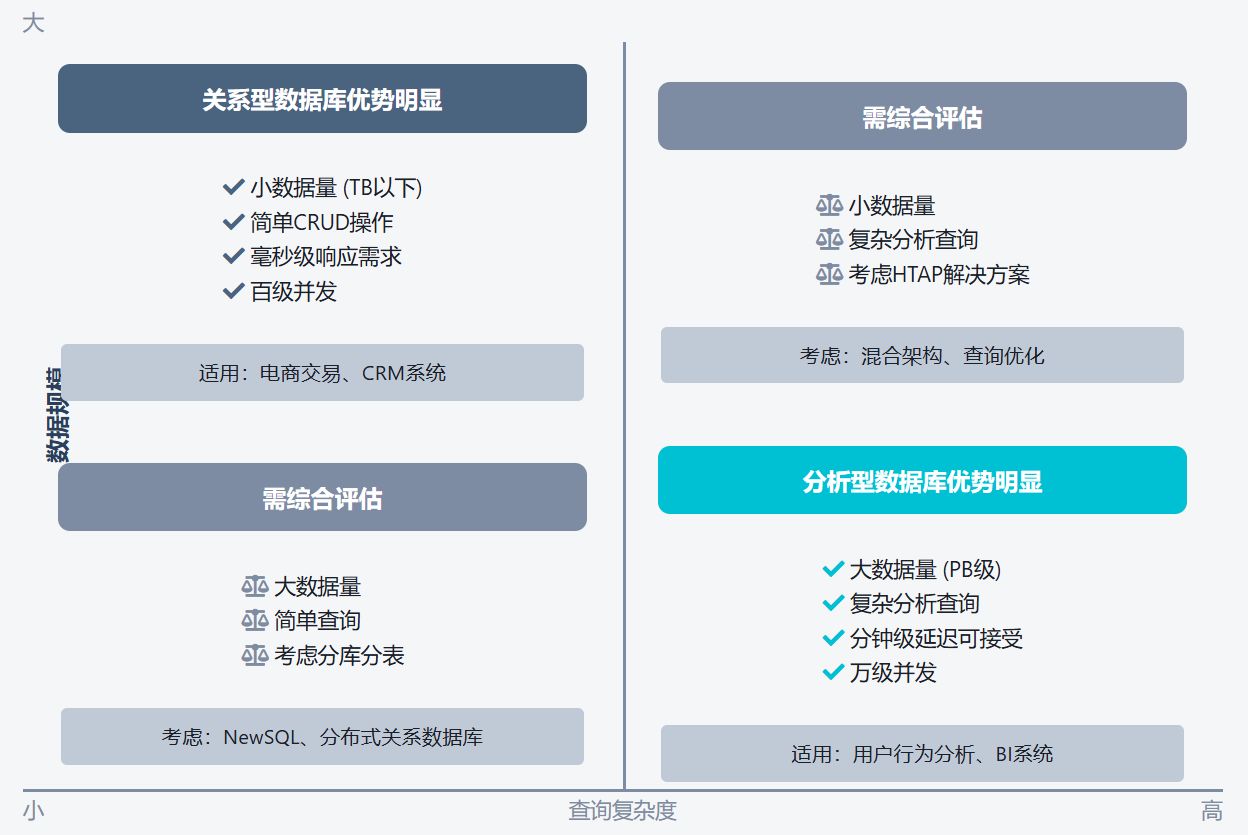
5. 混合负载处理能力验证
在实际应用中,许多系统同时存在事务处理和数据分析需求。评估数据库处理混合负载的能力至关重要:
- 事务型数据库在处理分析查询时可能会影响事务性能
- 分析型数据库可能不具备完整的事务支持
- 需要考虑是否采用混合架构或 HTAP 解决方案
四、典型场景与选型建议
1. 电商交易系统选型建议
电商交易系统需要处理高并发的订单创建、支付处理和库存管理,对数据一致性和实时性要求极高。
推荐方案:以事务型数据库为主,可考虑:
- 主系统使用 MySQL/PostgreSQL 处理交易数据
- 读写分离减轻主库压力
- 分库分表应对数据增长
- 定期将历史数据归档至分析型数据库
2. 用户行为分析平台架构
用户行为分析平台需要处理海量的点击流、浏览记录和转化数据,查询模式以复杂的多维分析为主。
推荐方案:分析型数据库优先,可考虑:
- 使用 StarRocks 作为核心分析引擎
- 采用流处理技术实现准实时数据接入
- 预计算常用指标提升查询性能
- 实现智能的数据生命周期管理
案例:七猫人群圈选系统
七猫通过 StarRocks 构建了强大的用户增长引擎,解决了用户标签更新带来的数据分析连续性问题。面对 5 亿用户、150 亿指标数据的挑战,七猫采用了创新策略:将 730 天历史数据与最新用户标签关联,确保分析一致性。通过在 Hive 中行转列,将 730 条记录合并为 1 条,再导入 StarRocks 创建视图,实现数据量缩减 730 倍。系统将数据与最新标签进行 join,按业务维度分组后创建物化视图,每日只需 Refresh 物化视图即可实现查询秒出。
 七猫还构建了通用人群圈选系统,将圈选工作前置到业务团队。业务人员只需编写 SQL 提交到系统,即可自动创建人群包。系统将人群信息存储在 StarRocks 中,同时落入 Hive 供离线分析,大幅降低了数仓团队的工作量,将每周 2-3 个圈选需求减少到每 2-3 个月 1 个,显著提升了数据交付效率。
结语
选择合适的数据库架构是一项需要综合考量的复杂决策。通过理解事务型数据库和分析型数据库的本质差异,结合业务特点和未来发展规划,您可以为企业构建更高效、更可靠的数据基础设施。
随着技术的不断演进,两类数据库的界限正在变得模糊,但它们的核心设计理念和最佳应用场景仍有明显区别。希望本文提供的分析框架和决策指南能够帮助您在特定业务场景下做出最优选择。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70038017/viewspace-3082101/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从 StarRocks 到 MIP:数据平台的下一步是“理解”
- Semantic View技术解析(三):指标、关系与过滤规则如何约束查询结果
- Semantic View 技术解析(二):业务口径如何进入数据库执行路径
- 从单条 SQL 到完整任务:Agent 带来的五个数据负载变化
- 从 DBA 经验到 Agent:镜舟如何构建生产级智能排障体系
- 为什么 Text-to-SQL 总是停在 Demo?
- AI 能写 SQL,但它真的理解数据吗?镜舟 Semantic View 如何补齐语义缺口
- 一句话发起排障,镜舟 DevOps Agent 正式上线
- WAIC 2026 交卷时刻:Agent落地新标尺是什么?
- Databricks 再提 LTAP,AI 时代的数据底座为何重回大一统叙事?
