关于大模型的常见问题写在了文章《抢先掌握大模型技能,赢得未来 | 大模型常见知识点系列解读》中。该系列文章是对上述文章中提出的问题的展开描述,已写的系列文章如下:
当前公布的大模型已经上百个,既包含通用底座的大模型,又有各个垂类的细分大模型,在利用大模型解决自己场景的问题的时候,可能会遇到一些场景独有的问题,这时候需要考虑对大模型进行调整,使其对自己的场景更加的匹配。
1、什么是指令微调
指令微调是一种用于微调大型语言模型(LLMs)的新方法。它比传统的微调方法更有效,因为它允许 LLMs 在更少的数据集上进行训练。
指令微调的工作原理是向 LLM 提供一组指令,这些指令将帮助它学习如何执行特定任务。指令可以是自然语言文本或代码。一旦 LLM 学习了指令,它就可以在新的任务上进行微调,即使只有少量的数据。
指令微调已被证明在许多任务上有效,包括机器翻译、摘要和问答。它是一种强大的工具,可以用于训练 LLMs 执行各种任务。
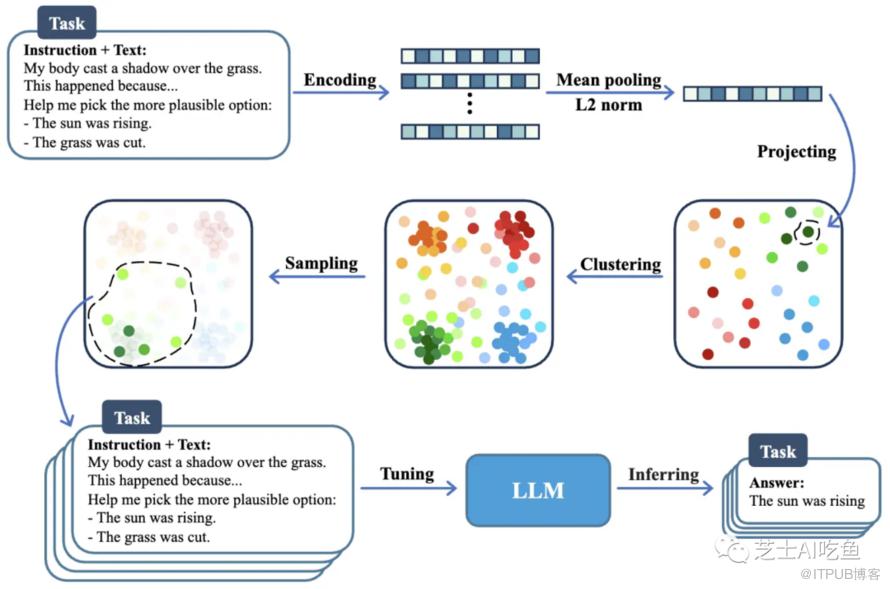
2、指令微调的过程
首先,您需要训练一个预训练语言模型(LLM)。LLM 是通过在大量文本数据上训练的大型神经网络。LLM 学习识别文本中的模式,并可以用于生成文本、翻译语言和回答问题。
接下来,您需要创建一个指令数据集。指令数据集是包含指令和预期输出的文本对的集合。例如,指令数据集可能包含以下文本对:
指令 |
预期输出 |
“翻译以下文本:Je suis français。” |
“我来自法国。” |
“回答以下问题:巴黎是哪个国家的首都?” |
“巴黎是法国的首都。” |
最后,您需要使用指令数据集来微调 LLM。这涉及使用指令数据集训练 LLM,以便它可以学习如何根据指令生成预期输出。
3、指令微调的优劣
以下是指令微调的一些优点:
减少数据需求:指令微调能够以较少的数据量来微调模型,这在数据稀缺的情况下尤为有利。
提升生成质量:相比传统微调,指令微调能够生成更为自然、通顺和有信息量的文本内容。
适用广泛:指令微调在各种任务中都取得了成功,这使得它成为一个通用且有效的方法。
以下是指令微调的一些缺点:
指令创建困难:编写有效的指令可能并不是一件容易的事情。有时候,我们需要费尽心思地构思和设计指令,以确保模型能够准确地执行任务。
指令评估挑战:衡量指令的有效性可能是一项挑战。有时候我们可能需要尝试不同的指令来找到最佳的效果。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

