随着对大型语言模型(LLMs)的兴趣不断增长,越来越多的开发者和组织投入到构建利用它们强大能力的应用程序中。然而,当将这些预训练的LLMs投入使用时,往往会面临一个普遍的问题:它们的表现不尽如人意。
这时,一个关键的问题浮现出来,即如何提高LLM应用性能?这时候我们通常有两种方案:检索增强生成(RAG)和模型微调。
在我们深入探讨这个问题之前,让我们先来详细解释一下这两种方法:
1. 检索增强生成(RAG):这种方法将检索或搜索的能力融入到LLM文本生成过程中。它结合了一个检索系统,用于从大型语料库中提取相关文档片段,LLM使用这些片段的信息来生成答案。也就是,RAG允许模型在生成文本时“查找”外部信息,从而改善其响应的质量。

2. 模型微调:这是将预训练的LLM进一步在较小、特定数据集上训练的过程,以适应特定任务或提高性能。通过微调,我们可以根据自己的数据来微调模型的权重,使其更好地适应应用的场景的独特需求。
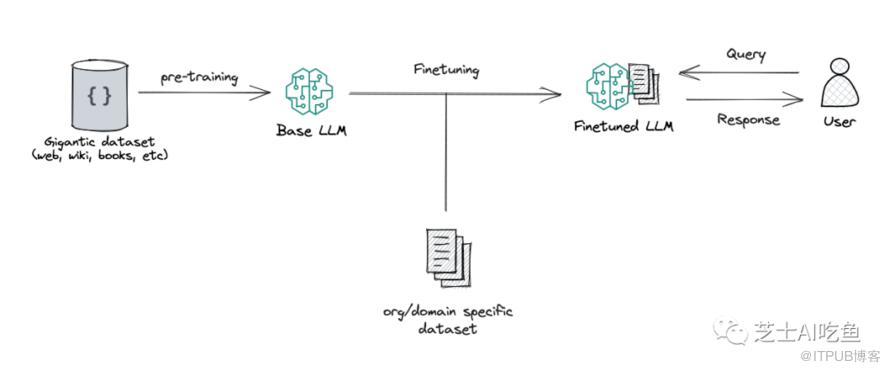
无论是RAG还是模型微调都是增强LLM应用性能的强大工具,但它们解决了优化过程的不同方面,这在选择时至关重要。
一般来说,在微调模型前可以尝试使用RAG,毕竟模型的微调对数据、算力、时间成本的消耗明显多余RAG方式。
近年来,微调已成为改善LLM应用的首选方法。这在很大程度上是因为像迁移学习和元学习这样的技术取得了进展,使得将预训练模型微调用于特定任务变得更加容易和高效。
迁移学习涉及将预训练模型适应于具有有限数据的新任务。这可以大大减少所需的数据和计算资源。另一方面,元学习允许模型从少量示例中学习如何学习,从而在微调时更加高效和有效。
微调的另一个优势是,它通常比RAG实现更好的性能。这是因为微调允许模型从特定任务和手头的数据中学习,而RAG则依赖于从语料库中检索的外部信息。虽然RAG可能提供一些有用的信息,但它可能并不总是与手头的特定任务相关或准确。
然而,值得注意的是,无论是RAG还是微调都有各自的优点和缺点,选择其中之一取决于应用程序的具体要求和限制。例如,如果可用数据有限,RAG可能是更可行的选择。但如果目标是在特定任务中实现最佳性能,那么微调很可能更有效。
何时使用RAG?
应用程序需要模型能够访问和处理外部信息。例如,回答关于现实世界的问题的应用程序将受益于使用RAG,因为它允许模型访问和处理来自现实世界来源(如维基百科或新闻文章)的信息。
应用程序需要模型能够生成不同创意文本格式,如诗歌、代码、脚本、音乐作品、电子邮件、信件等。RAG可以通过提供更广泛的信息访问来帮助模型生成更具创意和信息性的文本。
应用程序具有有限数量的训练数据。对于具有有限训练数据量的应用程序来说,RAG是一个不错的选择,因为它可以帮助模型从更广泛的信息中学习。
何时使用微调?
应用程序需要模型非常准确。微调可以帮助模型学习特定任务的微妙之处,从而提高准确性。
应用程序具有大量训练数据。当模型有大量训练数据可供学习时,微调效果最好。
应用程序需要能够快速响应。微调有时可能会导致模型变得较慢,因为模型需要处理训练数据以更新权重。
除了上述提到的因素外,在选择RAG和微调之间还有一些其他因素需要考虑:
方法的成本:相对于微调,RAG可能更昂贵,因为它需要开发和维护检索系统。
实施方法所需的时间:相对于微调,RAG可能需要更长的时间来实施,因为它需要开发和训练检索系统。
方法的复杂性:RAG比微调更复杂,可能需要更多的技术专业知识来实施和维护。
最终,选择RAG还是微调的最佳方法是尝试两种方法,并看哪种对于特定应用程序效果最好!
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

