有一个名为LangChain的流行开源库,它可以创建聊天机器人,其中包括用 3 行代码对任何网站/文档进行问答。这是langchain 文档中的一个示例。
from langchain.document_loaders import WebBaseLoader
from langchain.indexes import VectorstoreIndexCreator
loader = WebBaseLoader("http://www.paulgraham.com/greatwork.html")
index = VectorstoreIndexCreator().from_loaders([loader])
index.query("What should I work on?")
第一次运行它时,感觉就像是纯粹的魔法。这到底是怎么运作的?
答案是一个称为检索增强生成(retrieval Augmented Generation),简称 RAG 的过程。这是一个非常简单的概念,但其实现细节也具有令人难以置信的深度。
这篇文章将提供 RAG 的概述。我们将从上面事情的整体工作流程开始,然后放大所有单独的部分。到最后,应该对这三行神奇的代码是如何工作的,以及创建这些问答机器人所涉及的所有原则有一个深入的了解。
1、什么是检索增强生成?
检索增强生成是用从其他地方检索到的附加信息来补充用户输入到大型语言模型 (LLM)(例如 ChatGPT)的过程。然后,LLM可以使用该信息来增强其生成的响应。
下图展示了它在实践中的工作原理:
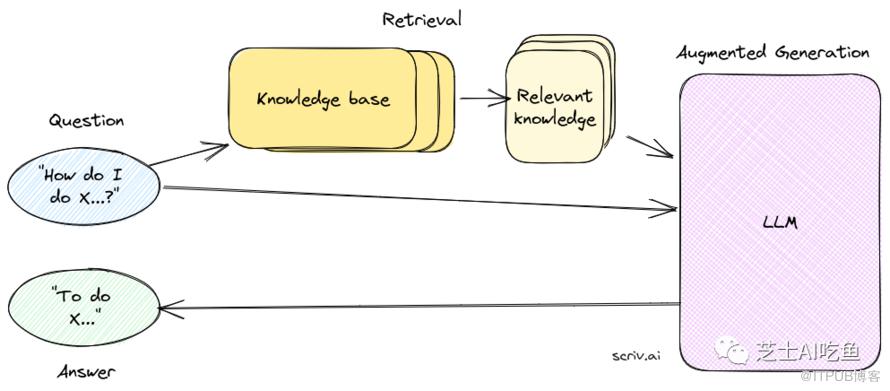
它从用户的问题开始。例如“我该怎么做<某事>?”
首先发生的是检索步骤。这是接受用户问题并从知识库中搜索可能回答该问题的最相关内容的过程。检索步骤是迄今为止 RAG 链中最重要、最复杂的部分。但现在,想象一下一个黑匣子,它知道如何提取与用户查询相关的最佳相关信息块。
我们不能只为 LLM 提供整个知识库吗?
你可能想知道为什么我们要费心检索而不是将整个知识库发送给法LLM。原因之一是模型对一次可以读取的文本长度有限制。第二个原因是成本——发送大量文本会变得相当昂贵。最后,有证据表明发送少量相关信息会得到更好的答案。
一旦我们从知识库中获取了相关信息,我们就会将其与用户的问题一起发送到大型语言模型(LLM)。LLM(最常见的是 ChatGPT)然后“读取”所提供的信息并回答问题。这是增强生成步骤。
很简单,对吧?
2、逆向工作:为LLM提供额外的知识来回答问题
我们将从最后一步开始:答案生成。也就是说,假设我们已经从知识库中提取了我们认为可以回答问题的相关信息。我们如何使用它来生成答案?
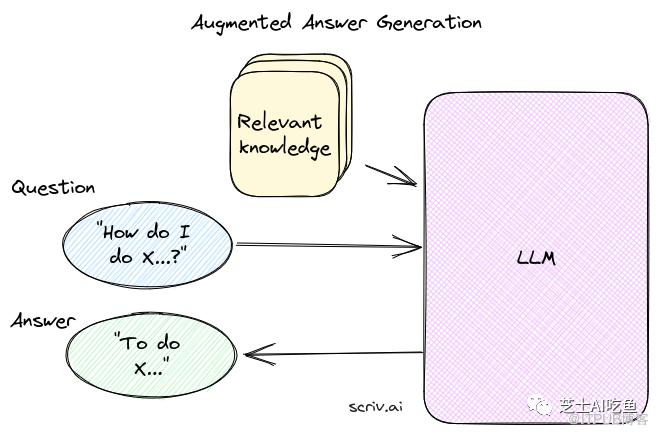
这个过程可能感觉像是黑魔法,但在幕后它只是一个语言模型。因此,从广义上讲,答案是“只需询问LLM即可”。我们怎样才能让LLM来做这样的事情呢?
我们将使用 ChatGPT 作为示例。就像常规的 ChatGPT 一样,这一切都取决于提示和消息。
- 通过系统提示给出LLM自定义指令
第一个组成部分是系统提示符。系统提示给予语言模型整体指导。对于ChatGPT,系统提示类似于“你是一个有用的助手”。
在这种情况下,我们希望它做一些更具体的事情。而且,由于它是一个语言模型,我们可以告诉它我们想要它做什么。以下是一个简短的系统提示示例,为LLM提供了更详细的说明:
你是一个知识机器人。您将获得知识库的提取内容和一个问题。使用知识库中的信息回答问题。
我们基本上是在说,“嘿人工智能,我们会给你一些东西来阅读。阅读它,然后回答我们的问题,ok?谢谢。” 而且,因为人工智能非常擅长遵循我们的指令,所以这样就有效。
- 为LLM提供我们特定的知识来源
接下来我们需要为人工智能提供阅读材料。但是,我们可以通过一些结构和格式来帮助它。
以下是可用于将文档传递给 LLM 的示例格式:
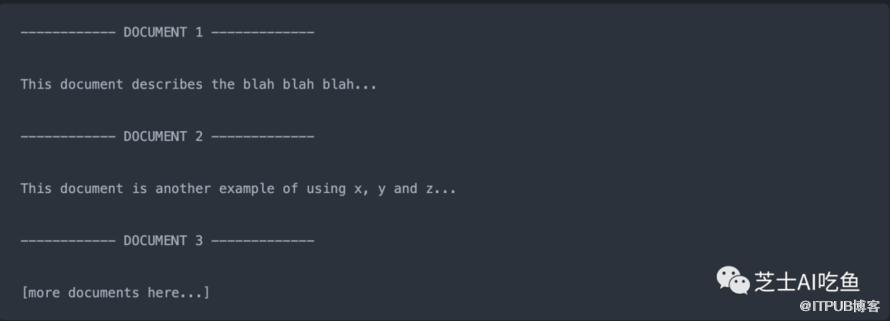
一定是这些格式吗?那不是的,但是让事情尽可能明确是件好事。你还可以使用机器可读的格式,例如 JSON 或 YAML。或者,如果你感觉可行的任意格式。但是,一般来说,保持一致的格式效果上比较容易调整。
一旦我们格式化了文档,我们只需将其作为普通聊天消息发送给LLM。请记住,在系统提示中我们告诉它我们要给它一些文件,这就是我们在这里所做的一切。
- 将所有内容放在一起并提出问题
一旦我们收到系统提示和“文档”消息,我们只需将用户的问题与他们一起发送给LLM。以下是使用 OpenAI ChatCompletion API在 Python 代码中的样子:

就是这样!自定义系统提示、两条消息,就能获得特定于上下文的答案!
这是一个简单的用例,可以对其进行扩展和改进。我们还没有做的一件事是告诉人工智能如果在来源中找不到答案该怎么办。我们可以将这些指令添加到系统提示中,通常是告诉它拒绝回答,或者使用它的常识,具体取决于的机器人所需的行为。还可以让LLM引用其用于回答问题的具体来源。我们将在以后的帖子中讨论这些策略,但现在,这是答案生成的基础知识。
简单的部分已经完成,是时候回到我们跳过的黑匣子了……
3、检索步骤:从知识库中获取正确的信息
上面我们假设我们有正确的知识片段可以发送给LLM。但我们如何从用户的问题中真正得到这些呢?这是检索步骤,它是任何“与数据聊天”系统中基础设施的核心部分。
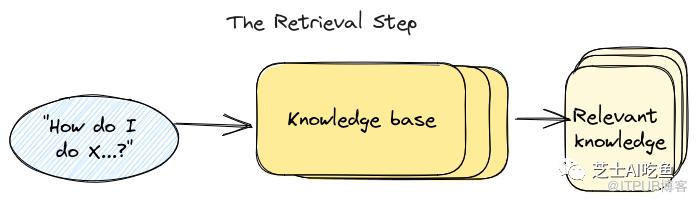
从本质上讲,检索是一种搜索操作——我们希望根据用户的输入查找最相关的信息。就像搜索一样,有两个主要部分:
索引:将知识库变成可以搜索/查询的内容。
查询:从搜索词中提取最相关的知识。
值得注意的是,任何搜索过程都可以用于检索。任何接受用户输入并返回一些结果的方法都是ok的。因此,举例来说,可以尝试查找与用户问题相匹配的文本并将其发送给LLM,或者可以通过 Google 搜索该问题并将最热门的结果发送出去——顺便说一句,这大致就是 Bing 聊天机器人的工作原理。
也就是说,当今大多数RAG 系统都依赖于一种称为语义搜索的技术,它使用人工智能技术的另一个核心部分:嵌入。在这里我们将重点关注该用例。
那么...什么是嵌入?
4、什么是嵌入?它们与知识检索有什么关系?
LLM 是很奇怪的。他们最奇怪的事情之一是没有人真正知道他们如何理解语言。嵌入是这个故事的重要组成部分。
如果你问一个人如何解释一个词的意思,他们很可能会思索并说出一些模糊且带主观色彩的话,例如“因为我知道它们的意思”。在我们大脑深处的某个地方,有一个复杂的结构,它知道“孩子”和“小孩”基本上是相同的,“红色”和“绿色”都是颜色,“高兴”、“快乐”和“兴高采烈”代表着相同的情绪,但程度不同。我们无法解释它是如何工作的,我们只是知道它。
语言模型对语言有类似的理解,只不过,因为它们是计算机,所以它不在大脑中,而是由数字组成。在LLM的世界中,任何人类语言都可以表示为数字向量(列表)。这个数字向量就是嵌入。
LLM 技术的一个关键部分是从人类文字语言到人工智能数字语言的翻译器。我们将这个翻译器称为“词嵌入”,尽管在幕后它只是一个 API 调用。人类语言输入,人工智能数字输出。
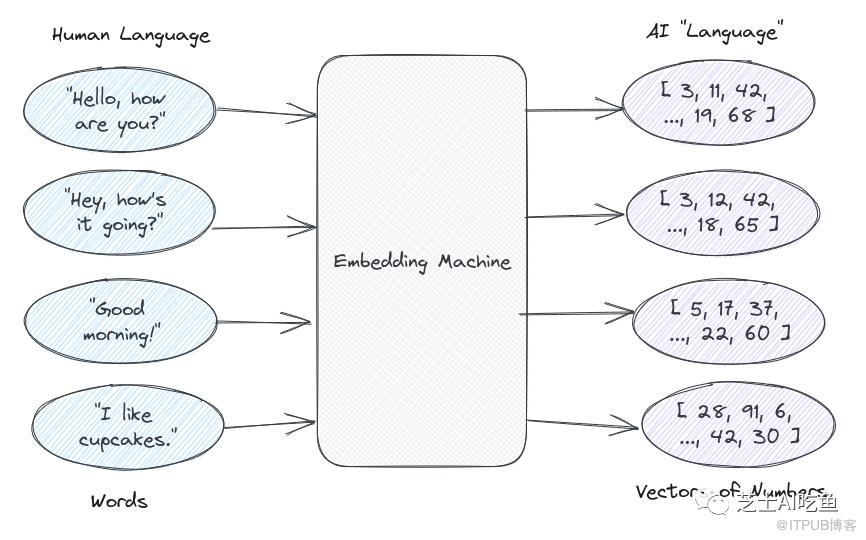
这些数字意味着什么?没有人知道!它们只对人工智能“有意义”。但是,我们所知道的是,相似的单词最终会得到相似的数字组。因为在幕后,人工智能使用这些数字来“阅读”和“说话”。因此,这些数字在人工智能语言中融入了某种神奇的理解力——即使我们不理解它。词嵌入就是我们的翻译器。
现在,既然我们有了这些神奇的人工智能数字,我们就可以绘制它们了。上述示例的简化图可能看起来像这样。
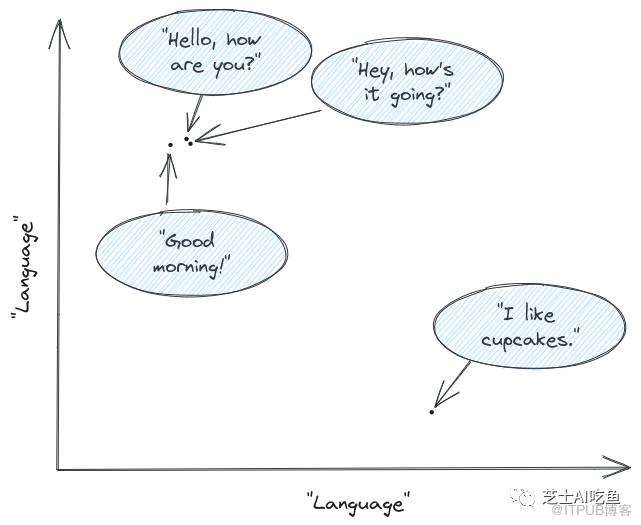
一旦我们绘制了它们,我们就可以看到,在这个假设的语言空间中,两点彼此越接近,它们就越相似。“你好吗?” 和“嘿,怎么样?” 实际上是同一个意思。另一种问候语“早上好”与这些问候语相距不远。“我喜欢蛋糕”位于一个与其他地方完全不同的地方。
当然,你不能在二维图上表示整个人类语言,但理论是相同的。实际上,嵌入有更高的维度,通常为1024或者2048。但你仍然可以进行基本数学计算来确定两个嵌入(以及两段文本)彼此之间的接近程度。
这些嵌入和确定“接近度”是语义搜索背后的核心原则,为检索步骤提供动力。
5、使用嵌入找到最好的知识片段
一旦我们了解了嵌入搜索的工作原理,我们就可以构建检索步骤的高级图像。
在索引方面,首先我们必须将知识库分解为文本块。这个过程本身就是一个完整的优化问题,我们接下来将介绍它,但现在假设我们知道如何去做。
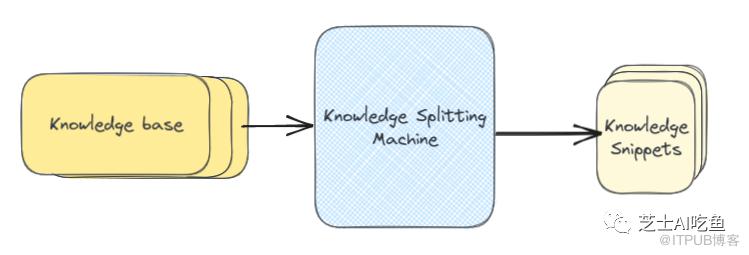
完成此操作后,我们将每个知识片段通过embedding模型传递,并返回该文本的嵌入表示。然后,我们保存该片段以及向量数据库中的嵌入——该数据库针对数字向量进行了优化。

现在我们有了一个数据库,其中嵌入了我们所有的内容。从概念上讲,您可以将其视为我们整个知识库在“语言”图上的图:

一旦我们有了这个图,在查询方面,我们就会执行类似的过程。首先我们获得用户输入的嵌入:

然后我们将其绘制在相同的向量空间中并找到最接近的片段(在本例中为 1 和 2):
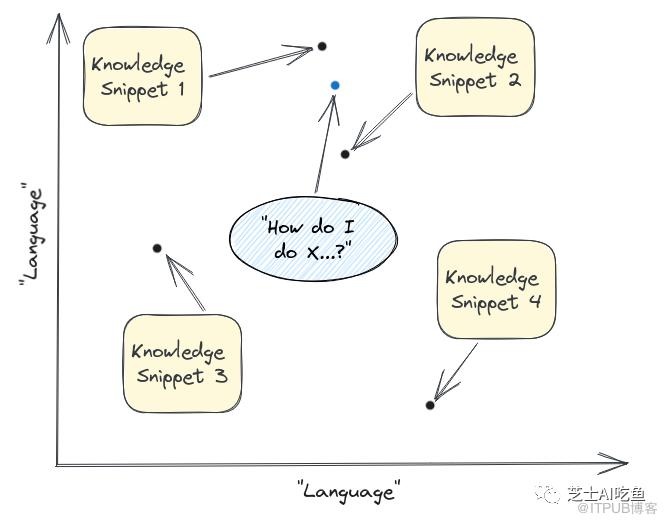
神奇的嵌入模型认为这些是与所提出的问题最相关的答案,因此这些是我们提取发送给LLM的片段!
在实践中,这个“最近的点是什么”问题是通过查询我们的矢量数据库来完成的。所以实际的过程看起来更像是这样的:
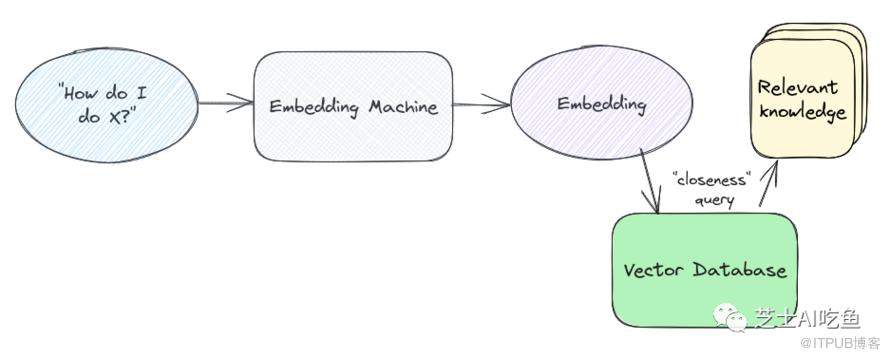
查询本身涉及一些半复杂的数学——通常使用称为余弦距离的东西,尽管还有其他计算方法。
6、索引知识库
我们现在了解如何使用嵌入来查找知识库中最相关的部分,将所有内容传递给LLM,并获取增强的答案。我们将介绍的最后一步是从知识库创建初始索引。换句话说,这张图中的“知识分割模块”:

也许令人惊讶的是,索引知识库通常是整个事情中最困难和最重要的部分。不幸的是,它更多的是艺术而不是科学,并且涉及大量的试验和错误。
总体而言,索引过程可归结为两个高级步骤。
加载Loading:从通常存储的位置获取知识库的内容。
分割Splitting:将知识分割成适合嵌入搜索的片段大小的块。
设想构建一个聊天机器人来回答有关我的SaaS 样板产品 SaaS Pegasus 的问题。我想添加到我的知识库中的第一件事是文档站点。加载器Loader是一个基础设施,它可以访问我的文档,找出可用的页面,然后拉取每个页面。加载程序完成后,它将输出单独的文档- 网站上的每个页面都有一个文档。
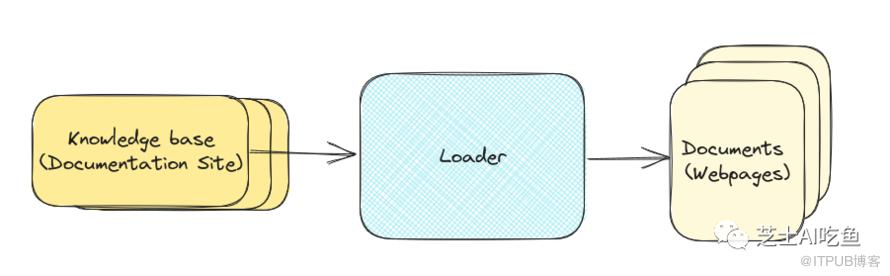
加载器Loader内部发生了很多事情!我们需要抓取所有页面,然后抓取每个页面的内容,然后将 HTML 格式化为可用的文本。用于其他内容(例如 PDF 或 Google Drive)的加载器也有不同的部分。还有并行化、错误处理等等需要解决。再说一次,这是一个几乎无限复杂的主题,但出于本文的目的,我们将主要将其转移到一个库中。所以现在,我们再次假设我们有一个神奇的盒子,里面有一个“知识库”,然后出来的是单独的“文档”。
LangChain加载器的接口与上面描述的完全相同。输入一个“知识库”,出来一个“文档”列表。
从加载程序中出来后,我们将获得与文档站点中每个页面相对应的文档集合。此外,理想情况下,此时额外的标记已被删除,仅保留底层结构和文本。
现在,我们可以将这些整个网页传递到我们的嵌入模型,并将它们用作我们的知识片段。但是,每一页可能涵盖很多内容!而且,页面中的内容越多,该页面的嵌入就越“不具体”。这意味着我们的“接近度”搜索算法可能效果不太好。
更有可能的是,用户问题的主题与页面内的某些文本相匹配。这就是问题出现的地方。通过拆分,我们可以获取任何单个文档,并将其拆分为更适合搜索的小块、可嵌入的块。

再一次声明,分割文档也是一门艺术,包括平均片段的大小(太大,它们不能很好地匹配查询,太小,它们没有足够的有用上下文来生成答案),如何拆分内容(通常按标题,如果有的话),等等。但是,一些合理的默认值足以开始使用和完善您的数据。
一旦我们有了文档片段,我们就将它们保存到我们的矢量数据库中,如上所述,我们终于完成了!
这是对知识库进行索引的完整图片。
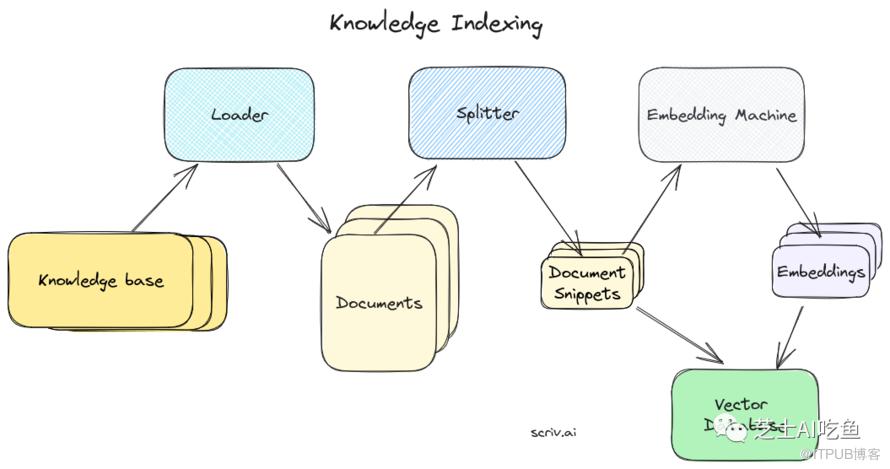
在LangChain中,整个索引过程都封装在这两行代码中。首先,我们初始化网站加载器并告诉它我们要使用什么内容:
loader = WebBaseLoader("http://www.paulgraham.com/greatwork.html")
然后我们从加载器构建整个索引并将其保存到我们的向量数据库中:
index = VectorstoreIndexCreator().from_loaders([loader])
加载、分割、嵌入和保存都在幕后进行。
7、回顾整个过程
最后我们可以充分充实整个 RAG 管道。它看起来是这样的:
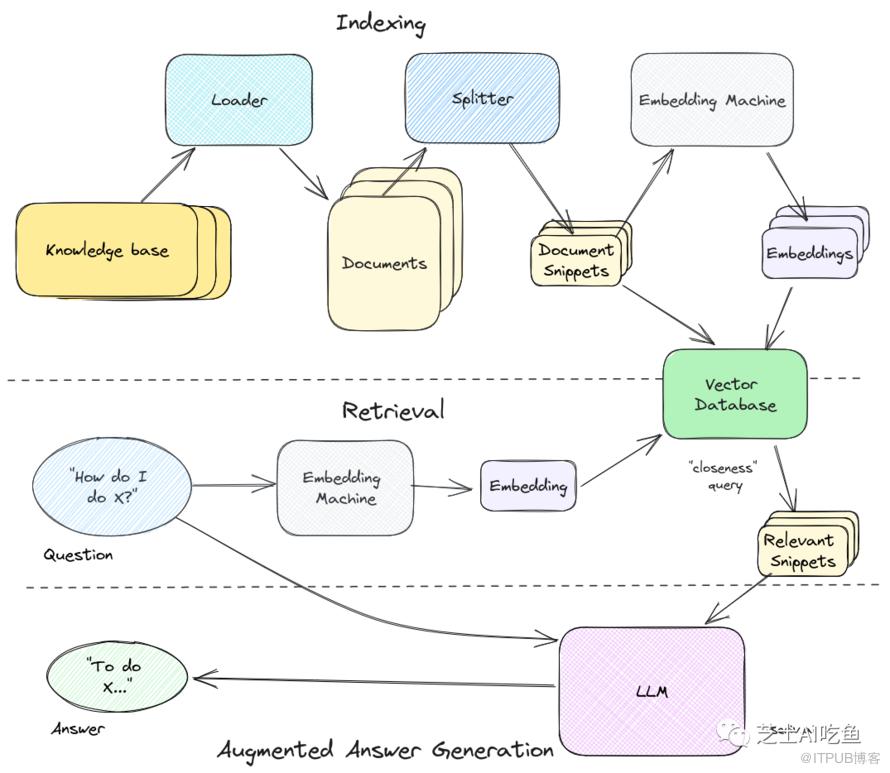
首先,我们索引我们的知识库。我们获取知识并使用加载器将其转换为单独的文档,然后使用拆分器将其转换为一口大小的块或片段。一旦我们有了这些,我们就把它们传递给嵌入模型,嵌入模型将它们转换成可用于语义搜索的向量。我们将这些嵌入及其文本片段保存在我们的矢量数据库中。
接下来是检索。它从问题开始,然后通过同一嵌入模型发送并传递到我们的矢量数据库以确定最接近的匹配片段,我们将用它来回答问题。
最后,增强答案生成。我们获取知识片段,将它们与自定义系统提示和我们的问题一起格式化,最后得到特定于上下文的答案。
from langchain.document_loaders import WebBaseLoader
from langchain.indexes import VectorstoreIndexCreator
loader = WebBaseLoader("http://www.paulgraham.com/greatwork.html")
index = VectorstoreIndexCreator().from_loaders([loader])
index.query("What should I work on?")
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

