假期归来,正好最近的项目也是LLM和RAG的结合,将遇到的、看到的关于RAG的一些问题进行梳理如下。
关于RAG检索系统,之前写过一些相关的推文。想进一步了解的可以看下面的几篇。
RAG在一定程度上缓解了大模型在落地过程中的痛点,但也同时带来了一些问题,当然这些问题相比带来的收益是那么微不足道,但我们也应重视RAG在实际应用中存在的问题或难点。
从语义搜索开始
在我们进一步讨论之前,让我们先做一个实验。以下代码段将查询的余弦相似度得分与一系列语句进行比较。它使用 GCP VertexAI 的 textembedding-gecko001 模型来生成 768 维嵌入向量。
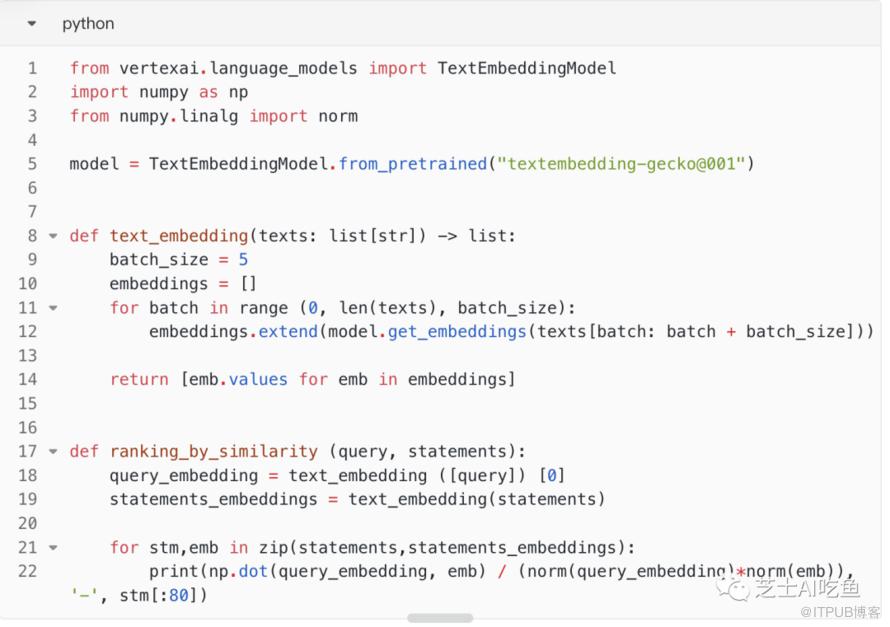
结合上面的检索代码,利用下面的数据进行测试:
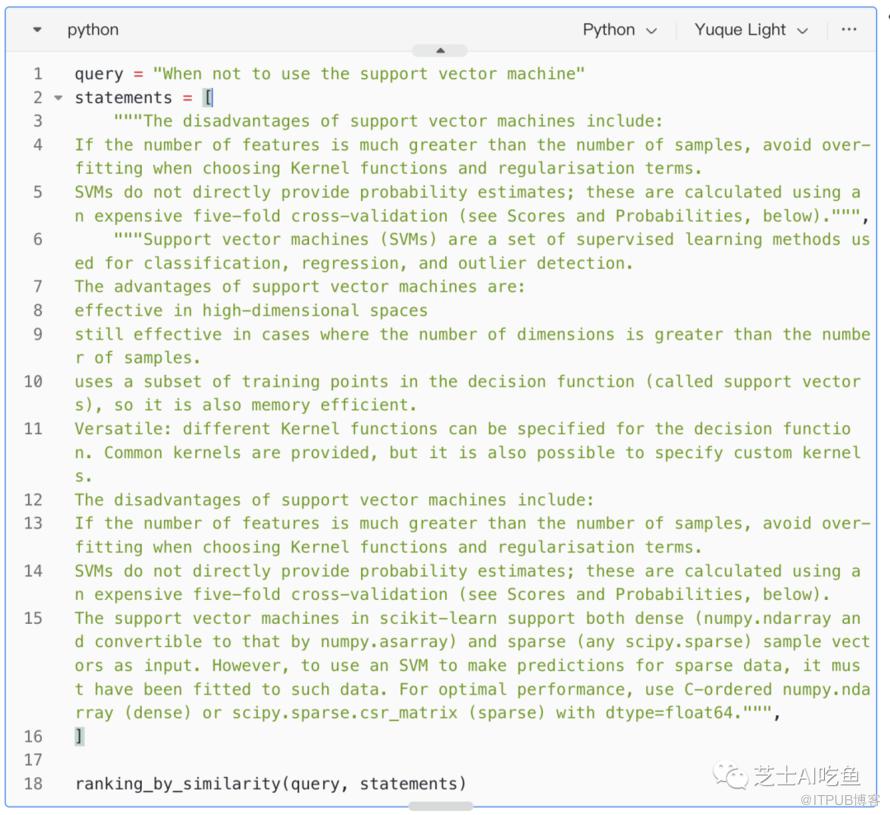
输出结果如下图,返回的结果没有啥问题,我们的问题是为什么不使用SVM,返回结果的top2是关于SVM的优缺点的,好像能够回答我们的问题,
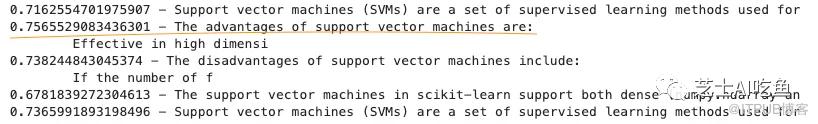
那么,我们换一个问题试试看。

在这个问题检索情况下,返回的结果并不能让人满意,语义检索不仅相似度非常低,而且还忽略了情感极性。
语义检索是RAG系统的前置条件,检索的效果直接影响了大模型的生成效果,也就是语义检索是RAG系统效果的上限。
嵌入模型或自动编码器将输入数据特征学习到权重中,我们将其称为嵌入向量。我们发现嵌入向量从输入文本中吸引了重要信息,并且向量相似度可以用来比较文本的紧密程度。然而,我们不知道提取了哪些信息,也不知道信息是如何在向量中组织的,更不用说如何使其更高效或开发更准确的相似性函数。
因此,请做好语义相似性搜索有时可能会达不到目标的准备。假设语义搜索总是能检索到合理的结果是不现实的。
块大小和 Top-k
复杂的 RAG 应支持灵活的分块,并可能添加一点重叠以防止信息丢失。一般来说,分块过程会忽略文本的内容,这会导致问题。块的理想内容应该围绕单个主题保持一致,以便嵌入模型更好地工作。他们不应该从一个话题跳到另一个话题;他们不应该改变场景。如 SVM 测试用例所示,该模型更喜欢短且单一的输入。
那么我们选择所有小块怎么样?这种情况下,我们需要考虑参数top_k的影响。RAG 系统使用 top_k 来选择将多少得分最高的块输入到生成 LLM 中。在大多数设计中,top_k 是一个固定数字。因此,如果块大小太小或者块中的信息不够密集,我们可能无法从矢量数据库中提取所有必要的信息。
对于熟悉机器学习模型调优的人来说,块大小和 top_k 这对组合是否熟悉?它们看起来像机器学习模型的超级参数,不是吗?为了确保 RAG 系统发挥最佳性能,确实需要调整 chunk-size 和 top_k 以确保它们最适合。超级参数调整的古老智慧仍然适用,唯一的区别是它们的调整成本要高得多。
知识边界
假如我们的知识库是小说知识库,然后你问大模型“蛇有几个头”,那么大模型可能会回答“9个”,因为知识库中存在“九头蛇”这个物种。实际上,大模型是知道答案的,但因为我们在输入的时候给了更“权威”的检索结果,大模型不得不做出这样的答复。
哪些知识大模型本身就知道,哪些问题需要借助RAG进行生成,是一个需要考虑的问题。盲目过度的借助检索结果,有些常识性问题反而会导致错误的答案。
多跳问答
我们考虑另一个场景:我们构建了一个基于社交媒体的RAG系统。然后我们问:谁认识埃隆·马斯克?然后系统将迭代矢量数据库以提取埃隆·马斯克的联系人列表。由于块大小和 top_k 的限制,我们可以预期该列表是不完整的;然而,从功能上来说,它是有效的。
现在,如果我们重新思考我们的问题并问:除了艾梅柏·希尔德,谁可以将约翰尼·德普介绍给埃隆·马斯克?单轮信息检索无法回答此类问题。这种类型的问题称为多跳问答。解决它的一种方法是:
检索埃隆·马斯克的所有联系人
检索约翰尼·德普的所有联系人
检查两个结果之间是否有任何交集,除了 Amber Heard 之外
如果有交集则返回结果,或者将埃隆·马斯克和约翰尼·德普的联系人扩展到他们朋友的联系人并再次检查。
有多种架构可以适应这种复杂的算法;其中一种使用像 ReACT 这样复杂的提示工程,另一种使用外部图形数据库来辅助推理。我们只需要知道这是 RAG 系统的限制之一。
信息丢失
如果我们看一下 RAG 系统中的流程链:
1. 对文本进行分块并生成块的嵌入
2. 通过语义相似性搜索检索块
3. 根据top_k块的文本生成响应
我们将看到所有过程都是有损的,这意味着不能保证所有信息都会保留在结果中。如上所述,由于块大小的选择和嵌入模型的功能,分块和嵌入是有损的;由于top_k限制和我们使用的相似度函数,检索过程并不完美;由于内容长度限制和LLM的能力,回复生成过程并不完善。
上述种种的问题在整个链路进行累计,可能导致更大的问题。当然,搜索引擎和LLM结合是可行的,但简单的RAG可能很难有比搜索引擎更好的结果。
结论
RAG作为一种简单而强大的LLM应用设计模式,有它的优点和缺点。我们确实需要彻底了解技术才能对我们的设计充满信心。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

