
什么是RAG?
检索增强生成 (RAG)是一种结合信息检索的大模型生成方法,可提高生成文本的质量和相关性,特别是在问答、摘要和文本完成等复杂语言任务的背景下。
RAG 的主要目标是通过利用检索的优势来增强生成过程,使 NLG 模型能够生成更合理且适合上下文的响应。通过将检索中的相关信息纳入生成过程,RAG 旨在提高生成内容的准确性、连贯性和信息量。
混合向量检索
混合检索基本上是关键字搜索和矢量样式搜索的组合。它具有进行关键字搜索的优点以及进行从嵌入和向量搜索中获得的语义查找的优点。
关键词搜索 :
这里我们使用BM25算法。它生成一个稀疏向量。BM25是一种信息检索算法,用于对文档与特定搜索查询的相关性进行排名和评分。它是TF-IDF(词频-逆文档频率)方法的扩展。
BM25要点:
TF:文档中term的频率。
IDF:根据term在整个文档集合中的频率来衡量term的重要性。
BM25:结合 TF 和 IDF 来计算给定查询的文档的相关性得分。
语义搜索
语义搜索是一种搜索方法,旨在通过理解搜索查询背后的上下文和含义来提高搜索结果的准确性和相关性。与主要依赖于匹配关键字的传统基于关键字的搜索不同,语义搜索试图理解用户查询的意图和上下文以及正在搜索的文档的内容。
语义搜索致力于模仿人类对语言和上下文的理解,最终提供更符合用户信息需求的搜索结果。
在实现中,我们使用 FAISS 进行语义搜索,使用 BM25 进行关键字搜索,以使用 langchain 实现混合搜索EnsembleRetriever.
将EnsembleRetriever检索器列表作为输入,将其方法的结果集成在一起get_relevant_documents(),并根据倒数排名融合算法对结果进行重新排名。通过利用不同算法的优势,EnsembleRetriever可以获得比任何单一算法更好的性能。
最常见的模式是将匹配检索器(如 BM25)与语义检索器(如嵌入相似性)相结合,因为它们的优势是互补的。它也被称为“混合搜索”。匹配检索器擅长根据关键词查找相关文档,而语义检索器擅长根据语义相似度查找相关文档。
代码实现
导入必要的包:
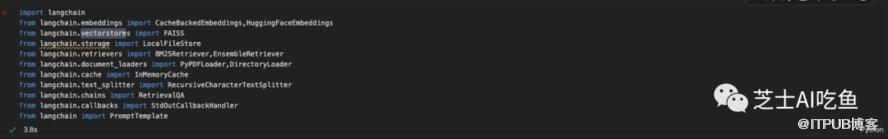
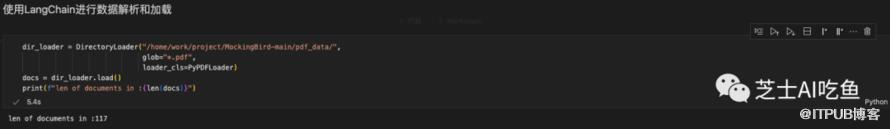
利用langchain进行数据的加载,需要注意的是,不同数据格式的加载是不同的,例如txt、pdf、doc、markdown等,针对每一种数据,可以进行分别实现不同的加载方法,最终返回langchain的Document类即可。
加载数据后,获取到的是一个完整的Document,可能是一个或多个Document,需要根据分隔符、块大小等对数据进行分割,将知识切分为更细粒度的chunk,Splitter的需要根据自己数据设定参数,需要关注的参数包括chunk_size、chunk_overlap、separators。

将所有的数据切分为一定粒度的chunk后,需要对chunk进行向量化,利于后续检索,获取用户输入的相关片段。向量化模型可以使用传统的bert、gpt、m3e等,只要能过实现文本到向量的转化就可以。
需要注意的是,langchain在加载向量化模型的时候,如果指定的是hugging face仓库,会先下载到本地再进行加载,由于网络或耗时问题,可以提前将使用的向量化模型下载到本地,此处使用的是m3e-base模型。
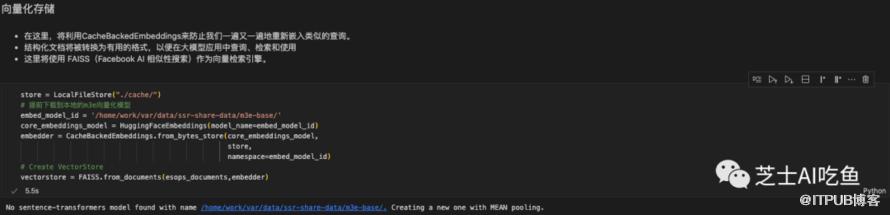
通过上述向量化过程,我们实现了对chunk粒度的向量化,此时,每一个chunk对应一个embedding。用户输入一个query时候,也需要进行同样模型的向量化,以便于能够进行向量化检索。

通常情况下,文本匹配检索和语义匹配检索可以混合使用,以提升检索的效果。
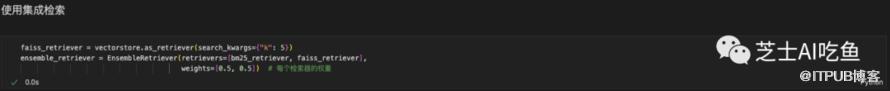
到此为止,我们实现了如下的功能:
加载我们自己的知识文档,并切分为指定大小的chunk
加载向量化模型,并对每个chunk进行向量化
指定检索器,检索器决定了输入query和chunk之间的计算逻辑
接下来,就是利用大模型对检索到的上下文信息进行问答生成。首先,我们需要加载大模型,这个地方需要注意的是,不同的大模型加载方式略有不同,需要注意。同时大模型可以提前下载到本地,通过trust_remote_code=True从本地读取,节省时间。
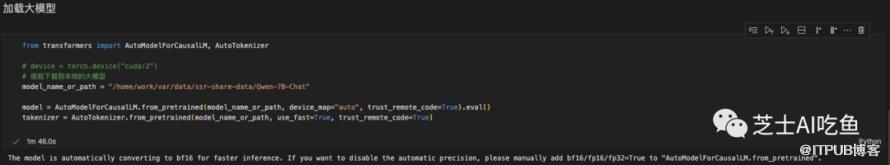
加载模型后,使用langchain的pipeline进行初始化,并设置缓存,提升推理的速度。

一般情况下,大模型是接受文本输入,生成文本输出,接受的输入是通过Prompt进行约束,在问答场景下,可以设置如下的Prompt
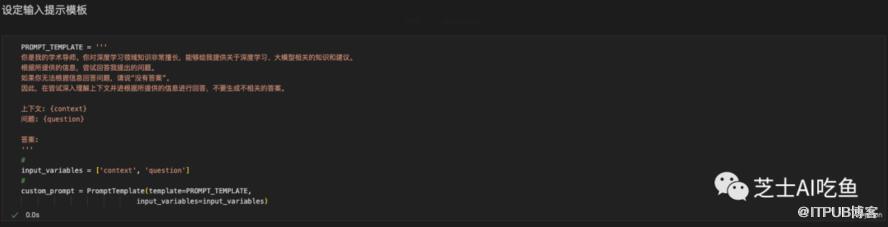
在完成上述所有设置和处理的前提下,设置检索的chain,并实际测试下效果

上述检索是使用单一的检索器,为了提升效果,可以使用集成的检索器如下:
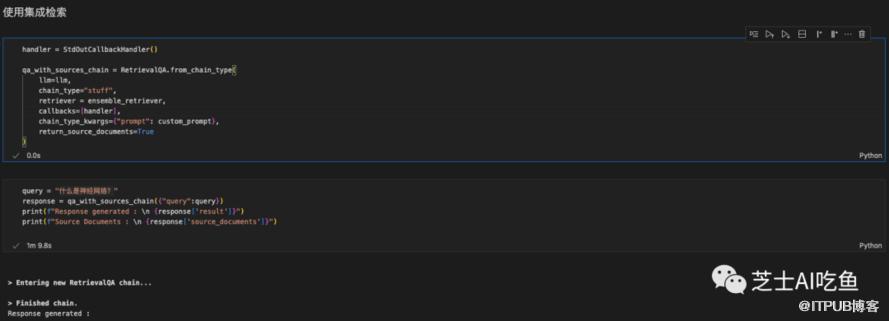
到此,我们完整的实现了一个基于RAG的本地大模型问答程序。对上述过程回顾如下:
加载、切分本地知识
初始化向量模型,并对知识进行向量化
设置检索器和匹配逻辑
初始化大模型和提示模板
将上述所有功能组成pipeline和chain
利用实际的输入进行生成
总结
我们可以看到,使用 EnsembleRetriver 的混合搜索为生成式 AI 模型提供了更好的上下文,从而可以制定更好的响应。缓存响应和查询还可以减少推理时间并降低计算成本。缓存查询嵌入还有助于避免重新计算它们。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

