在人工智能的天空中,2022年底发布的ChatGPT犹如一颗新星,为研究和商业界带来了前所未有的变革。作为一种大型语言模型(LLM),ChatGPT通过指令调优、监督微调和根据人类反馈的强化学习,不仅能回答人类问题,还能在广泛的任务中遵循指示。这一成就激发了对LLM的浓厚兴趣,学术和工业领域涌现出众多新的LLM,包括专注于LLM的初创公司。

一年前,OpenAI发布的ChatGPT在人工智能界及更广泛的领域引起了极大关注。这个AI聊天机器人首次普遍提供了有用、安全、详细的回答,并能够遵循指令、承认并修正错误。ChatGPT能执行多种自然语言任务,这些任务传统上依赖于预训练后进行定制微调的语言模型,如概括和问答(QA),其表现令人惊艳。作为首个此类产品,ChatGPT迅速吸引了公众关注,仅两个月内用户数便达到了1亿,速度远超其他流行应用如TikTok或YouTube。其巨大的商业潜力,例如降低劳动力成本、自动化工作流程以及为客户带来新体验,吸引了大量投资(Cheng et al., 2023)。然而,ChatGPT作为一个闭源产品,其技术细节大部分未公开,尽管有报道称它遵循了InstructGPT(GPT-3.5)的程序(Ouyang et al., 2022b),但其具体架构和训练数据仍然是个谜。
闭源存在的问题
这种封闭性带来了几个问题:
首先,不了解内部工作机制使得难以评估潜在的社会风险,尤其是LLM可能生成有害内容的风险;
其次,ChatGPT的性能波动妨碍了结果的可重现性(Chen et al., 2023c);
第三,ChatGPT在2023年11月遭遇了两次重大中断,影响了网站和API的访问;
最后,企业在采用ChatGPT时可能担忧成本、服务中断、数据所有权和隐私问题,以及不可预测的事件,例如最近关于首席执行官Sam Altman的职位变动和内部纷争(REUTERS来源)。
面对这些挑战,开源LLM成为一个有前景的解决方案,它们有可能解决或绕过上述问题。目前,虽然公认的是开源LLM如Llama-2(Touvron et al., 2023b)或Falcon(Almazrouei et al., 2023)在性能上落后于闭源对手,如OpenAI的GPT3.5(ChatGPT)和GPT-4,以及Anthropic的Claude2或Google的Bard3,但差距正在缩小,开源LLM正在迅速追赶。实际上,一些开源LLM已在特定任务上超越GPT-3.5-turbo。
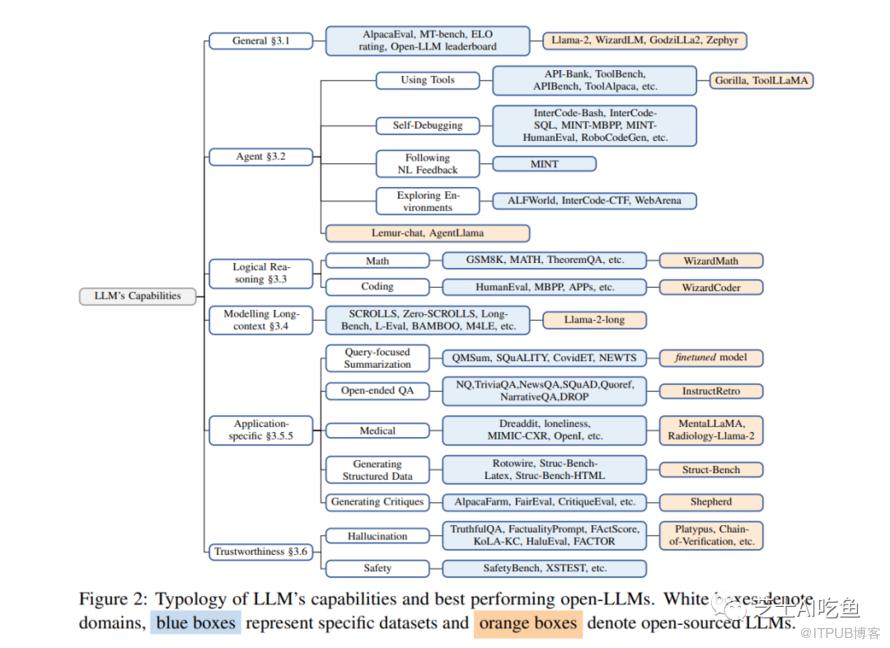
Llama-2-70B(由Touvron等人在2023年提出)是一款卓越的开源大型语言模型(LLM),它接受了在庞大的两万亿令牌数据集上的预训练,展示了在多个通用基准测试中的出色表现。当其通过指令数据进行特别微调后,其变体Llama-2-chat-70B在一般对话任务中展现了增强的能力。值得一提的是,它在AlpacaEval测试中取得了92.66%的胜率,远超过GPT-3.5-turbo的10.95%。尽管如此,GPT-4仍然在所有LLM中保持着领先地位,胜率高达95.28%。
模型规模是落地的重点方向
在规模较小的模型方面,Zephyr-7B(由Tunstall等人于2023年研发)采用了蒸馏直接偏好优化技术(由Rafailov等人于2023年提出),在AlpacaEval中与70B级别的LLM取得了相似的成绩,胜率为90.6%。令人印象深刻的是,它在MT-Bench测试中甚至超过了Llama-2-chat-70B,分别得分7.34和6.86。此外,WizardLM-70B(由Xu等人于2023年开发),经过了针对各种复杂度指令数据的精细微调,成为了在MT-Bench上表现最佳的开源LLM,得分7.71。然而,这仍低于GPT-3.5-turbo的7.94分和GPT-4的8.99分。
尽管Zephyr-7B在MT-Bench上的表现优异,但在开放LLM排行榜上的得分仅为52.15%。另一方面,GodziLLa2-70B(由Philippines于2023年开发),这款结合了各种专有LoRAs(来源于Maya Philippines 6)和Guanaco Llama 2 1K数据集(mlabonne,2023)的实验模型,在开放LLM排行榜上取得了更有竞争力的67.01%的得分,与GPT-3.5-turbo的70.21%相近。然而,这些都明显落后于GPT-4,后者以85.36%的高分遥遥领先。
UltraLlama(由Ding等人于2023年提出)则利用了具有增强多样性和质量的微调数据。这个模型在其提出的基准测试中表现与GPT-3.5-turbo相媲美,在世界和专业知识领域甚至超越了后者。
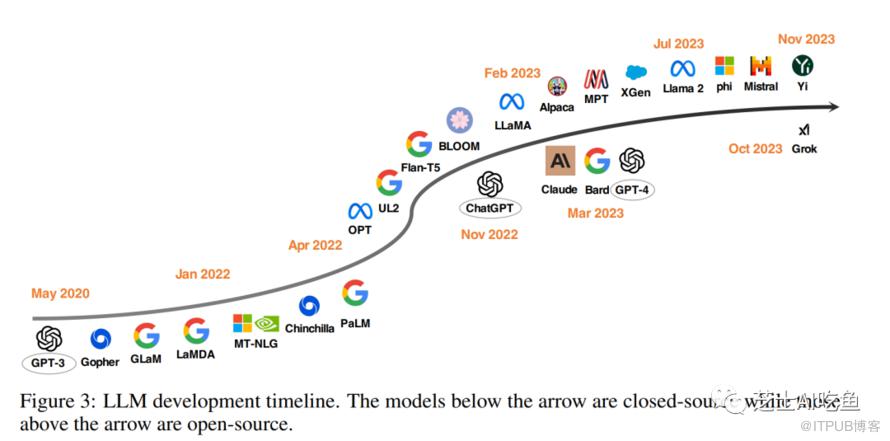
自从Brown等人在2020年展示了GPT-3模型在各种任务上的印象深刻的零次和少次尝试性能后,推动大型语言模型(LLM)发展的努力显著增加。一个主要研究方向是增加模型参数的规模,例如Gopher(由Rae等人于2021年提出)、GLaM(由Du等人于2022年提出)、LaMDA(由Thoppilan等人于2022年提出)、MT-NLG(由Smith等人于2022年提出)和PaLM(由Chowdhery等人于2022年提出),这些模型的参数量高达540B。虽然这些模型展现了显著的能力,但由于其封闭源的性质,其广泛应用受到限制,这引发了对开发开源LLM的日益浓厚兴趣(如Zhang等人于2022年和Workshop等人于2022年的研究)。
另一个研究方向是探索如何为规模较小的模型提供更好的预训练策略或目标,例如Chinchilla(由Hoffmann等人于2022年提出)和UL2(由Tay等人于2022年提出)。除了预训练,还有大量研究聚焦于语言模型的指令调优,例如FLAN(由Wei等人于2021年提出)、T0(由Sanh等人于2021年提出)和Flan-T5(由Chung等人于2022年提出)。
ChatGPT重塑了研究重点
OpenAI的ChatGPT自一年前问世以来,极大地改变了自然语言处理(NLP)社区的研究重点(Qin等人于2023年指出)。为了追赶OpenAI的步伐,Google和Anthropic分别推出了Bard和Claude。尽管它们在许多任务上展现了与ChatGPT相当的性能,但与最新的OpenAI模型GPT-4(OpenAI,2023年)仍有差距。这些模型的成功主要归功于结合了人类反馈的强化学习(RLHF)(如Schulman等人于2017年和Ouyang等人于2022年的研究),研究人员因此探索了各种改进RLHF的方法(如Yuan等人、Rafailov等人和Lee等人在2023年的研究)。
为了促进开源LLM的研究,Meta发布了Llama系列模型(由Touvron等人于2023年提出)。自那时起,基于Llama的开源模型如雨后春笋般涌现。一些代表性的研究方向包括使用指令数据对Llama进行微调,例如Alpaca(由Taori等人于2023年提出)、Vicuna(由Chiang等人于2023年提出)、Lima(由Zhou等人于2023年提出)和WizardLM(由Xu等人于2023年提出)。当前的研究还在探索如何提高基于Llama的开源LLM在代理(由Xu等人、Zeng等人、Patil等人和Qin等人于2023年的研究)、逻辑推理(由Roziere等人、Luo等人于2023年的研究)和长文本建模(由Tworkowski等人、Xiong等人和Xu等人于2023年的研究)方面的能力。
除了基于Llama开发LLM之外,还有许多努力投入到从零开始训练强大的LLM,例如MPT(团队于2023年提出)、Falcon(由Almazrouei等人于2023年提出)、XGen(由Nijkamp等人于2023年提出)、Phi(由Gunasekar等人和Li等人于2023年提出)、Baichuan(由Yang等人于2023年提出)、Mistral(由Jiang等人于2023年提出)、Grok(由xAI于2023年提出)和Yi(由01ai于2023年提出)。我们相信,开发更强大、更高效的开源LLM,以实现封闭源LLM的能力民主化,将是一个非常有前景的未来发展方向。
数据仍是核心
训练大型语言模型(LLM)是一个复杂且资源密集的过程,涉及数据收集和预处理、模型设计以及训练步骤。尽管开源LLM定期发布的趋势在增长,但领先模型的详细实践往往是机密的。以下是社区广泛认可的一些关键最佳实践。
在数据预训练阶段,通常使用万亿级别的数据Token,这些Token多来源于公开可获得的资源。从伦理角度考虑,排除含有私人个体信息的数据至关重要(如Touvron等人于2023年所述)。与预训练数据不同,微调数据虽然在数量上较少,但在质量上更加优秀。使用高质量数据进行微调的LLM表现出更优的性能,尤其是在专业领域(如Philippines于2023年,Zeng等人于2023年,以及Xu等人于2023年的研究)。
在模型架构方面,尽管大多数LLM采用仅包含解码器的变换器架构,但模型中引入了多种技术以提高效率。例如,Llama-2采用了Ghost关注机制来改善多轮对话控制(Touvron等人于2023年提出)。Mistral(由Jiang等人于2023年提出)采用了滑动窗口关注机制来处理更长的上下文。
在训练方面,使用指令调优数据进行监督式微调(SFT)至关重要。为了获得高质量的结果,数万条SFT注释通常就足够,这一点在Llama-2的27,540条注释中得到验证(Touvron等人于2023年)。这些数据的多样性和质量是关键(如Xu等人于2023年的研究)。在强化学习中的人类反馈(RLHF)阶段,近似策略优化(PPO)(由Schulman等人于2017年提出)通常是首选算法,以确保模型行为更好地符合人类偏好和指令遵从性,这对于提升LLM的安全性至关重要。PPO的一种替代方法是直接偏好优化(DPO)(Rafailov等人于2023年提出)。例如,Zephyr-7B(由Tunstall等人于2023年提出)采用了蒸馏DPO,在各种通用基准测试中展示了与70B级别LLM相当的性能,甚至在AlpacaEval中超过了GPT-3.5-turbo。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

