论文:CAR: Consolidation, Augmentation and Regulation for Recipe Retrieval
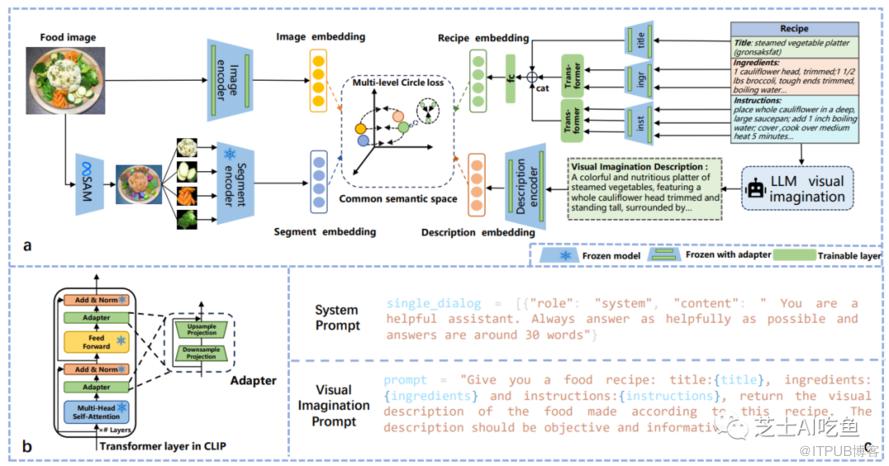
本文介绍了一种名为CAR的框架,用于跨模态食谱检索。该框架采用了三个新颖的技术:Consolidation、Augmentation和Regulation。其中,Consolidation技术利用了CLIP模型的预训练结果,并使用适配器层将其与更多的数据进行整合;Augmentation技术则通过SAM和LLM等基础模型对食谱和食物图像进行增强,以捕捉它们之间的视觉线索;Regulation技术则引入了圆环损失函数,用于调整跨模态嵌入空间中正负样本的权重分配。实验结果显示,在Recipe1M数据集上,CAR框架比现有方法表现更好。此外,作者还进行了广泛的消融实验,验证了每个组件的有效性,并计划将代码和模型公开发布。
论文方法
方法描述
该论文提出了一个基于CLIP模型和foundation models的跨模态食谱检索模型。具体来说,他们采用了Adapter layers来整合CLIP模型以增强其在跨模态食谱检索任务中的能力,并使用SAM和LLama2等foundation models来进行数据增强和信息提取。最后,他们使用了多圈损失函数来优化模型并提高其性能。
方法改进
相比于传统的fine-tuning方法,该论文提出的方案可以显著降低参数量,从而减少训练成本。此外,他们还引入了foundation models来增强模型的能力,使得模型能够更好地处理跨模态食谱检索任务。
解决的问题
该论文主要解决了跨模态食谱检索中的一些问题,如CLIP模型在该任务上的表现不佳、模型参数过多以及如何有效地利用foundation models等问题。通过采用他们的方法,可以在不增加太多参数的情况下提高模型的性能,同时还能充分利用foundation models的信息。
论文实验
本文主要介绍了作者在Recipe1M数据集上提出的跨模态食谱检索方法CAR,并进行了多组实验来验证其性能和有效性。具体来说,作者将CAR与现有的跨模态食谱检索方法进行了比较,并使用了不同的评估指标来衡量其表现。此外,作者还对CAR中的关键组件进行了分析和实验,以进一步证明其优势和局限性。
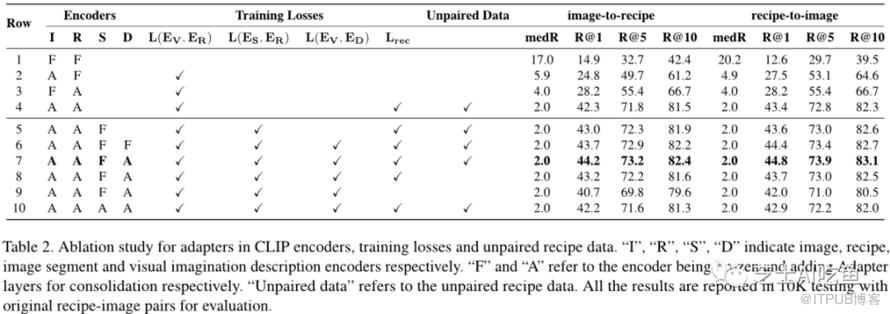
首先,作者将CAR与CLIP基线和其他跨模态食谱检索方法进行了比较。结果表明,CAR在大部分评估指标上都优于其他方法,包括CLIP基础模型的简单微调方法。这表明CAR通过插入轻量级适配器层,仅增加了8%的可训练参数,但仍能够学习到更具有区分性的食谱和图像嵌入向量,从而提高了跨模态食谱检索的性能。
其次,作者还进行了两组额外的实验,以探索CAR中不同组件的效果。第一组实验是在测试集中添加了额外的图像段和视觉想象描述,结果显示这种增强的方法可以进一步提高检索性能。然而,在另一组实验中,当同时增加图像段和视觉想象描述时,虽然图像至食谱检索性能略有提升,但食谱至图像检索性能却不如只使用图像段的情况。作者认为这是由于图像段中存在噪声所导致的。
最后,作者还进行了几个子实验来验证CAR中不同组成部分的有效性。例如,他们发现适配器层对于巩固CLIP模型并提高跨模态食谱检索性能非常重要。此外,作者还比较了使用圆形损失和三元组损失的结果,发现在相同的设置下,圆形损失显著优于三元组损失。
总的来说,本文提出了一种有效的跨模态食谱检索方法CAR,并对其进行了多组实验来验证其性能和有效性。这些实验结果表明,CAR能够在跨模态食谱检索任务中取得更好的性能,并且其各个组成部分也都具有一定的效果。
论文总结
文章优点
本文提出了一种名为CAR的新颖框架,用于跨模态食谱检索任务,并在Recipe1M数据集上取得了显著的性能提升。
该框架通过整合预训练的CLIP模型来增强食物领域的跨模态检索能力,并利用SAM和Llama2提取模态辅助信息以增强图像-食谱对之间的对齐度。
最后,引入多级圆损失函数来进行原始和增强数据的多目标优化,以规范化共同语义空间。
作者进行了详细的实验和对比分析,证明了所提出的CAR框架的有效性和优越性。
方法创新点
本文提出了三种新颖的技术:Consolidation(巩固)、Augmentation(增强)和Regulation(调节),分别对应于整合CLIP模型、使用基础模型进行数据增强以及引入多级圆损失函数。
在巩固CLIP模型方面,作者采用了轻量级适配器层,避免了繁琐的完全微调过程,同时保留了CLIP的强大能力。
在数据增强方面,作者利用视觉和语言基础模型对食品图像和食谱进行增强,包括使用SAM将图像分割成多个区域以匹配食谱中的关键食材,以及使用Llama2根据食谱输入生成描述食品外观的“视觉想象描述”。
在调节共同语义空间方面,作者提出了基于圆损失的多级圆损失函数,可以为正负样本分配不同的惩罚值,从而使训练更加灵活。
未来展望
本文的研究成果对于跨模态食谱检索任务具有重要意义,但仍然存在一些局限性,例如由于LLM的幻觉问题和SAM忽略小结构的趋势而导致的数据噪声等。
未来研究可以进一步探索如何解决这些问题,提高模型的鲁棒性和泛化能力。此外,还可以考虑将其他先进技术应用于跨模态食谱检索领域,如自适应学习、元学习等。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

