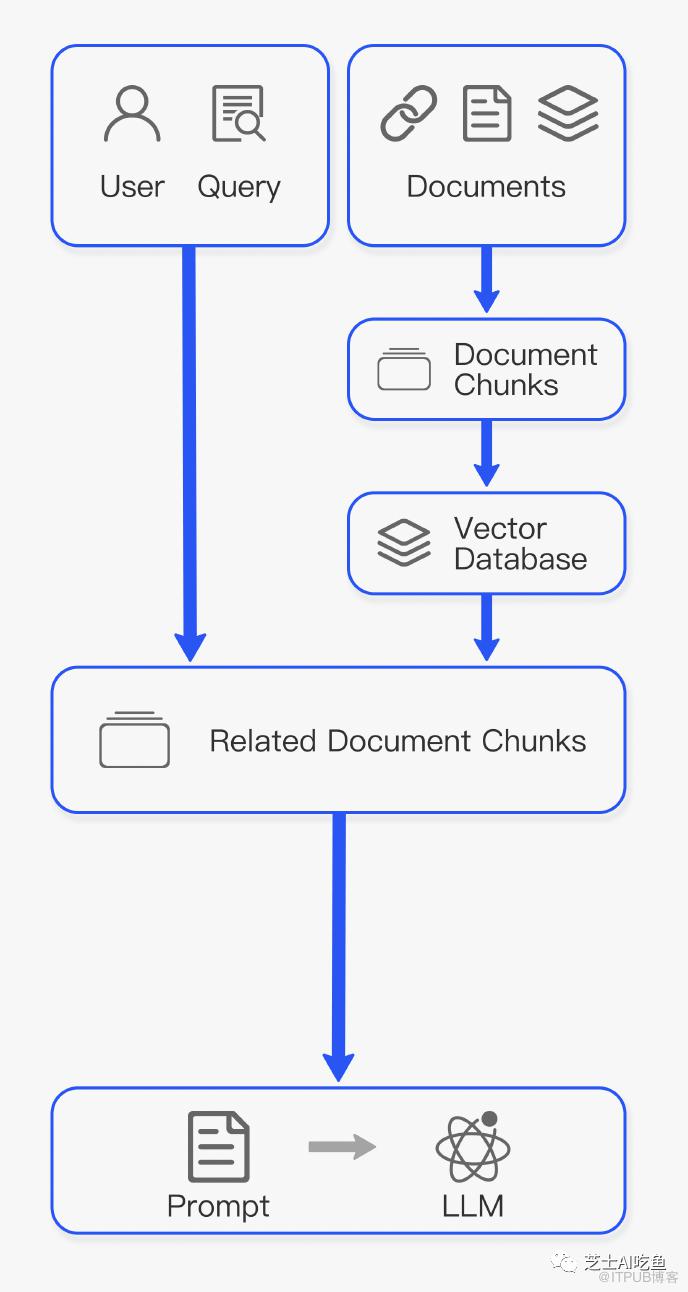
RAG研究范式不断发展变化。可以将其分为三种类型:初级RAG、高级RAG和模块化RAG。尽管早期的RAG成本效益高且性能优于原生LLM,但它仍然面临许多不足。高级RAG和模块化RAG的出现旨在解决初级RAG的特定缺陷。
1、初级RAG
初级RAG研究范式代表了最早的方法论,在ChatGPT广泛采用后不久就获得了显著的关注。初级RAG涉及传统过程:索引、检索和生成。初级RAG也被概括为“检索”-“阅读”框架。
索引
从源数据获取并建立索引的流程通常在离线状态下进行。具体来说,数据索引的构建包括以下步骤:
数据索引:这涉及清理和提取原始数据,将不同的文件格式如PDF、HTML、Word、Markdown等转换为纯文本。
分块:这涉及将加载的文本划分为较小的块。这是必要的,因为语言模型通常有处理上下文的限制,因此需要创建尽可能小的文本块。
嵌入和创建索引:这是通过语言模型将文本编码为向量的过程。生成的向量将在后续的检索过程中用于计算向量与问题向量之间的相似度。嵌入模型需要高速推理。
由于需要编码大量语料库并在用户提问时实时编码问题,模型的参数大小不应太大。生成嵌入后,下一步是创建索引,以键值对的形式存储原始语料块和嵌入,以便将来进行快速且频繁的搜索。
检索
在接收到用户输入时,使用与第一阶段相同的编码模型将查询转换成向量。计算问题嵌入与语料库中文档块嵌入之间的相似度。根据相似度水平,选择前K个文档块作为当前问题的扩增上下文信息。
生成
将给定问题和相关文档合并成新的提示。然后指派大型语言模型根据所提供的信息回答问题。可以根据不同任务的需求,决定是否允许大型模型使用其知识,或仅基于给定信息回答问题。如果有历史对话信息,也可以将其合并到提示中,用于多轮对话。
2、初级RAG的不足
初级RAG在三个方面面临主要挑战:检索质量、响应生成质量和扩增过程。
关于检索质量,问题是多方面的。主要关注的是低精度,其中并非所有检索集中的块都与查询相关,导致潜在的幻觉和空中掉落问题。次要问题是低召回率,当未检索到所有相关块时,就会出现这个问题,从而阻止LLM获得足够的上下文来合成答案。此外,过时的信息也是一个挑战,数据冗余或过时的数据可能导致不准确的检索结果。
在响应生成质量方面,问题同样多样。幻觉是一个突出的问题,其中模型捏造了一个在上下文中不存在的答案。不相关性是另一个问题,模型生成的答案未能解决查询问题。此外,毒性或偏见,其中模型生成有害或冒犯性的响应,也是一个问题。
最后,扩增过程也面临着几个挑战。关键在于,有效整合检索到的段落中的上下文与当前生成任务至关重要。如果处理不当,输出可能显得不连贯或支离破碎。冗余和重复是另一个问题,尤其是当多个检索到的段落包含相似信息时,导致在生成步骤中的内容重复。此外,确定多个检索到的段落对生成任务的重要性或相关性是一个挑战,扩增过程需要适当平衡每个段落的价值。检索到的内容可能也来自不同的写作风格或语调,扩增过程需要协调这些差异以确保输出的一致性。最后,生成模型可能过度依赖扩增信息,导致输出仅仅重复检索到的内容,而没有提供新的价值或合成信息。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

