摘要
许多自然语言处理研究人员正经历着一场由大型语言模型(LLM)的成功引发的存在危机。在我们对这个领域的理解发生了如此颠覆性的变化之后,还有什么可以做的呢?通过历史的眼光,我们可以从 2005 年开始的 LLM 第一时代中寻求指导,当时机器翻译的大型短语模型首次出现。我们从第一代中识别出持久的教训,更重要的是,我们确定了那些在 LLM 走向主导地位的领域中,NLP 研究人员仍然可以做出有意义贡献的永恒问题。在这些课程中,我们讨论了硬件进步如何塑造规模的可用性和重要性,以及质量评估面临的紧迫挑战,无论是自动化的还是人类的。我们认为规模不一致是暂时的,研究者们可以努力减少它们;数据仍然是许多有意义应用的瓶颈,而不是硬件;基于实际使用情况的有意义评估仍然是一个开放的问题;还有投机方法的空间。
1. 简介
想象一下这个场景:一位著名的NLP研究员在一个炙手可热的七岁科技初创公司走上舞台,发表主题演讲。演讲者向拥挤的房间描述了一个雄心勃勃的新系统,一直讲到结果幻灯片:条形图显示了训练词的数量,纵轴表示系统的准确性。随着每一个数据点的出现,性能不断提高,达到一个使用超过一千个处理器内核训练出的系统,使用了超过一百万亿个单词。它以一种以前被认为不可能的方式打破了最先进的技术。
与会者们在意识到,仅仅一分钟的时间,数年的研究工作就被彻底否定时,都显得非常震惊。埃斯特班说:
更多的数据就是更好的数据……
学术界人士感到恐慌,预计已经提交的资助申请将被全面拒绝。博士生们感到绝望,思考他们未完成论文的相关性。许多人考虑转行或换专业。这周他们会谈论其他事情。
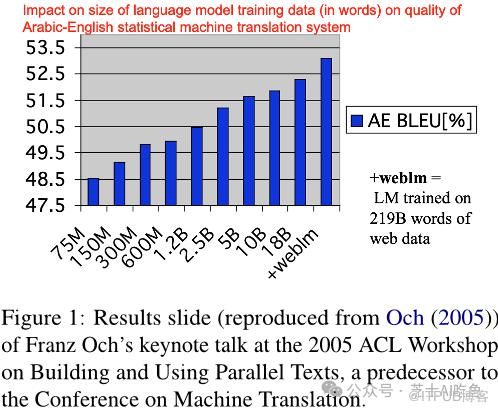
这个场景听起来像是过去一年发生的事情吗?事实上,它发生在18年前,也就是2005年。这是大规模语言模型(LLMs)的第一个时代:统计机器翻译(SMT)的时代。[1] 主讲人Franz Och与他人共同发明了关键方法在统计机器翻译中(Och和Ney,2003;Koehn等人,2003;Och,2003),但自2004年加入谷歌以来一直没有发表新作品,而是在发布谷歌翻译之前的一次邀请演讲中透露出来。[2] 演讲中的挑衅性结果幻灯片(图1)显示了Google如何仅仅通过对更多的数据进行基于短语的语言模型训练来改进其SMT系统。
虽然第一个时代的大规模语言模型最初引起了机器翻译研究人员对他们的领域的焦虑,但机器翻译研究在学术界、工业界和政府中继续蓬勃发展。即使在深度学习的现代时代,MT 仍然是改变自然语言处理 (NLP) 和所有机器学习的核心创新焦点(Bahdanau等人,2014年;Vaswani等人,2017年;Sutskever等人,2014年)。
我们相信这段历史为当今的大型语言模型时代提供了经验教训,这是一个许多任务都以大规模私有化模型作为事实基准的时代(Rogers,2023)。最先进的研究成本导致许多人质疑较小且由公共资金支持的团队在人工智能中的作用(Lee等人,2023),我们将这种现象称为规模危机。没有直接访问 LLM 的研究人员公开担心他们的研究方向,Togelius 和 Yannakakis(2023)建议在研究方向上进行转变以避免规模问题,Ignat 等人(2023)勾勒出“不在 LLM 范围内”的研究领域。但是,如果研究人员关心的是在 LLM 范围内的问题,他们应该怎么做呢?为了回答这个问题,我们回顾了第一个 LLM 时代。那个时代的持久经验是什么?今天仍然重要的常青研究问题有哪些?我们得出了一些反复出现的经验教训:
规模至上(第 2 节)。正如 Sut-ton (2019) 所预测的那样,我们看到了在计算和数据收集方面投资所带来的最大好处,因为通用方法利用规模会比利用有根据的先验知识的方法表现得更好。这一经验教训启发了我们的建议,即随着硬件的进步可以以负担得起的成本实现规模扩大(第 2.1 节),并记住小规模问题(第 2.2 节)。
评估是瓶颈(第3节)。这是苦涩教训的一个含义,因为最通用的方法需要反馈来优化。然而,这条规则也直接来自于改进模型,因为在剩余错误微妙且与边缘情况相关时,评估会变得更加困难。在大规模情况下,诸如BLEU之类的自动启发式方法暴露出它们的缺陷。这一经验教训告知了我们关于改善指标的建议(第3.1节)。
没有黄金标准(第4节)。当一个人负担得起注释成本时,可能会考虑人类反馈作为评估问题的理想解决方案。不幸的是,历史一再表明,寻求人类偏好的天真方法会导致糟糕的反馈,优先考虑模型输出的表面属性。这一教训可以与针对“痛苦的经验”而天真地收集大量低质量数据的冲动形成对比。人类反馈的历史告知我们在下游任务中具体衡量性能的建议(第4.1节)。
最后,我们认识到进步不是连续的(第5节),因为神经机器翻译的崛起突然结束了SMT十年看似不可战胜的增长。然而,即使可以预测SMT时代的结束,也可以通过预见新的基于硬件的方法来实现,因此我们建议研究人员继续探索可能在未来的硬件上扩展良好的新方法(第5.1节)。
在我们的结论中,我们的信息很简单:做研究(第6节)。我们提醒读者,工程成就并不会使科学成就变得不重要,并鼓励人工智能界即使在当前规模是主要因素的领域也要重新致力于基础科学研究。
2 规模至上
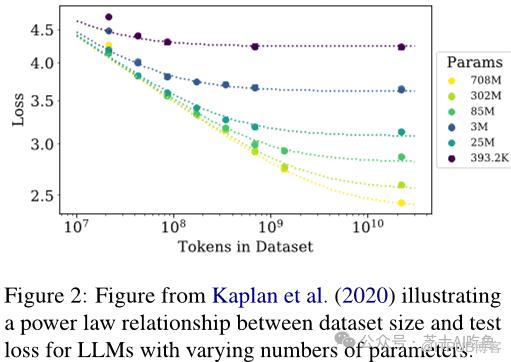
SMT 历史的第一课是,数据和计算规模是系统性能的主要因素。在 SMT 中,BLEU 的提高与训练数据量呈对数关系(Brants 等人,2007 年)。从图 1 可以立即看出:为了实现准确度的每个线性改进步骤(y 轴),训练数据量必须翻倍(x 轴)。图 2(来自 Kaplan 等人,2020 年)显示了训练数据量和系统性能之间具有惊人相似的对数线性关系对于 LLM。的确,这种关系在机器学习的许多应用领域中广泛存在,包括视觉(Mahajan等人,2018年,图2)和语音(Moore,2003)。
在以这些指标为中心的研究领域中,规模是性能的主要因素。4 最近由此产生的访问不平等导致了自然语言处理研究中的危机,其中最大、最富有的实验室主导会议论文发表,大型专有模型已成为许多任务的事实基准(Rogers,2023)。最先进的研究费用昂贵,这促使许多人质疑较小且由公共资金支持的团体在人工智能中的作用。随着最近发布的 LLM 的出现,这种规模危机愈演愈烈。在 OpenAI 在 2023 年 3 月宣布 GPT-4 后,Mulyar (2023) 在推特上发帖说他的信息流“充满了博士生的精神危机”。
Sutton (2019) 将我们目前在该领域看到的精神萎靡不振称为“苦涩教训”:“最终,利用计算的一般方法是最有效的,而且优势明显。”SMT 和 LLM 都体现了这一课 程,事实上,Sutton 明确地提到了自然语言处理。第一次经历苦涩教 训的研究人员可能会因为无法访问大规模系统而感到迷茫。然而,规模有 限,并且这种差异往往是暂时的。我们讨论了相信规模危机不是永久状 态的理由。
2.1 遵循硬件。
基于规模优势,我们建议利用硬件方面的进步,而不是满足于接受差距过大。
随着谷歌翻译的发布,大规模商业系统主导了英语翻译排名,在那里数据是丰富的。
多年以来,由于硬件和软件的进步,SMT 翻译的质量一直停滞不前(Callison-Burch等人,2009年、2010年、2011年、2012年)。开源工具如 Moses(Koehn 等人,2007 年)以及汇集了小型实验室资源的合作缩小了差距,但直到 2013 年,当一个学术团队使用适度的硬件以令人信服的方式赢得了英语翻译比赛时,这一差距才得以弥补(Bojar 等人,2013 年)。决定性的工具是 KenLM,它是一个高效的语言建模库(Heafield,2011;Heafield 等人,2013),它证明了正确的软件可以大大降低 LMM 训练的成本。SMT 规模危机的结束是硬件和软件进步的几个趋势的结果。
如果没有算法进步,增加训练数据资源需要相应地增加计算资源。这一现实有利于规模,因为Sutton(2019)指出,“在比典型研究项目稍长的时间内,大规模的计算不可避免地变得可用。”换句话说,如果数据丰富,那么通用方法将在硬件可以处理它的那一刻占主导地位。由于摩尔定律,计算能力每半年翻一番,在过去的六十年里一直是这样,这意味着通常在几年内就会出现这种情况。只要摩尔定律继续有效,资金充足的研究人员将继续扩大系统。
尽管摩尔定律可能会让许多面临计算瓶颈的研究人员感到安心,但任何时候,规模都受到可用硬件的限制。Brants等人(2007) 的论文标志着对 Web 规模数据进行缩放图灵机模型的短暂竞赛(张等,2006;Emami 等,2007)的结束,该竞赛利用了之前的硬件进步。
MT 研究人员已经忽视了这一问题,并将其推向极限。同样,当前的 LLM 时代是在快速扩展超过硬件改进的一段时间内形成的:在过去的十年里,计算要求以少于一年的速度翻了一番(Sevilla等人,2022 年),一些人估计它实际上增长得更快。这比摩尔定律快得多,后者继续下去的可能性不确定,制造商正在接近支撑它的已知物理方法的极限,并寻求新的方法来绕过它们(Lundstrom 和 Alam,2022 年)。虽然硬件将继续改善,但它最终将成为继续扩大 LLM 的瓶颈。据估计,目前最大的 LLM 的训练可能需要太比特浮点运算 (1024 flops) ,该领域可能已经接近这个瓶颈。相比之下,截至本文撰写时,世界上最快的超级计算机的速度仅为每秒一千万亿次浮点运算 (10^18 flop/s) 。[7] [8]
SMT 规模危机的结束 在 2005 年 LLM 的第一个时代开始时,绝对不是必然的或可预见的:它是许多研究人员的努力的结果。我们受到启发,看到一个类似的轨迹的基础现在正在形成。随着较小群体监控硬件的发展,初创公司已经向公众宣传廉价的大规模训练(Portes等人,2023)。就像在 SMT 时代与商业翻译软件竞争的团队一样,大型跨机构合作目前正在汇集资源来构建公共模型(Scavo 等人,2022)。围绕高效机器学习形成了一个社区,催生了新的出版物场所,如 MLSys,并开发出更多已经在许多 LLM 中使用过的高效算法。BERT(Devlin 等人,2019)在发布时被许多人认为对小型学术实验室来说难以接触,现在可以在一台消费级 M1 MacBook 上运行(Roesch 和 Mazenette,2021)。
简而言之,如果小实验室对使用最先进的模型感兴趣,他们不需要完全放弃他们的研究方向。算法效率通常在不同的资源规模下保持一致,因此开发于不计成本的方法
因此,所有研究人员都可以寻求合作机会并开发更好的算法。
2.2 记住小问题
虽然直接解决规模问题是一种策略,但我们还建议研究那些数据而非计算能力才是瓶颈的问题。
小规模场景为数据驱动的方法提供了创新的肥沃土壤;在过去的语言模型时代,SMT 研究人员经常使用语言结构来改进当使用更少的数据时的表现。当这些方法在这种开发环境中显示出希望时,谷歌翻译不可避免地会在工业规模上测试它们。然而,在其生命周期结束时,谷歌翻译的 SMT 系统仍然是一个基于短语的查找表。经典 SMT 研究者的探索没有导致任何基于语法或语义的持久发明,因此假设由此产生的改进可以转移到大规模设置上的想法可能只是基于不切实际的乐观主义。与他们的前辈不同,现代 NLP 研究者预先认识到扩大数据驱动方法是没有意义的,因为许多他们提供的改进已经由规模提供。然而,我们现在过于悲观地吸取这个痛苦的经验教训,我们可能会忽视那些出于实际或财务原因必须从有限的数据中学习的环境。
当谷歌翻译推出第一个时代的语言模型时,它只在阿拉伯语和英语之间可用。数据是SMT在许多有意义的问题上的应用之间的瓶颈,包括最明显的是许多其他语言对之间的翻译。解决这个瓶颈需要许多研究人员的努力,包括收集欧洲议会语料库(Koehn, 2005)和努纳武特汉莎德语料库(Martin等人,2003年),海地地震后海地克里奥尔语语料库的快速发展(Lewis, 2010),为许多阿拉伯方言收集语料库(Zbib等人,2012年),以及开发用于平行文本的开源网络爬虫(Smith等人,2013年)。今天仍在进行中由Masakhane(Adelani等人,2022;Nekoto等人,2020;Emezue和Dossou,2021)和No Language Left Behind(NLLB团队等,2022)领导的项目。然而,机器翻译仍然是不可能的世界上估计有 7000 种语言,但只有其中极少数被计算机所理解。
正如没有人会在2006年声称谷歌已经解决了所有的翻译问题,也没有人应该在今天声称 LLM 已经解决了所有自然语言处理的问题。11 当前的 LLM 时代也存在着相同的瓶颈,主要由像聊天 GPT 这样的以英语为主导的系统主导。虽然这些模型可以处理许多语言,因为任何大型训练语料库都是偶然地多语言(Blevins 和 Zettlemoyer,2022),但训练数据主要是英语,学习从人类反馈中学习的监督数据则主要是来自说英语的肯尼亚人(Perrigo,2023)。英语的霸权地位使它成为默认选项,促使创造了“始终命名您正在使用的语言”的本德规则(Bender,2019)。
正如自SMT时代以来,MT研究人员所做的那样,如今的LM研究人员正在开发工具(Abi等人,2022;Meyer等人,2022;Park等人,2021),以展示如何通过考虑规模远不如其他因素相关的模式来推进NLP。研究者可以利用与当地语言学家的国际合作、利润之外的激励措施以及非商业资源,扩大使用他们自己的语言获得技术的人群。然而,随着计算成本的不断下降,即使是当前大型语料库在未来高度过参数化的模型中也将变得相对“低资源”。为了更有效地利用这些数据集,我们将注意力转向了AI中的一个永恒需求:质量评估指标。
评估是瓶颈
对SMT时代进行反思所提供的下一个教训是,评估方法的质量对于训练的有效性产生了重大影响,因为一个好的评估可以被用作训练信号。在SMT中,这一顿悟是由最小错误率训练提供的,它直接针对诸如BLEU(Och,2003)等目标指标进行训练。同样地,在训练时间反馈度量通常会适应测试时间评估:语言模型、人工评分或人类评估,它们为自动评估提供了基准,并使人们能够检查系统的性能是否达到了预期水平。
语言建模的性能可以通过验证损失或等效的困惑度直接衡量。因此,可以使用对称评估来轻松地应用相同的指标来计算训练反馈和测试时间性能评估。因此,评估指标成为提高模型质量的关键杠杆。
在工业(StabilityAI,2021;Thoppilan等人,2022)和非营利部门(Biderman等人,2023;Scao等人,2022)花费数百万美元培训大型科学项目的同时,指出其他系统性能瓶颈而不是规模可能令人惊讶。由于对于任何给定的计算预算,存在一个产生最准确模型的最佳训练数据量(Hoffmann等人,2022),因此关注规模瓶颈是有道理的。因此,无论是计算能力还是数据大小都可能成为限制因素,并且仍然存在计算方面的财务障碍(Lee等人,2023)以及结构化自然语言数据可用性的局限性(Villalobos等人,2022)。然而,为了训练,数据和计算资源必须连接起来,评估形成了这种联系,决定了训练的有效性。
在最一般的表述中,评估可以被看作一个奖励函数r,作用于模型输出y以及一些表示可用于评估的资源的全局上下文C:
评估可以自动或人为地从源头获取;形式上可以是一维或多维的;通过直接反馈或与某种真实情况对比获得。
训练本身也是一种重复评估的行为。例如,交叉熵损失可以被看作使用全局上下文(ground-truth label)y*作为奖励函数的评估。
当训练直接使用人类反馈,如Likert评分时,奖励函数的上下文人类反馈机制和奖励直接表示为人类反馈分配的分数。因此,训练期间的评估可以基于与真实世界的比较,如传统培训;仅根据输出的质量估计,如在强化学习中经常使用的方法(Konda 和 Tsitsiklis,1999 年;Silver 等人,2014 年;Bai等人,2022 年 b);或直接反馈,由 RLHF 和相关的人类评估方法提供(Ziegler 等人,2019 年;Stiennon 等人,2020 年;Ouyang 等人,2022 年;Bai 等人,2022 年 a)。
不幸的是,对于有效的自动评估方法来说,自动度量通常无法预测人类评价,如语言建模损失(Liu等人,2023)和BLEU(Reiter,2018)。即使一个稍微反映训练目标的指标也可以人为地夸大模型性能;例如,很早就有观察到,像BLEU这样的基于短语的评估指标可能会偏爱基于短语的SMT(Riezler和Maxwell III,2005)。识别好的指标具有挑战性,并且随着每一次改进而变得更加困难,因为剩余的错误变得越来越微妙。这在早期的SMT中也被认识到,呼吁“BLEU ++”(Och,2005)。
因此,评估已成为现代语言模型研究的一个关键目标。虽然训练通常依赖于交叉熵损失或其他简单的序列中每个标记之间的比较,但对训练好的语言模型进行基准测试通常使用不同的评估标准,例如检查一个单词问题中的最终答案或基于提示的分类器的准确性(Laskar等人,2023)。然而,这些测试受到数据污染的影响:在训练期间暴露于基准测试已经为从代码生成(Khan等人,2023)到心理理论难题(Ullman,2023)的任务带来了幻觉性的收益。显然,语言模型正在改进,但我们不能确切地说出它们是如何以及多少。
3.1 改进指标
由于评估是一个瓶颈,我们建议更加关注提高评估指标,这是一个无论是否能够获得全面培训的目标,都可以带来回报。相比之下,计算基础设施的直接增加和原始数据收集带来的投资回报率可预测地减少。评估提供了一个概念空间,可以对创新和仔细的工作给予奖励,并为系统能力的新见解和未知改进提供动力。什么是
这个空间的基本问题是什么,我们该如何解决?
自动度量和静态基准之所以不是好的评估方法的一个论点是,它们在测量建模上失败了;也就是说,这些指标并没有真正衡量它们所声称要衡量的内容。这种担忧反映在反对不能反映人类评价(刘等人,2016年;Novikova等人,2017年)或更广泛地改善自然语言理解(Raji等人,2021年)的基准和指标中。这些讨论与机器翻译社区对研究发现自动化指标(如BLEU)并不总是与人工判断相关联时的不安情况相似(Callison-Burch等人,2006)。作为回应,SMT看到了一系列逐步改进的双语语料库基线指标(Stanojevic 和 Sima'an,2014;Popovic,2015;Mutton 等人,2007)。在标度危机中,利用诸如双语文本等自然可用数据来提高评估指标可以是一个有价值的关注点。
不幸的是,用于计算指标的自然可用数据集仍然可能污染训练语料库。此外,依赖静态真实度的自动指标无法反映一般质量(Raji等人,2021),模型在交互式部署下的条件,或为强化学习提供基于策略的奖励反馈。这些问题激励了不需要真实度的自动指标的工作,尽管基于人工智能监督的建议本身也很难评估,因为它们面临着相同的数据集偏差和污染问题。
尽管研究界强烈希望改进它们,但即使是最优秀的自动度量也远非完美。随着自动化指标和静态基准的失败,拥有资源的研究人员越来越多地雇佣人类来评估模型输出。在SMT中面临类似挑战时,研究人员还要求优先考虑人工评价,无论是用于基准测试(Callison-Burch等人,2006年,2007年)还是训练(Hopkins和May,2011)。然而,人工评价并不从根本上解决测量建模的问题,并提出了自己的挑战。
4. 没有黄金标准
语言是为了被人类理解而产生的。这一事实使我们陷入了这样一个诱人的神话:我们可以很容易地通过询问一个人类来评估合成自然语言输出。相反,我们从SMT时代讨论的下一个教训是,人类注释不能提供一个普遍的“黄金标准”的质量反馈。当机器翻译比赛自豪地把人类评估作为选择赢家的最高质量和最可靠的选择时,批评者指出,这些评估未能满足公平排名所需的一致性基本期望(Bojar等人,2011;Lopez,2012)。甚至征求有用的人类意见,更不用说完美的评价,结果证明需要仔细考虑和权衡决策。
从业者经常依赖于一些朴素的方法来收集对 LLM 输出的人类反馈,例如单一的评分量表或根据质量对模型输出进行排名,这些方法并不能区分注释者为什么更喜欢特定的模型输出,因此提供的指导有限。例如,OpenAI 的 ChatGPT 注释器界面要求用户将输出从“最好”到“最差”排序(刘等,2022)。Anthropic 添加了额外的维度,但提供了有限的指导,因为注释者评估生成文本在多大程度上“有用”和“有害”,声称这些指南的模糊性允许多样化的偏好(白等,2022a)。
然而,NLP社区正在重新发现,以这些天真的方式获取人类偏好会产生不仅噪声大,而且在基于这些数据训练的模型中产生系统性错误的数据。当许多文本质量维度合并为一个偏好尺度时,某些维度表现较差的输出可能会因为其他维度上表现良好而获得更高的评分。在这种情况下,注释者通常会优先考虑连贯性而不是文本的其他方面,例如事实或一致性(Clark等人,2021)。因此,语言模型同样优先考虑大型语言模型输出的连贯性而非事实性(Ji等人,2023),这与SMT时代模型优先考虑连贯性而非语义充足性或翻译的准确性所引起的担忧相呼应(Dorr等人,2011)——这些问题已被实证研究所证实(Martindale和Carpuat,2018)。Belz和Hastie(2014)和van der Lee等人(2021)都指出,生成文本的整体质量往往“过于抽象”,无法衡量,并建议使用针对文本不同维度的不同标准。因此,要求注释者对文本进行多维评分有助于区分模型输出中存在的具体问题。Gehrmann等人(2023)和van der Lee等人(2021)警告说,模糊的注释指南会加剧——悲剧先于解析:在大型语言模型的新时代,历史重演了指出了评价文本质量时明确界定不同维度的重要性。
尽管对评估过程进行了这些改进,机器翻译的人工评估仍遇到了一些尚未解决的问题。目前的研究表明,当前模型的评估也将越来越多地遇到类似的问题,包括:
指定评估标准很困难。即使在多个维度上分离出评估标准,这些分数也是相关的,表明人类评估者很难区分诸如适当性和流畅性等标准(Novikova 等人,2018 年)。此外,许多研究没有定义他们的轴(van der Lee 等人,2021),这使得评估者对任务的解释存在更大的差异,并增加了注释者的变异性。也就是说,分离评估轴是必要的,但不足以识别模型输出的多种理想特征,这是机器翻译历史上的一个反复出现的问题(Chatzikoumi,2019)。即使可以明确地定义评估标准,众包注释者也常常缺乏遵循它们所需的必要专业知识。因此,众包工作者与专家注释者之间的对齐效果很差,甚至比自动评估指标表现更差(Freitag 等人,2021)。通过为多个目标定义并咨询专家注释员而不是众包工作者,可以解决一些,但不是所有客观规范方面的问题。
个人偏好不一致。经典的SMT结果揭示了人类评价中的另一个基本问题,即对齐的两两排名往往不能产生一致的输出顺序(Bojar等人,2011;Lopez,2012)。因此,任何基于比较输出的方法都反映了对人类偏好的一致性不切实际的期望。排名提供了信号,但信号本质上是嘈杂的。
分歧不仅仅是噪音。当人类评估者对文本质量产生分歧时,这不一定反映“噪音”或“随机变化”,而是评估者之间真正的意见差异(Larimore等人,2021;Patton等人,2019;Prabhakaran等人,2021;Pavlick和Kwiatkowski,2019),这是长期困扰机器翻译评价的问题(Lommel等人,2014)。
普拉巴卡尔等人 (2021) 指出,研究中对少数群体的观点进行模糊处理,而使用标注者间一致性作为质量度量会导致观点被进一步抹去,因为会否认这些优先事项是有争议的(布洛德格特,2021)。
这些问题共同阻碍了人类评价对模型输出提供明确反馈。几十年的研究表明,这些问题是机器翻译的主要关注点,这说明当前的研究人员不应低估这些问题带来的挑战。此外,任务定义和意见不一致的问题可能对评估目前可以处理更多样化任务的模型更为重要。虽然流利性和忠实于源文可能是机器翻译的主要关注点,但生成文本必须满足更广泛的准则,如信息量和连贯性(van der Lee等人,2021)。这些要求,以及在包括社会、道德和政治问题在内的现实世界中存在分歧的主题上产生文本的更大自由度(Abid等人,2021;Blodgett等人,2020;刘等人,2021;赵等人,2021),意味着人类评价问题将是自然语言处理社区需要解决的紧迫问题。
4.1 关注具体的任务
由于基于人类评估的评价固有的缺陷,我们建议在部署环境中测量具体的任务。外部评估(Belz 和 Reiter,2006 年),其中根据特定下游应用的效用对模型输出质量进行评估,在文本生成的评估中仍然罕见(van der Lee 等人,2021 年)。然而,它们可能对于评估内容或意义的质量更有用(Reiter 和 Belz,2009;Reiter,2023)因为人类评估往往无法预测下游应用的表现(Kunz 等人,2022 年)。
在机器翻译中,下游具体任务已经形成了一系列指标的基础。Snover等人(2006)研究了参与者需要编辑多少来自机器生成的文本才能与参考文本相匹配,这反映了人机协作场景的理想情况。其他指标依赖于用户使用模型输出完成特定任务的能力,例如根据翻译回答阅读理解问题(Scarton 和 Specia,2016),或总结(Wang 等人,2020)。
一般来说,最好的评价很可能会依赖于对 LLM 所能做的现实评估。在现代 LLM 中,评价挑战的工作可能会借鉴人机交互的见解。13 优秀的用户测试需要仔细的设计研究,并考虑到人类的多样性,以及对个体心理的理解。
5 进步不是连续的
我们的最后一课是,新的范式可以解锁新的规模顺序,甚至新的扩展系数,从而导致性能的突然提高。由大词汇模型推动的SMT时代持续了十多年,随着时间的推移,规模提供了越来越多的改进。但由于Dennard缩放的崩溃,摩尔定律在这个时代受到了威胁,这是一个观察结果,即较小的晶体管需要相应较少的能量,这意味着它们可以在保持功耗不变的情况下缩小。为了在Dennard缩放后继续改进,硬件制造商专注于并行化。GPU(青睐代码的高度并行性,分支最少(因此更简单、更小的处理器)),突然被重新用于训练神经网络,正如Hooker (2020) 所述。
神经网络在统计机器翻译中已经被研究了很多年。事实上,它们最早用于SMT是在Schwenk等人(2006)——以及更晚的Devlin等人(2014),其ACL最佳论文奖标志着NLP界对神经网络态度的重大转变——使用Bengio等人(2003)的神经n-gram模型构建解码器时。但是GPU计算能力的提高和在训练神经网络中的应用推动了端到端神经机器翻译(NMT)的新研究,使Kalchbrenner和Blunsom(2013)能够重新振兴甚至更早的编码器-解码器架构(1997年)想法。随后出现了诸如注意力(Bahdanau等人,2014年)、seq2seq(Sutskever等人,2014年)和transformers(Vaswani等人,2017年)等进步,在短时间内掀起了一股热潮。两年内,NMT席卷了年度共享任务(Jean等人,2015;Chung等人,2016;Bojar等人,2016),并于2016年宣布Google翻译。
GPU 通过创造有利于深度学习的条件,有效地引入了一种新的主导范式。库恩(1962 年)将科学进步描述为科学革命的循环,在这种循环中,诸如短语基机器翻译 (SMT) 或深度学习之类的范式出现,然后在研究人员旨在应用、阐述并扩展范式的事实基础的正常科学研究时期之后。通常,科学革命是由新工具的可用性引起的。胡克 (Hooker) 在 2020 年利用这一科学革命框架分析了人工智能研究的现状,发现硬件彩票是一种硬件决定方法的情况。在硬件彩票下,GPU 提供了一个重塑机器翻译的深度学习成功之道。我们能从神经机器翻译革命中学到什么?
5.1 调整硬件
硬件彩票告诉我们,硬件指导研究方向,但研究人员也可以指导硬件设计。我们可能会看到更多科学革命在我们的领域内出现,并通过新工具来实现。然而,如库恩(1962)所指出的,新工具的发展本身受到当前范式和正常科学过程的影响。因此,我们建议研究人员不仅要关注开发和使用新的硬件,还要预测潜在的硬件发展。
研究人员可以创建软件工具和算法,利用针对稀疏性设计的硬件(Krashinsky 等人,2020 年)或新的并行源(Launay 等人,2020 年),为未来的技术预先开发技术。与此同时,他们还创造了一个市场,激励新硬件的发展,使下一代革命性发展成为可能。研究人员甚至可能会共同设计硬件和软件,这种策略很可能会推动未来的计算进步(Leiserson 等人,2020;Lundstrom 和 Alam,2022)。正是对未来工具进行重新塑造的可能性,使得在比例危机下探索替代范式变得值得。
6. 结论:开展研究
随着纯粹的工程努力和机构财富超过了新的科学工作,一些人工智能科-
社区对基础研究的前景持悲观态度。我们的立场是在本文中阐述的,即仍有很多令人兴奋且及时的工作要做。
这些教训并不局限于 LLM,而是适用于任何受苦涩教训影响的领域。例如,在机器学习的许多学科中,人类评估的问题令人头疼。在计算机视觉中,注释者的个性特征解释了现代 ImageNet 模型中的许多剩余不准确性(Shankar 等人,2020 年)。如果像图像分类这样的有约束的标签任务受到各种人类判断的影响(Parrish 等人,2023 年),那么标注自由文本生成会困难多少?
除了针对有兴趣提高语言模型能力的研究人员的具体建议之外,我们还将指出相关领域的科学机会。从可解释性到经验训练分析再到公共政策,许多研究领域随着模型的迅速改进而变得更加重要和复杂。此外,虽然新颖的建模工作在规模危机中受苦,但我们可以专注于利用现有硬件甚至预测未来工具的新架构和算法。
一些基于短语的统计机器翻译的推测性替代方案,例如明确建模语法(Galley等人,2004;Collins等人,2005;Chiang,2007)和语义(Jones等人,2012),在苦涩的经验中被证明是行不通的,并且通过神经机器翻译得到了表达。然而,其他建议为神经机器翻译时代奠定了基础。许多持久的职业生涯是在现在已经被遗忘的领域中形成的自然语言处理研究,如果没有对未经验证的方向进行风险探索,该领域可能无法取得许多突破。我们的焦虑不应阻止我们抓住大规模语言模型新时代带来的机遇。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

