原文:HyperLLaVA: Dynamic Visual and Language Expert Tuning for Multimodal Large Language Models
本文介绍了一种新的多模态大语言模型(Multimodal Large Language Model,MLLM)——HyperLLaVA,通过动态视觉和语言专家调整投影器和语言模型参数,并使用超网络生成适应性参数变化,从而实现动态投影器和语言模型建模。实验结果表明,与传统的静态调优策略相比,HyperLLaVA在多个下游任务上表现更好。
论文方法
方法描述
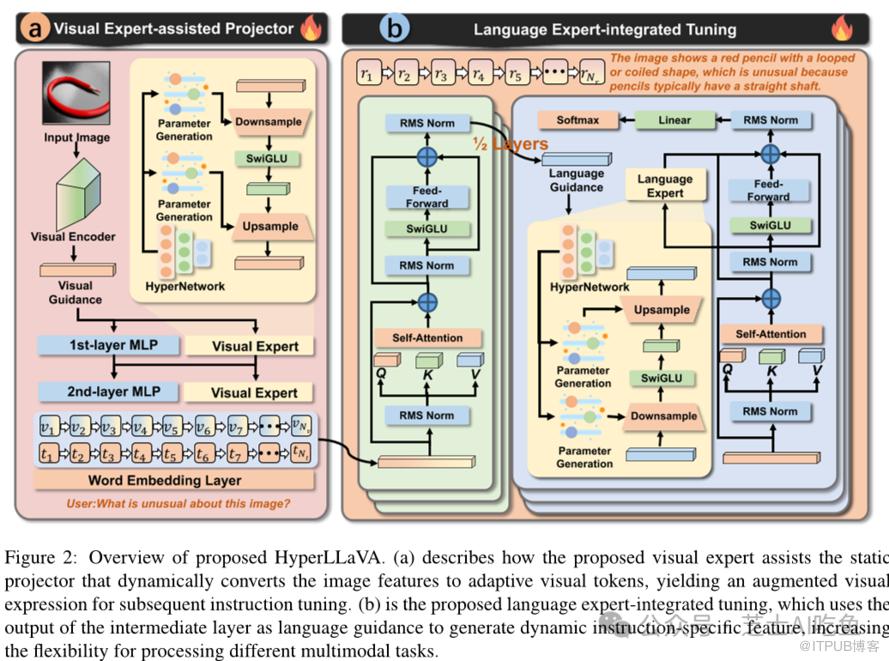
该论文提出了一种名为HyperLLaVA的多模态预训练模型框架,用于将视觉信息与文本信息结合起来,以增强下游任务的表现。该框架由两个模块组成:视觉专家模块和语言专家模块。视觉专家模块通过适应性地调整投影器的输出来适配特定的视觉指导,并动态地建模视觉特征;语言专家模块则通过自适应地调整语言模型的后向块输出来动态地建模语言特征。这两个模块都使用了超网络来实现动态学习。
方法改进
该方法改进了原有的LLaVA模型,通过引入视觉专家和语言专家模块,使模型具有更强的视觉和语言理解能力。此外,该方法还采用了输入先验引导和超网络意识适配器等技术,进一步提高了模型的性能。
解决的问题
该方法解决了传统多模态预训练模型中静态参数限制灵活表达、无法处理复杂多模态任务等问题,能够更好地适应不同的下游任务需求。同时,该方法也提供了一个新的思路,即如何利用超网络来实现动态学习。
论文实验
本文主要介绍了对多模态视觉问答(VQA)任务的研究,使用了名为HyperLLaVA的模型,并对其进行了多种对比实验以验证其有效性。以下是各个对比实验的具体介绍:
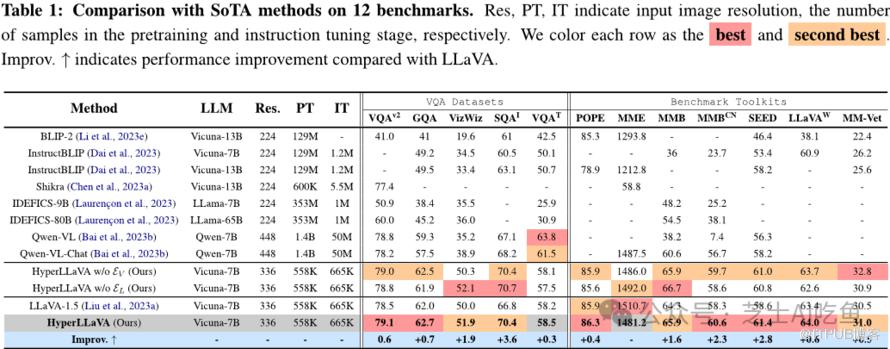
对比方法选择:为了量化HyperLLaVA的效果,作者选择了多个SOTA方法作为对照组,包括BLIP-2、Instruct-BLIP、Shikra、IDEFICS等,并在不同的数据集上进行了比较。
总体性能:作者将HyperLLaVA应用于广泛的学术VQA基准和最近专门设计用于指令遵循MLMs的基准,共计12个基准。结果表明,与LLaVA相比,HyperLLaVA在几乎所有的多模态场景中都取得了更好的性能,这表明其具有很强的泛化能力。此外,HyperLLaVA还优于具有数十亿可训练参数的大规模MLLMs,如80B IDEFICS,进一步证明了其有效性和优越性。
Ablation研究:该部分分析了每个组件的有效性,包括视觉专家EV和语言专家EL。结果表明,单独使用EV或EL都会带来明显的性能提升,而同时使用所有组件则会取得更稳定的改进效果。
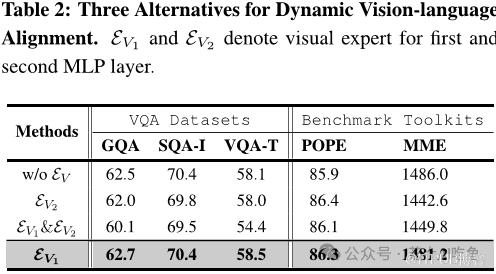
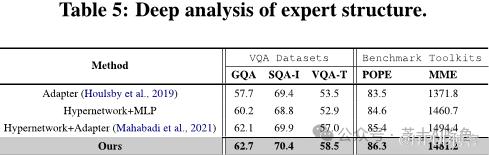
深入分析:该部分针对两个问题进行了深入分析。首先,通过比较三种视觉专家辅助投影方案的结果,发现使用一个视觉专家访问动态投影可以获得最佳结果。其次,通过对不同层插入语言指导的影响进行分析,发现在后16个层集成语言专家可以得到最好的性能表现。
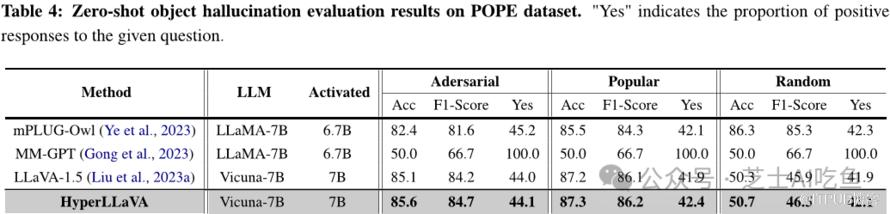
综上所述,本文通过多项对比实验验证了HyperLLaVA的有效性和优越性,并对其组成部分的有效性进行了深入分析。这些实验结果为多模态视觉问答任务的研究提供了重要的参考价值。

论文总结
文章优点
本文提出了HyperLLaVA模型,通过动态调整投影器和语言模型参数来提高多模态学习系统的性能。该模型使用视觉和语言专家模块来自适应地调整投影器和语言模型参数,并且具有可扩展性和灵活性。此外,作者还进行了详细的实验验证了所提出的方法的有效性和通用性。
方法创新点
本文提出的HyperLLaVA模型采用了动态调整投影器和语言模型参数的方法,与传统的静态参数调整方法相比,能够更好地适应多模态任务的需求。同时,作者引入了视觉和语言专家模块,使得模型更加灵活和可扩展。这些创新点为多模态学习系统的发展提供了新的思路和方向。
未来展望
本文提出的HyperLLaVA模型为多模态学习系统的发展提供了一个新的思路和方向。未来的研究可以进一步探索动态调整机制的可扩展性和泛化能力,以实现更高效、更准确的多模态信息处理。同时,也可以将这种方法应用于其他领域的研究中,如自然语言处理、计算机视觉等。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

