对于现代深度学习模型训练来说,高质量数据是至关重要的燃料。任务特定的标签数据大多来自于人工标注,例如分类任务,或者 LLM 对齐训练中可以转换为分类格式的 RLHF 标注。文章中提到的许多机器学习技术都有助于提高数据质量,但从根本上说,人类的数据收集需要注重细节并仔细执行。业界普遍认识到高质量数据的重要性,但不知不觉中存在着一种微妙的印象:“所有人都想做模型方面的工作,而不愿去做数据方面的工作”(Sambasivan等人,2021 年)。
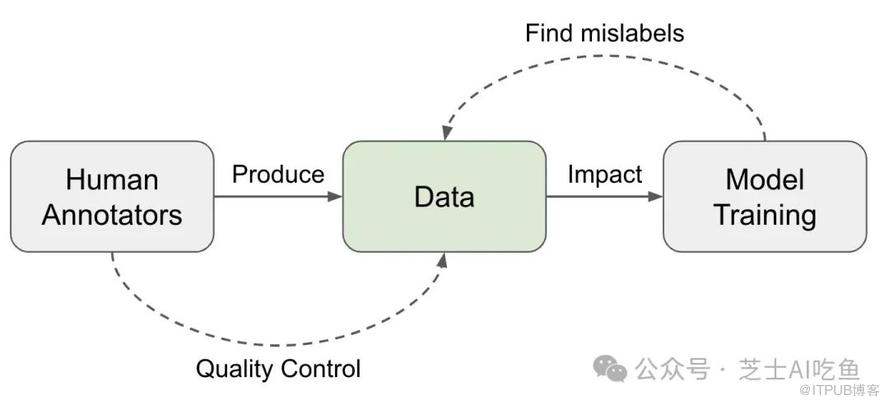
人工标注者 ↔ 数据质量
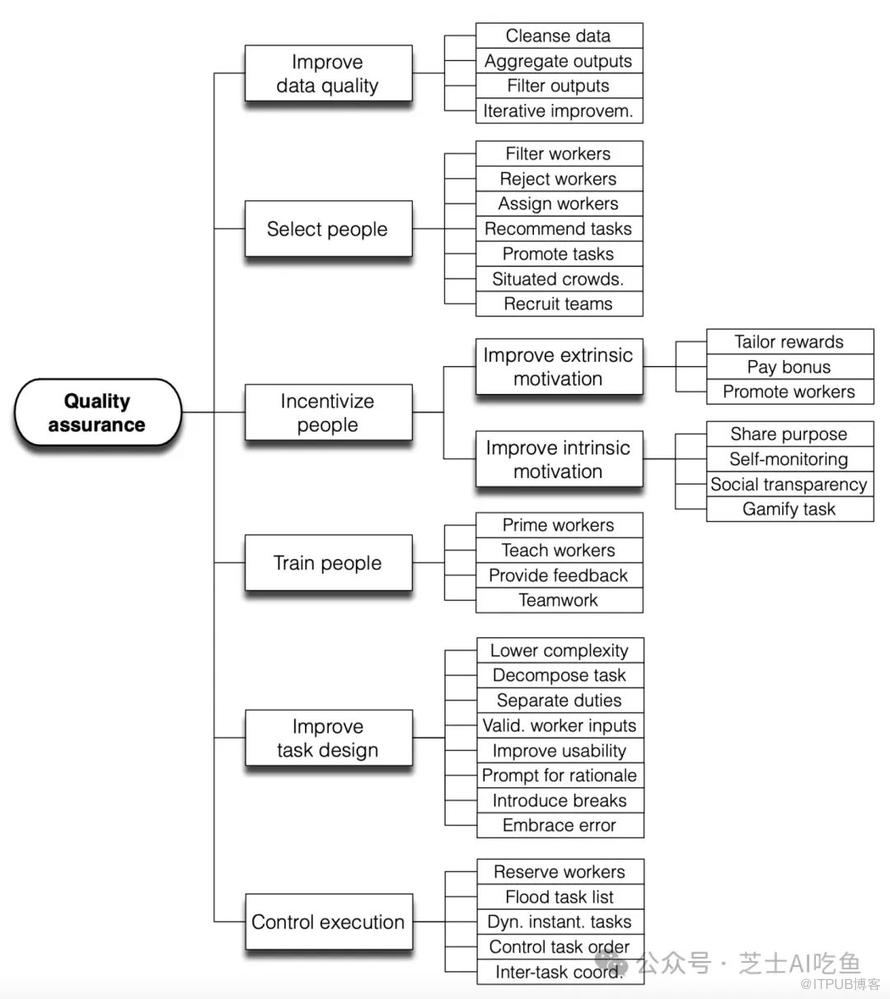
人工数据收集包含一系列操作步骤,每个步骤都会影响数据质量:
任务设计: 设计清晰易懂的任务流程,降低复杂性。详细的指导方针固然有用,但过于冗长复杂的指南反而需要大量培训才能发挥作用。
标注者选拔和培训: 选择技能匹配、标注结果一致的标注者。培训环节必不可少,培训完成后还需要定期提供反馈并进行校准环节。
数据收集和汇总: 这一阶段可以引入更多机器学习技术,用于清理、过滤和智能整合数据,以识别真正的标签。
点击链接查看剩余内容
从数据中挖掘真相的五个思考
https://articles.zsxq.com/id_gprfjnxebkek.html
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。
下一篇:
如何更加淡定的面对滚滚大模型的潮流

请登录后发表评论
登录
全部评论
