我是芝士AI吃鱼,原创 NLP、LLM、超长文知识分享
热爱分享前沿技术知识,寻找志同道合小伙伴
公众号 :芝士AI吃鱼

一、引言
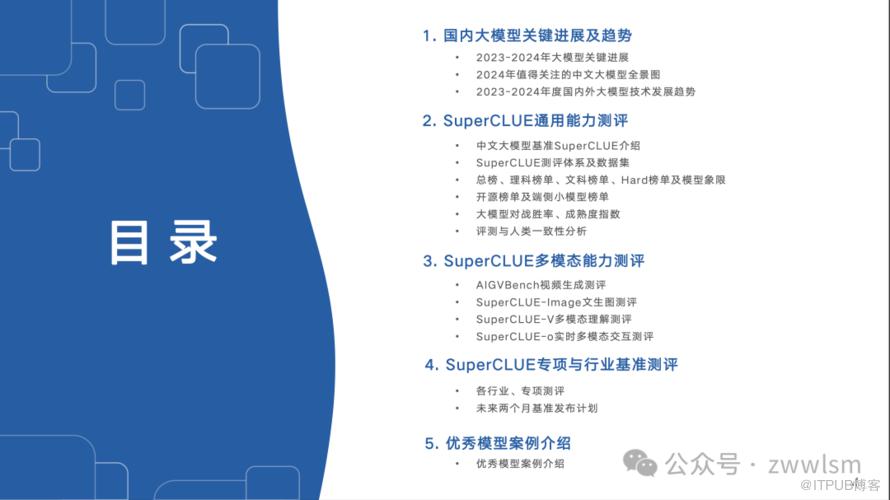
随着人工智能技术的快速发展,大语言模型(LLM)已成为AI领域的焦点。为了客观评估中文大模型的发展现状,SuperCLUE团队于2024年8月发布了最新的中文大模型基准评测报告。本分析旨在深入解读该报告,探讨中文大模型的技术进展、能力差异及未来发展趋势。
二、评测概况
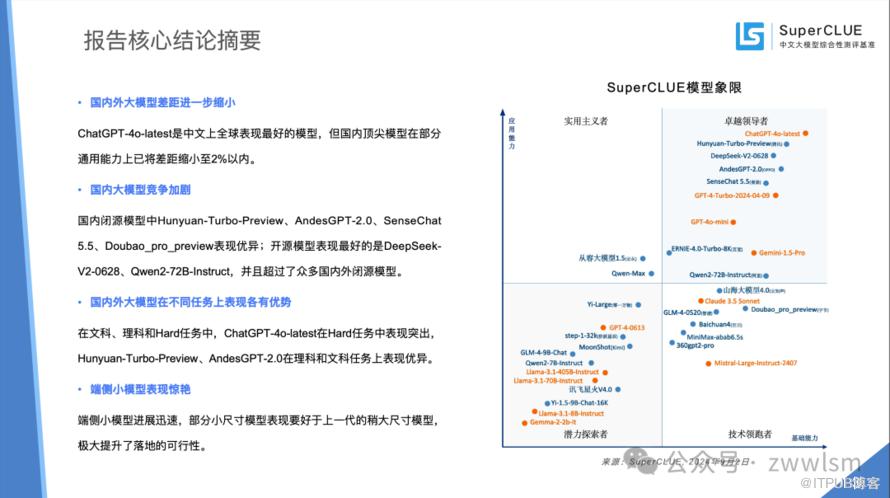
评测范围 本次评测涵盖了43个国内外具有代表性的大模型,包括闭源和开源模型。参评模型包括国际知名的ChatGPT-4o-latest、GPT-4-Turbo等,以及国内的Hunyuan-Turbo-Preview(腾讯)、AndesGPT-2.0(OPPO)、DeepSeek-V2-0628等。
评测方法 评测基于SuperCLUE通用能力测评基准,采用多轮简答题形式,题目总量达3226道,均为原创新题。评测维度包括理科、文科和Hard三大类,细分为12个核心能力:
理科:计算、逻辑推理、代码 文科:知识百科、语言理解、长文本、角色扮演、生成创作、安全、工具使用 Hard:精确指令遵循、复杂任务高阶推理
评分标准 采用百分制评分,通过高级AI模型(如GPT-4o)根据预设标准进行评分,确保评测的客观性和一致性。
三、主要评测结果

总体排名
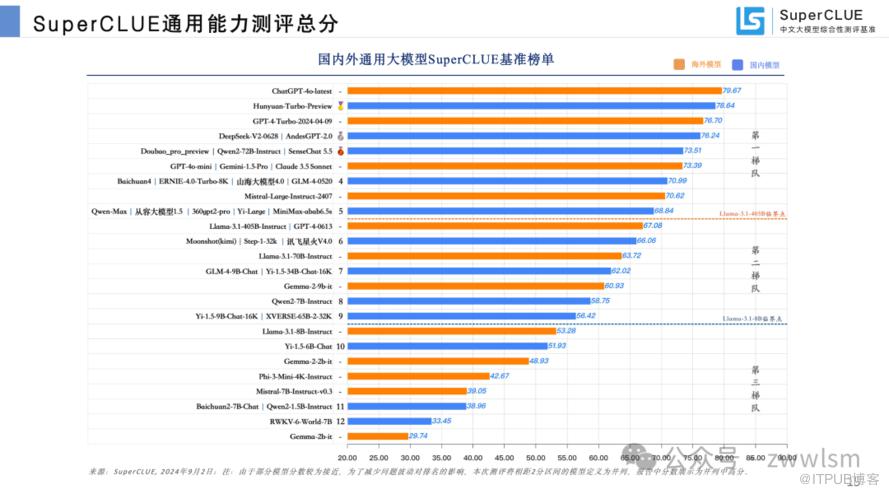
第一名:ChatGPT-4o-latest (79.67分) 第二名:Hunyuan-Turbo-Preview (78.64分) 第三名:AndesGPT-2.0 (76.24分)
分维度排名 (1) 理科榜单
并列第一:Hunyuan-Turbo-Preview和AndesGPT-2.0 (82.73分) 第三名:ChatGPT-4o-latest (81.50分)
(2) 文科榜单
并列第一:Hunyuan-Turbo-Preview等5个国内模型 (78.86分) 第二名:ChatGPT-4o-latest等国际模型 (78.62分)
(3) Hard榜单
第一名:ChatGPT-4o-latest (78.87分) 第二名:Hunyuan-Turbo-Preview (74.33分)
开源模型表现
第一名:DeepSeek-V2-0628 (74.63分) 第二名:Qwen2-72B-Instruct (73.51分)
小型模型(10B级别)表现
第一名:GLM-4-9B-Chat (61.15分) 第二名:Gemma-2-9b-it (60.93分)

四、关键发现与趋势分析
国内外差距显著缩小 从2023年5月至2024年8月,国内外顶级模型在中文领域的通用能力差距从30.12%急剧缩小至1.29%。这一数据凸显了中国大模型技术的快速进步,已接近国际领先水平。
能力分层明显 根据SuperCLUE成熟度指数,大模型的各项能力呈现明显分层:
高成熟度(SC指数>0.9):语言理解、知识百科、生成创作 中成熟度(SC指数0.8-0.9):工具使用、角色扮演、传统安全、逻辑推理 低成熟度(SC指数0.7-0.8):计算、代码、长文本、高阶推理 极低成熟度(SC指数<0.7):精确指令遵循
这一分层反映了当前大模型在不同任务上的发展不均衡,为未来的优化方向提供了指引。
小型模型的崛起 10B级别及以下的小型模型展现出强劲的性价比。例如,GLM-4-9B-Chat在10B级别模型中表现最佳,得分61.15,接近或超过了部分大型闭源模型。这一趋势预示着未来小型模型在特定应用场景中可能会发挥更大作用。
多模态能力提升 在多模态测评中,国内模型如hunyuan-vision、Dreamina即梦等在某些任务上已接近或超过国际模型如GPT-4o。这表明中国在多模态AI领域也取得了显著进展。
开源模型的竞争力 DeepSeek-V2-0628和Qwen2-72B-Instruct等开源模型的表现优异,超越了多个国内外闭源模型。这一趋势可能会推动AI技术的更广泛应用和创新。
五、行业应用前景分析
汽车行业 多个中文大模型在汽车行业测评中表现优异,有4个模型超过GPT-3.5。这表明中文大模型在特定垂直领域已具备较强竞争力。
金融行业 国内外头部模型在金融领域的差距较小,部分国内模型在某些任务上甚至超过GPT-4。这预示着中文大模型在金融科技领域的应用前景广阔。
工业领域 国内模型在工业领域展现出较强竞争力,如奇智孔明AInno-15B与GPT-4总分差距仅1.4分。这一结果反映了中国在工业智能化方面的潜力。
智能座舱 在汽车智能座舱测评中,国内模型如qwen_max_longcontext表现优异,与GPT-4o的差距不大。这为未来智能汽车的发展提供了有力支持。
六、挑战与发展方向

Hard任务能力提升 虽然国内模型在多个领域已接近或超越国际水平,但在Hard任务(如精确指令遵循、复杂任务高阶推理)上仍有提升空间。未来应着重提高模型在这些高难度任务上的表现。
垂直领域深化 评测结果显示,针对特定行业优化的模型往往表现更佳。未来可能会出现更多针对垂直领域的专门化大模型。
小型模型优化 考虑到小型模型的良好性价比,未来可能会更多地关注如何在有限的参数规模内最大化模型性能。
多模态融合 随着多模态AI的发展,未来的大模型可能会更加注重文本、图像、视频等多种模态的融合理解和生成能力。
伦理与安全 随着大模型能力的提升,如何确保模型输出的安全性和符合伦理标准将成为重要课题。
七、结论
2024年8月的中文大模型基准评测报告展现了中国AI技术的快速进步。国内顶级模型在多个领域已接近或超越国际水平,特别是在垂直行业应用方面表现突出。同时,小型模型和开源模型的崛起为AI技术的普及和创新提供了新的可能性。
然而,评测也揭示了当前大模型发展的不均衡性,特别是在高难度任务和某些特定能力上仍有提升空间。未来的发展方向可能包括进一步提升Hard任务能力、深化垂直领域应用、优化小型模型性能,以及加强多模态融合能力。
数据来源:SuperCLUE,回复报告,获取 PDF 原文
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

