发布于 2026 年 10 月 12 日
作者:Ke Yang,博士生;Chenglong Wang,高级研究员;Michel Galley,高级首席研究经理;Chandan Singh,高级研究员;Jeevana Priya Inala,高级研究员;ChengXiang Zhai,伊利诺伊大学计算机科学系教授;Jianfeng Gao,技术院士兼企业副总裁
概览
StudentSim 是一个研究系统,用于在 AI 导师与真实学习者测试之前对其进行评估和改进;它不是产品,未部署于课堂,也不旨在取代教师
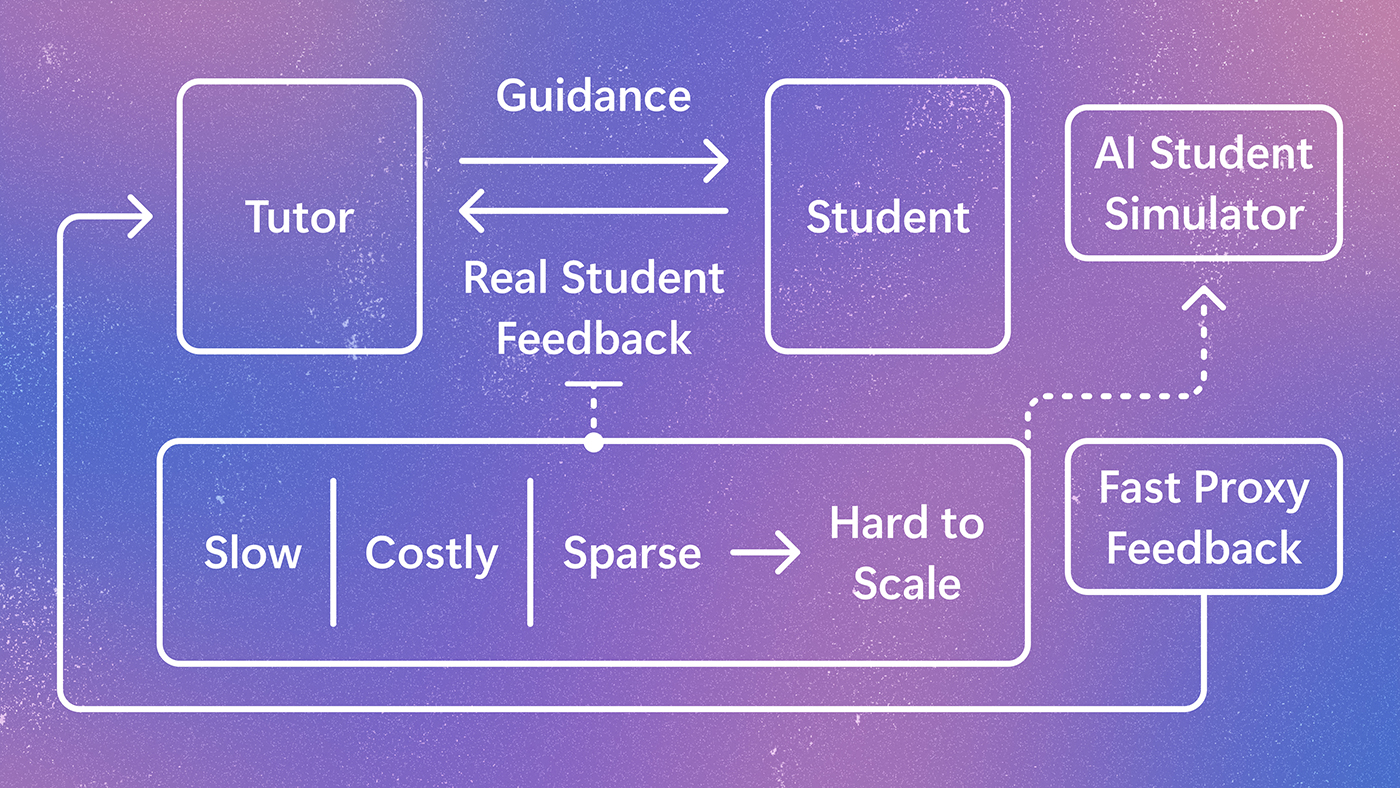
AI 辅导工具需要学生的反馈才能改进,但通过人类研究收集反馈速度慢、成本高且难以规模化
StudentSim 从公开可用的去标识化学习者记录中训练个性化的 AI 学生模拟器,为每个学生适配一个模拟器
该工作从两个基于教育学的维度评估模拟器:它们是否像特定学生那样作答,以及它们在导师指导后是否会更新
在国际象棋、第二语言英语写作和数学领域,StudentSim 优于领先的基线方法,并为训练 AI 导师提供了有用的反馈信号
在研究环境中,团队正在探索 AI 驱动的辅导系统如何帮助解释一道数学题、为写作作业提出修改建议,或引导学习者理解一个国际象棋局面。然而,教学质量不能仅从导师的回答来衡量。导师需要知道指导到达学生之后发生了什么。学生是否纠正了最初的错误?提示是帮助他们推理出答案,还是透露了太多?不同的学生是否需要不同类型的支持?在当今的 AI 导师研究中,回答这些问题通常需要真实的学习者研究。这些研究很有价值,但运行起来缓慢且成本高昂,这使得在快速模型迭代期间难以利用学生反馈。
StudentSim 是一个 AI 系统,它创建个体学生的个性化模拟器,建模他们如何回答问题以及他们的答案在收到导师指导后如何变化。目标是让 AI 导师开发过程中更容易获得学生反馈。这项研究还引入了 StudentSimEval,一个涵盖国际象棋、第二语言英语写作和数学的基准与评估协议。
重要的是,目标不是取代教师或课堂学习。相反,StudentSim 帮助研究人员在研发过程中、在真实学习者测试之前评估和改进 AI 辅导系统。该研究仅使用为研究用途发布的、包含去标识化记录的公开学习者数据集;在任何阶段都不使用个人身份信息。

衡量学生模拟器需要做什么
构建学生模拟器的一种简单方法是让大型语言模型扮演学习者。例如,提示词可能会说:“你是一名数学有困难的小学生。”模型可以改变语气并表达不确定性。更难的部分是保持学习者真实的能力边界。模型可能用年幼学生的口吻说话,但仍然依赖远超该学生水平的知识和推理。对于训练 AI 导师而言,这会产生误导性反馈:导师可能看起来有效,因为模拟学生能力过强。
传统的学生建模方法面临不同的局限。知识追踪和行为预测模型基于真实学习记录,可以估计学生当前的知识、技能和学习习惯。然而,许多此类模型并非设计用于将自然语言导师指导作为输入。它们可以帮助描述学生做了什么,但并不总能告诉我们学生将如何回应特定的解释、提示或苏格拉底式提问。
StudentSim 通过受教育研究启发的两个维度来定义目标。教育者通常区分学习者在独立情况下能做什么与在支持下能做什么。维果茨基的最近发展区捕捉了当前独立表现与有指导表现之间的差距。StudentSim 将这一理念转化为两个评估目标。行为保真度衡量模拟器在留出问题上是否匹配特定学生的记录回答。指导响应性衡量模拟器在阅读导师指导后是否更新其回答。

这两个目标相辅相成。仅匹配过去学生行为的模拟器可能对预测有用,但它不能显示教学干预是否有效。总是遵循导师的模拟器可能回答流畅,但可能无法代表特定学生的优势、劣势和可能的错误。AI 导师训练需要两种信号:学习者的起点以及指导如何影响学习者的表现。
从稀疏的学生记录中训练个性化模拟器
StudentSimEval 完全基于公开可用的学习者数据集构建,这些数据集以去标识化记录的形式发布供研究使用。这些记录不包含任何个人身份信息,每个个性化模拟器仅在其所代表的学生的去标识化记录上进行训练。
真实的学生数据在个体层面往往很稀疏。一个学习者可能只贡献少量作文、答案或交互。为每个学生从零开始训练单独的模拟器会面临过拟合的风险,并且要求每个模型重新学习该领域的常见模式。
StudentSim 采用两阶段训练流程。在第一阶段,模型在同一领域内许多学生的汇总记录上进行训练。这一阶段学习常见的回答格式、常见错误以及学生在接受指导后进行修改的常见方式。在第二阶段,模型针对某一个学生自己的记录进行专门化训练,从而为该学生生成个性化模拟器。

评估涵盖三个具有不同回答类型的领域。在国际象棋中,模拟器预测玩家的下一步棋以及该玩家在教练指导后可能如何修改。在第二语言英语写作中,它生成与学习者错误模式匹配的作文,并预测教师在给出反馈后的修正。在数学中,它预测学生的多项选择题答案以及学生在解释后是否会更新答案。在这些领域中,StudentSimEval 使用相同的原则:在相同的每个学生训练记录和相同的留出评估记录上比较所有方法。
StudentSim 在三个领域均优于领先的基线方法。例如,在国际象棋中,StudentSim 达到 0.5150 的行为保真度和 0.9067 的指导响应度。GPT-5.4 分别达到 0.2316 和 0.7186。Maia2 是一个专门用于国际象棋的人类走子预测模型,达到 0.4535 和 0.2721。这一比较说明了基线方法族之间的差异:GPT-5.4 能够响应指导,但不能可靠地匹配特定学生的行为,而 Maia2 能更接近地预测人类国际象棋走子,但缺乏自然语言指导路径。

使用模拟反馈改进 AI 导师
该研究还测试了训练好的学生模拟器是否能为导师优化提供反馈。在一项国际象棋导师强化学习研究中,导师接收一个局面和真实学生之前的错误走子,然后生成指导。在此过程中,学生模拟器自身的参数保持固定,它读取指导并生成修改后的走子。奖励基于从学生之前走子到模拟器修改后走子的走子质量提升,使用 Stockfish 作为独立的国际象棋引擎信号。

该研究比较了三种条件:未进行强化学习的监督微调导师、以 GPT-5.4 作为模拟学生奖励来源训练的导师,以及以 StudentSim 作为奖励来源训练的导师。所有条件使用相同的导师策略、监督起点和强化学习设置。随后,国际象棋人类专家在不知道条件的情况下评估导师的回应。
StudentSim 奖励在所有报告的维度上产生了评分最高的导师。使用 StudentSim 训练的导师达到 90.5% 的准确率,相比之下,无强化学习基线为 75.7%,GPT-5.4 奖励条件为 71.6%。它在指导质量和个性化方面也获得了更高的评分。这一结果是一个概念验证,表明基于真实学习者数据训练的学生模拟器可以为改进 AI 导师提供有用的反馈。
展望未来
StudentSim 并未消除教育研究中真实学习者的必要性。人类研究对于衡量学习成果、安全性、可用性和课堂适用性仍然至关重要。学生模拟器的作用在于开发过程的更早阶段:它们可以帮助研究人员测试导师策略、比较模型,并在进入更昂贵的真实学生研究之前优化训练信号。
更广泛的方向是构建能够从学生反应中学习的 AI 导师系统,而不仅仅是从专家编写的解释或静态的正确性标签中学习。StudentSim 展示了一条路径:使用真实学习记录来训练个性化模拟器,在独立行为和响应指导两方面评估这些模拟器,并将它们用作导师训练的可扩展反馈来源。未来的工作可以将这种方法扩展到更长的学习轨迹、更多科目、更丰富的学生画像,以及将模拟反馈与真实学习成果联系起来的研究。
该论文以及 StudentSim 训练和评估代码(包括 StudentSimEval 协议)均已公开可用。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://www.microsoft.com/en-us/research/blog/simulating-student-learning-for-better-ai-tutoring/
原文作者:alyssa;如有侵权,请联系管理员删除。

