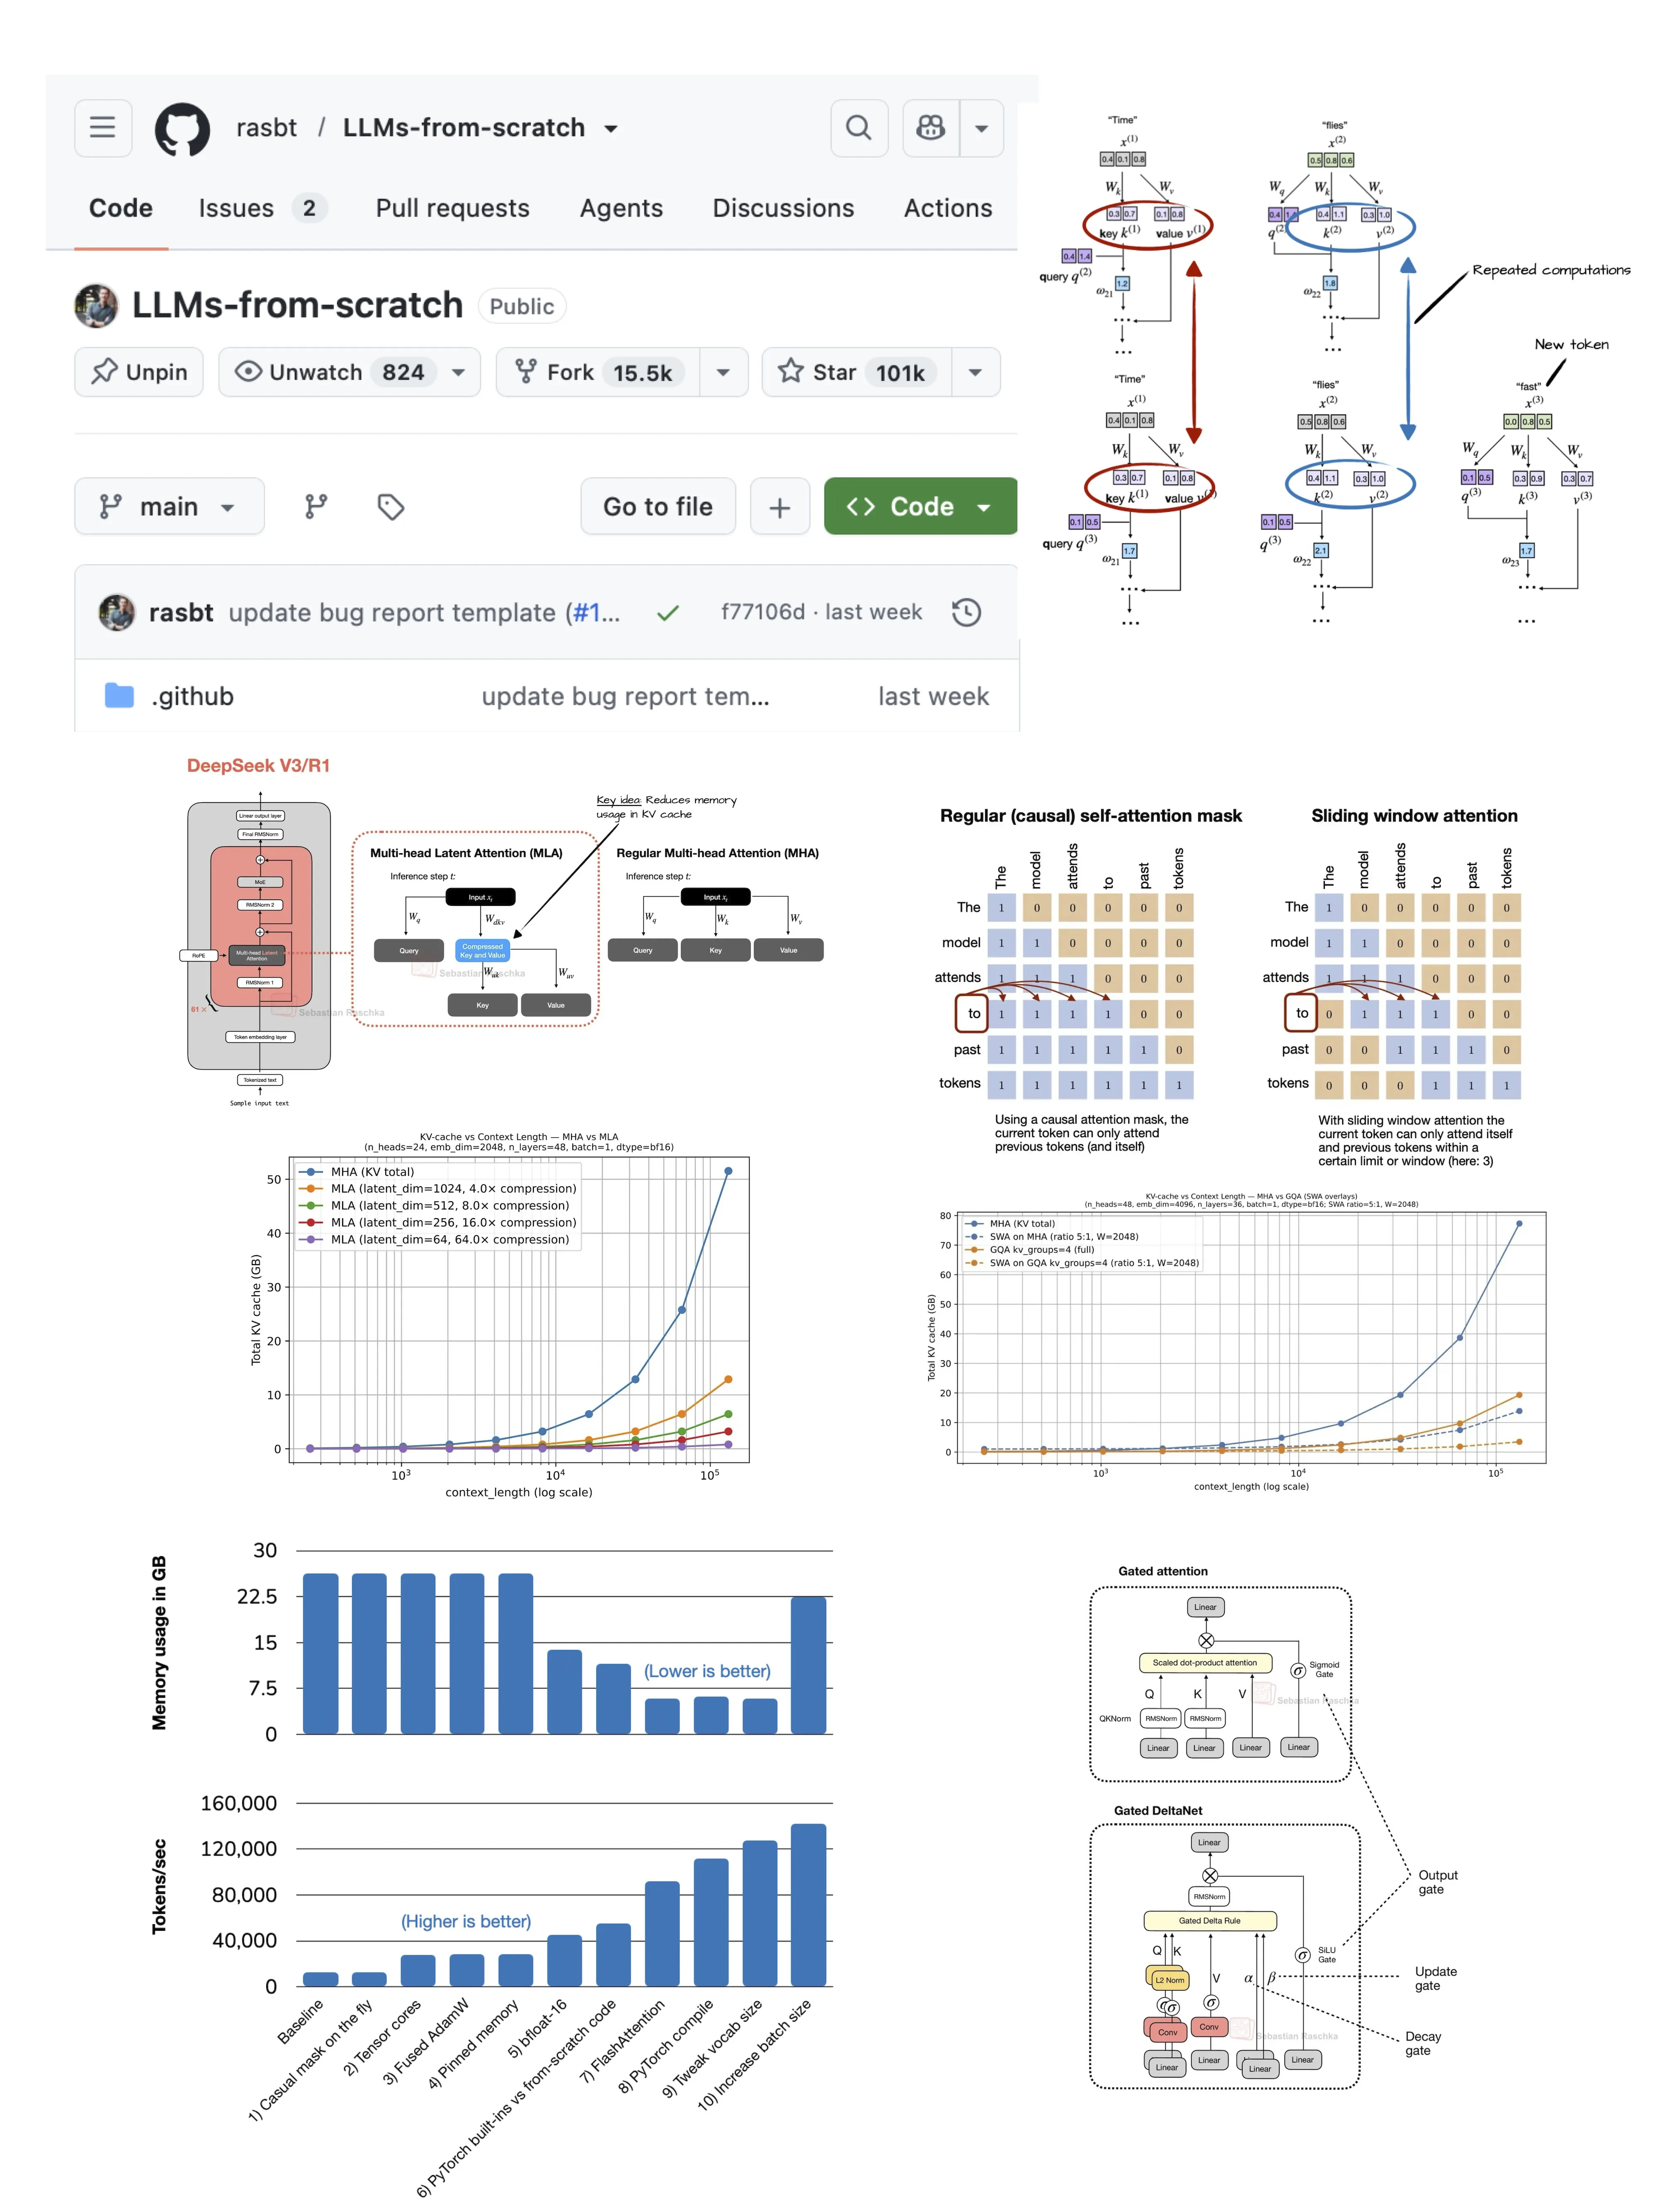
刚看到 LLMs-from-scratch 仓库在 GitHub 上的 star 数突破了 100,000!
这太酷了,也很鼓舞人心。看到这个开源仓库帮助了这么多人,我真的很开心。
也感谢所有分享想法并提交改进 PR 的人!
当然,我计划继续添加新内容,包括新的注意力变体和架构(而像 RL 和 Reasoning From Scratch 这样更大的项目则放在各自独立的仓库中)。
我目前还在进行一个更大的应用型自定义“小型”LLM(大语言模型) 项目。这个月它让我忙得不可开交,但我很快会在一篇即将发布的 Substack 大型文章中分享更多内容!这是我迄今为止最长的一篇!
如果你是新手,仓库中的一些亮点包括
当然,从分词和注意力到预训练、分类和指令微调等的完整代码路径。当然,所有内容都是 FROM SCRATCH!(RL 位于配套仓库中。)
Llama、Qwen、Gemma 和 Olmo 的从零实现(可在本地运行的较小变体,并可接入训练脚本)。
注意力替代方案和其他架构组件的从零实现,例如 GQA、MLA、滑动窗口注意力、Gated DeltaNet、DeepSeek Sparse Attention、跨层 KV 共享和混合专家。
关于 KV 缓存、训练性能、内存高效权重加载、DPO、评估和 LoRA 的材料
所以,如果你周末还没有什么安排,祝你玩得开心!
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/blog/2026/llms-from-scratch-reaches-100000-github-stars.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

