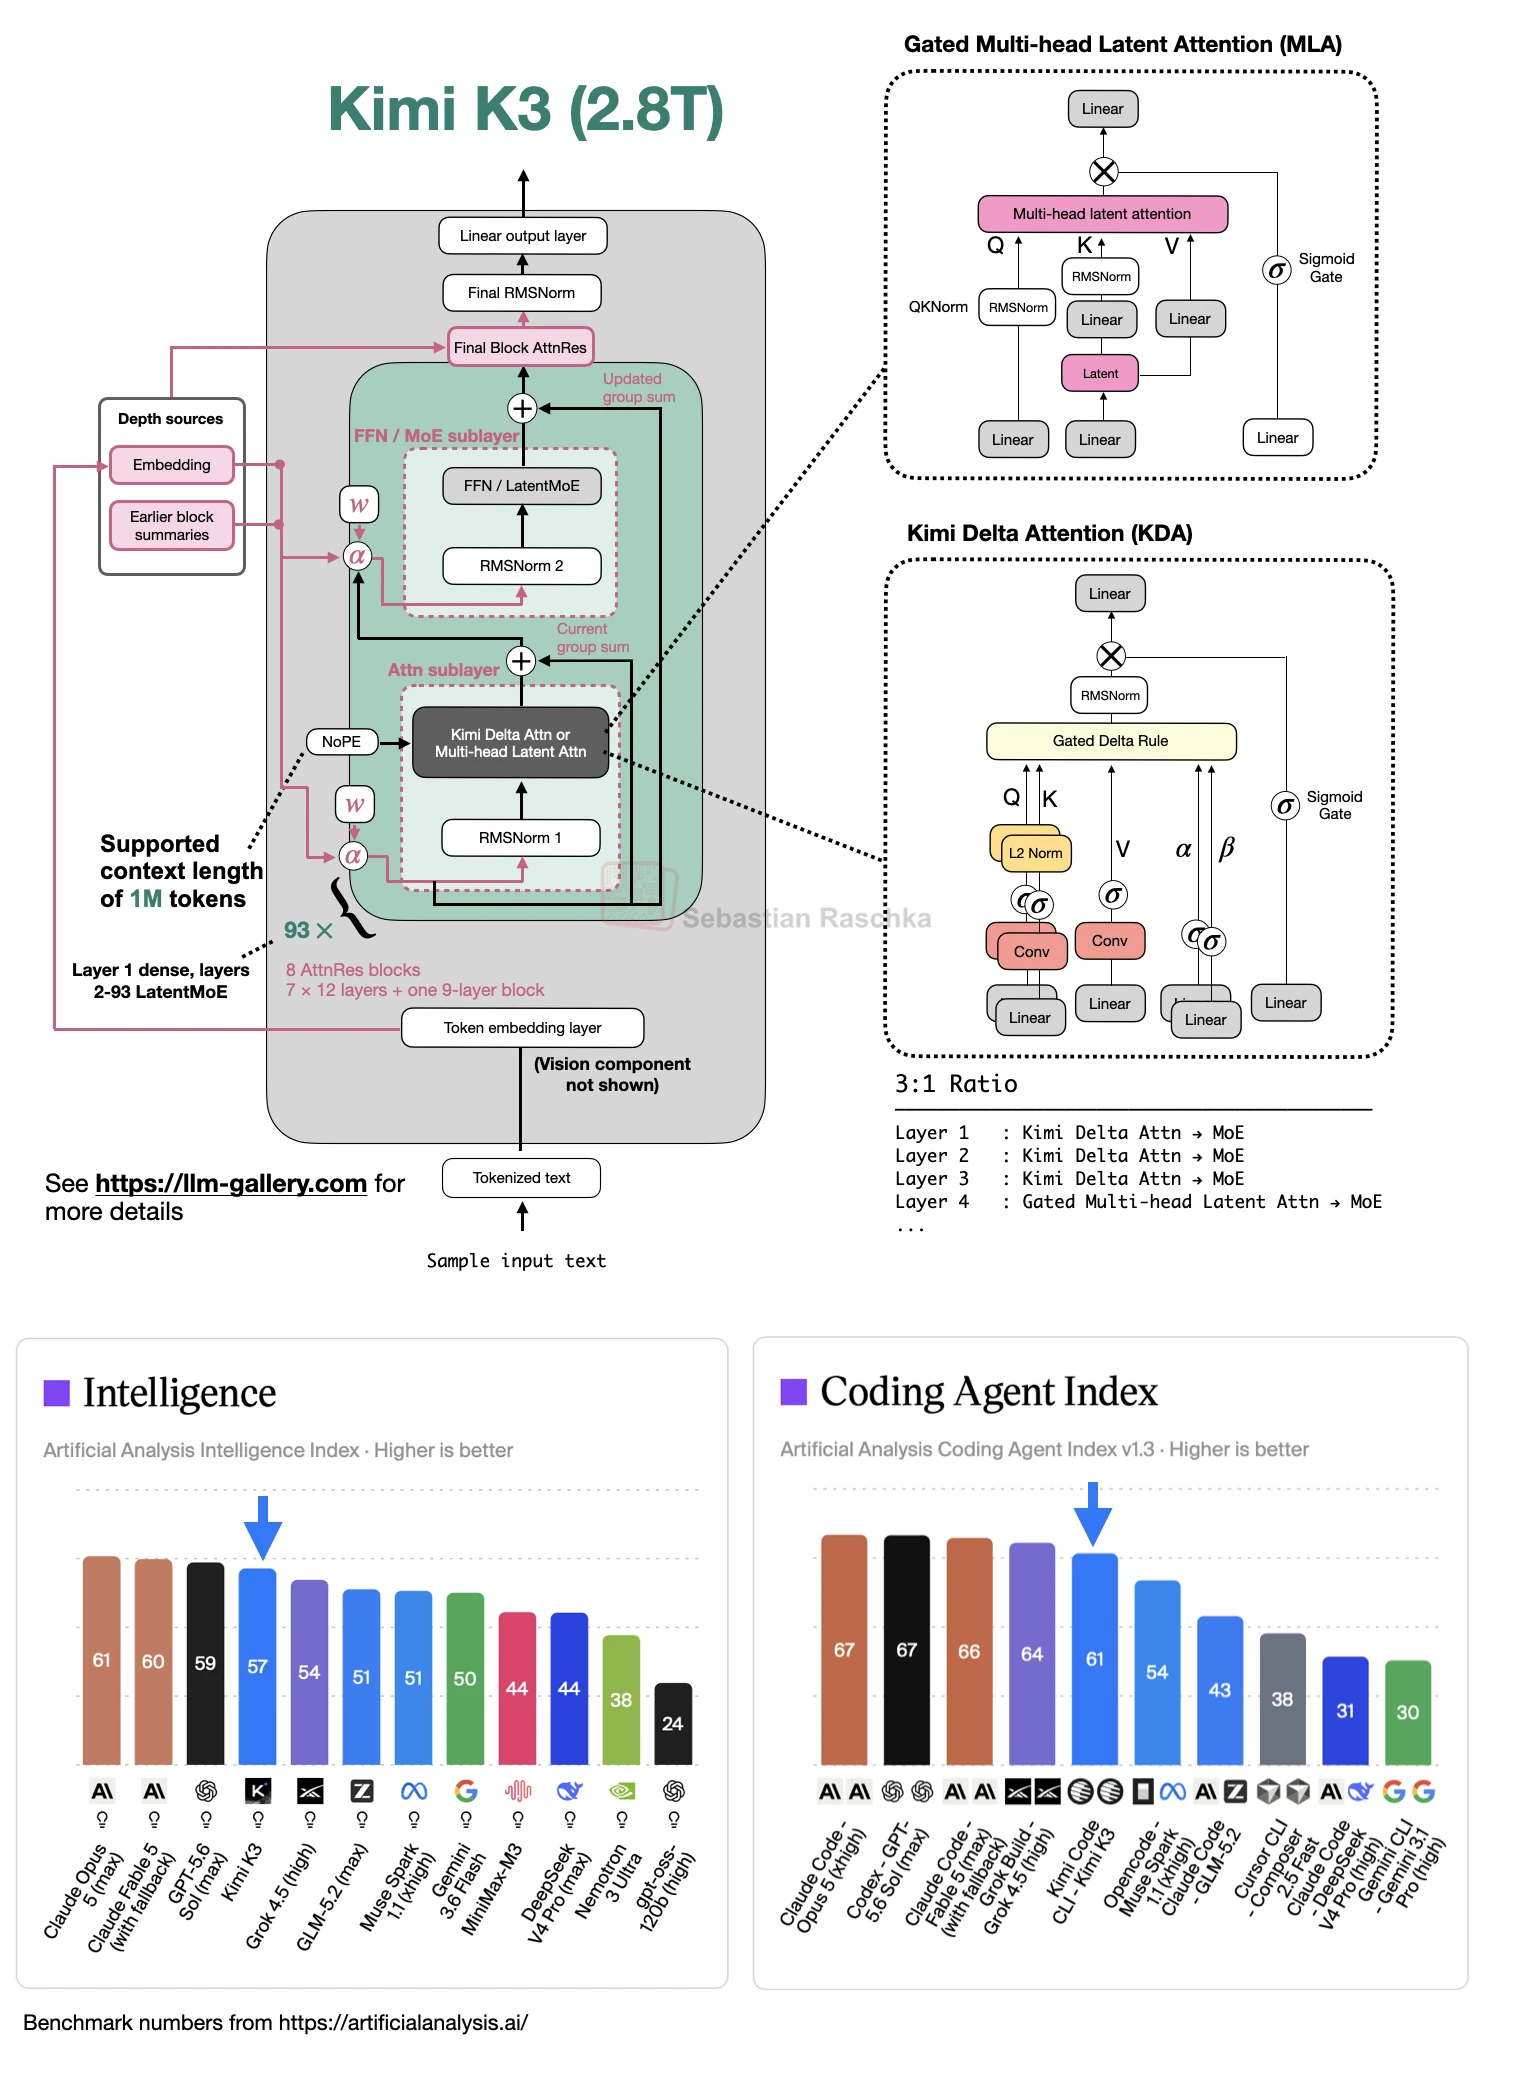
昨天发布的大型开放权重模型 Kimi K3 的架构图,以及一些观察和思考。
是的,它看起来相对复杂,但本质上只是他们去年发布的 Kimi Linear 模型放大后的生产版本(从 48B 扩展到 2.8T;K3 是目前为止最大的开放权重模型)
与 Kimi Linear 相比,唯一新增的组件是 LatentMoE。我在下图中省略了它,因为图已经很拥挤了,但它本质上与 Nemotron 3 Ultra 中的 LatentMoE 相同(如果你好奇,可以在我的 LLM(大语言模型) Architecture Gallery 中找到它)。其思路是像多头潜在注意力那样,对大型线性层进行压缩(降维投影)。
Kimi K3 的整体趋势(与 Nemotron 3、DeepSeek V4 等类似)也是朝着更好的推理效率发展。也就是说,有许多组件用效率优化版本替换了现有组件。即,MoE -> LatentMoE,常规注意力 -> 多头潜在注意力和 Kimi Delta Attention。(如果你对更多细节感兴趣,我的 gallery 中也有简短的教程和文章)。
唯一一个不是效率优化的组件变更是注意力残差。就像 DeepSeek V4 用 mHC(流形约束超连接)改进了残差路径一样,注意力残差也是一种改进残差路径的方式,但工作方式略有不同。即,mHC 使残差路径更宽。注意力残差(也已经是 Kimi Linear 的一部分)跨层连接残差;连接本身使用注意力分数作为重要性/贡献权重。根据报告,它持续改善验证损失和下游性能(略微),并增加约 4% 的训练成本和 2% 的推理成本。
有趣的是,Kimi K3 去掉了所有 RoPE 层,改为在所有地方使用 NoPE(无位置嵌入)。(同样,这是继承自 Kimi Linear)。在其他架构中,最近的趋势是在局部注意力层(如滑动窗口注意力)中使用 RoPE,在全局层中使用 NoPE。也有少数架构只在所有地方使用 NoPE,但据我所知,这是第一个前沿级别的。
Kimi K3 现在还具备原生多模态支持,这很棒!
技术报告中还有其他一些有趣的训练细节,但就架构方面而言,目前就是这些。总体而言,这是一次非常出色的发布。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/blog/2026/kimi-k3-architecture-notes.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

