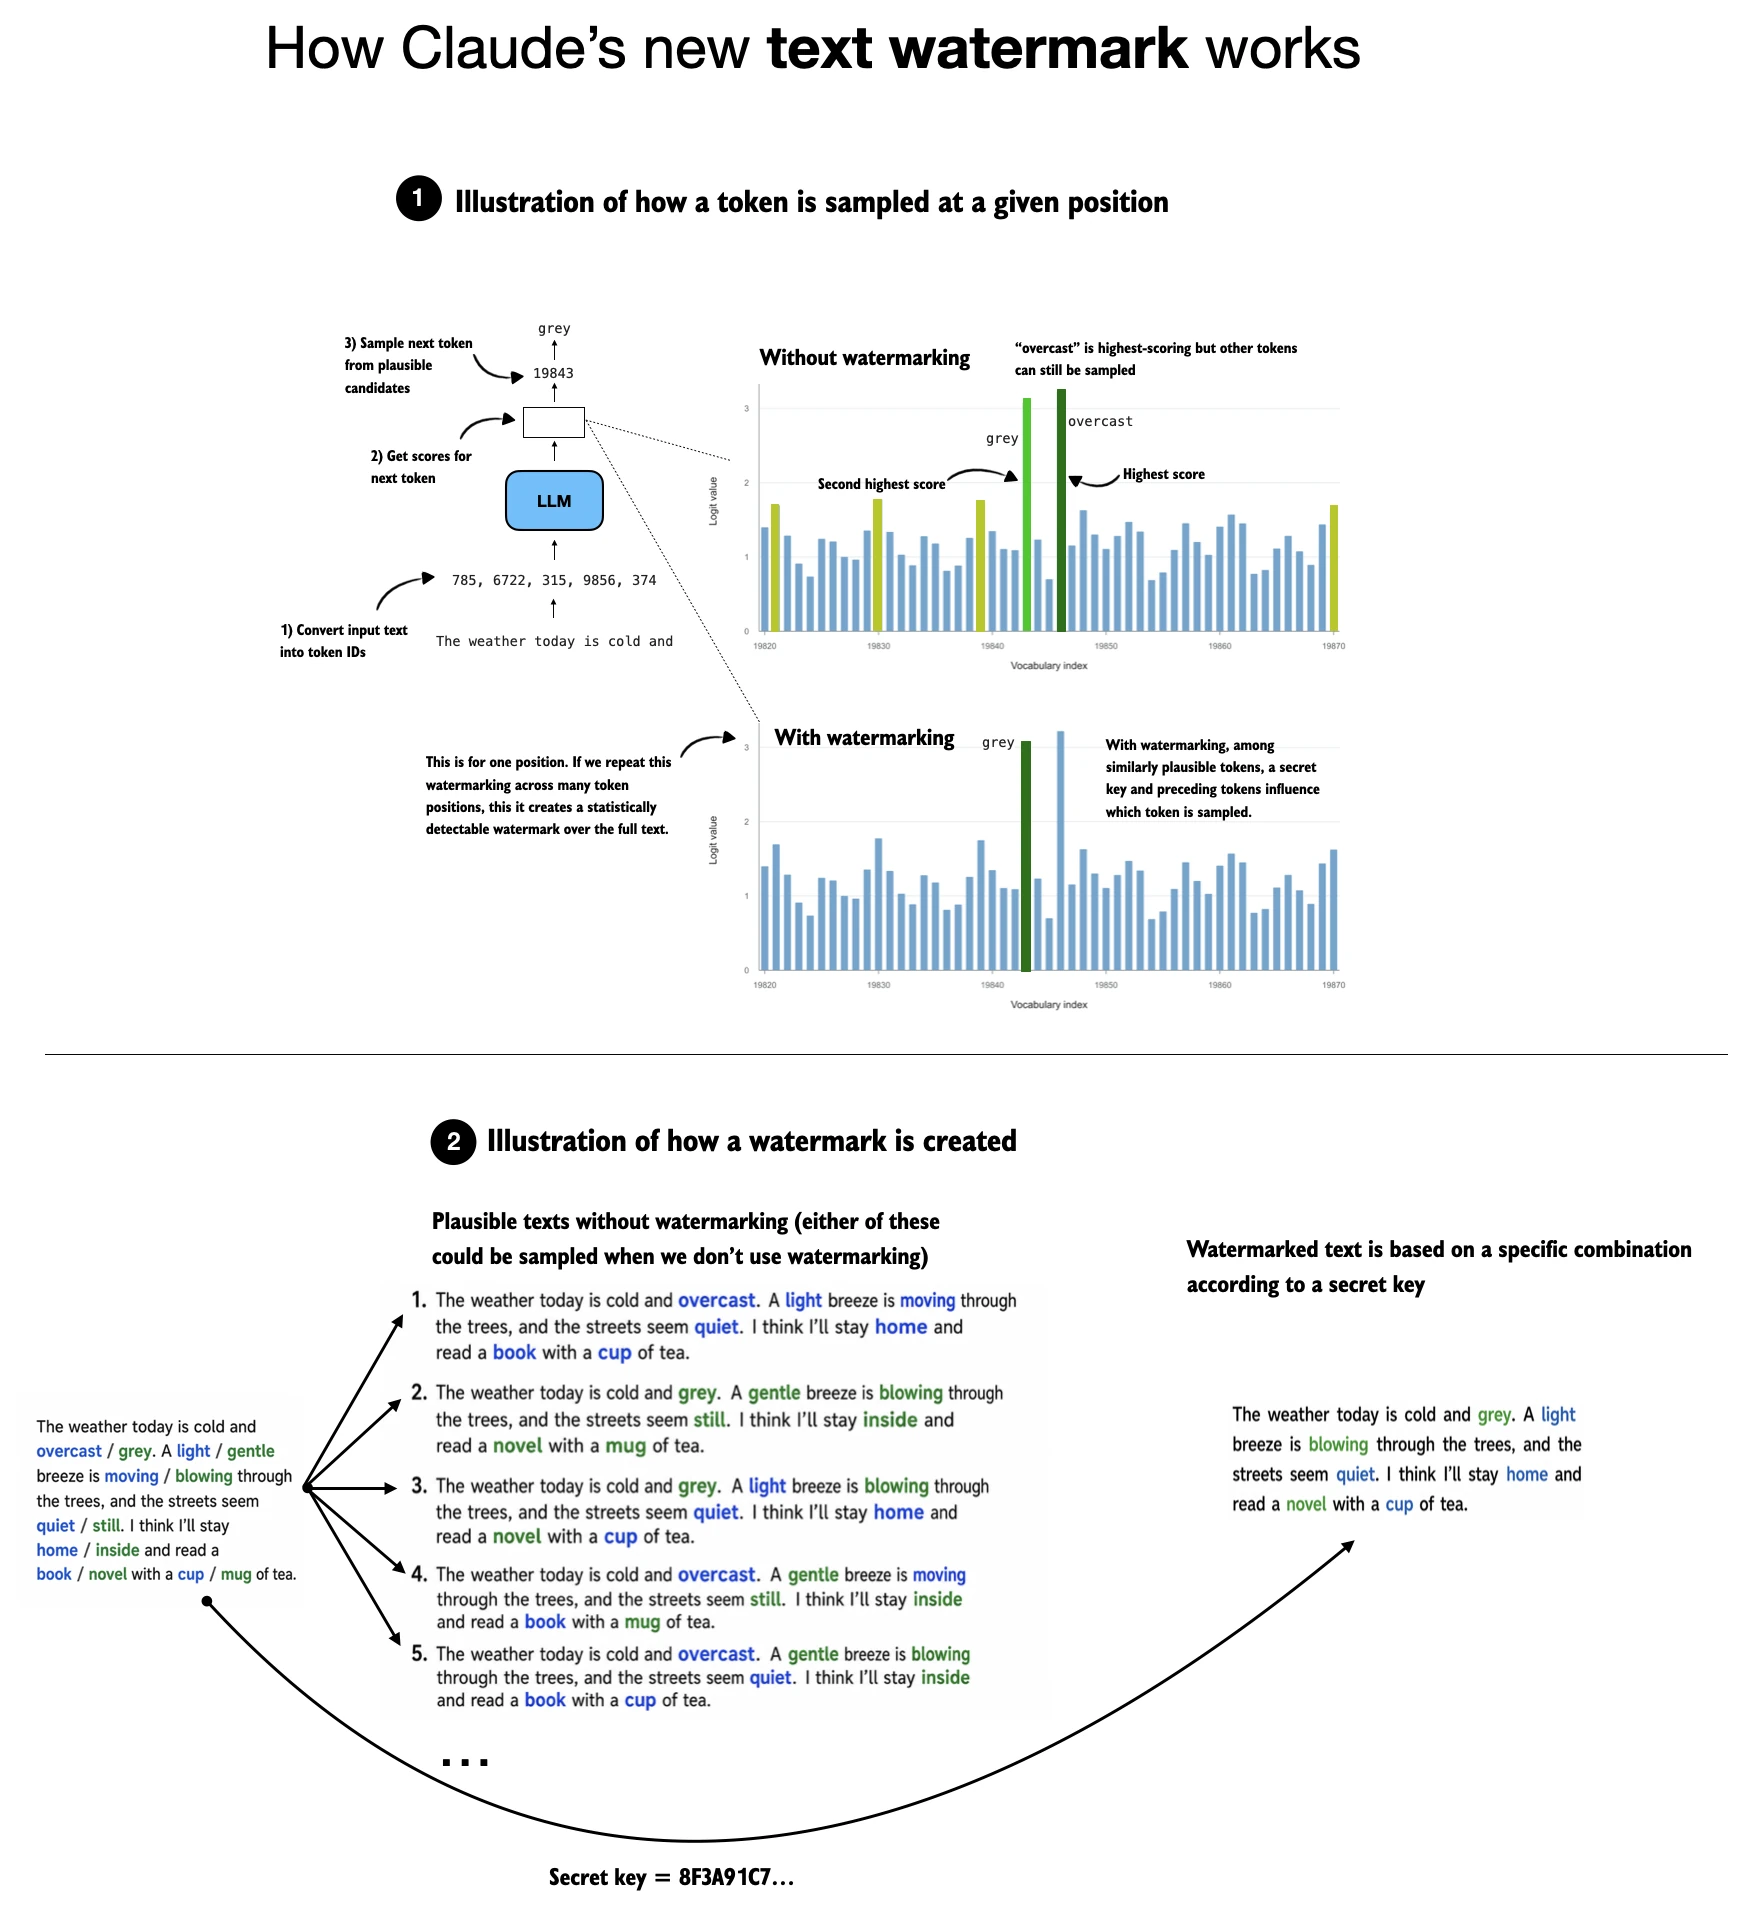
一个简短示例,说明 Claude 的水印机制按理应如何工作(基于我对他们已发布材料的解读)。
一般来说,当我们生成 token 时,在某些下一个词的位置上可能存在多个高分 token。通常,我们会使用 top-k 或 top-p 采样,因此得分最高的 token 最常被选中(如果我们多次重复采样),但其他 token 也可能被选中。
使用水印时,有一个密钥会影响在最高分 token 中选择哪一个。(水印密钥 + 最近的 token 上下文 → 伪随机种子 → 候选 token 的伪随机分数 → 采样过程偏向分数有利的候选。)
或者更具体地说,秘密密钥和(一个窗口内的)先前 token 会影响这里的随机性。现在,如果我们在许多 token 位置重复这一点,就会形成水印,因为它会形成一种模式(统计相关性),而由于组合数学的原因,否则在统计上不太可能出现这种模式。
当然,这种水印可以通过另一个非水印 LLM(大语言模型) 进行中度到重度编辑和改写来移除。但这可能会使文本变差,因为这需要对文本进行多处修改并替换词语(由于我们不知道哪些位置带有水印,一个好的去水印工具将不得不编辑许多位置)。
有一件事让我困惑:他们基本上说,由于欧盟法规,他们必须对所有人都这样做。为什么?当然,但这是推理时技术,不需要重新训练或训练单独模型,所以如果他们愿意,难道不能只对欧盟用户这样做吗?
有人向我指出:
回答你关于为什么这不只适用于欧盟用户的问题:Anthropic 是一家提供商,并且因为它在欧盟市场提供 Claude(第 2 条)且其输出可能基于欧盟,因此属于 EU AI Act 的适用范围。这意味着遵守透明度法规(第 50 条)的义务在于提供商。在生成时,Anthropic 无法知道输出最终会到哪里。遵守法律的唯一可靠方式是在生成过程中标记文本,并且是在全球范围内这样做,而不是按用户或地点进行分割。
我的反驳是:
不过总的来说,我觉得这项法规非常严格。例如,我在想这样一个场景:一家制药公司不能在美国制造并向患者提供某种药品,因为有人可能将其出口到尚未批准该药品的欧盟。也就是说,在这种情况下,难道不应该追究出口方的责任,而不是制造商的责任吗?
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/blog/2026/claude-text-watermarking.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

