现在真相大白:广受欢迎的 Ox Alpha 大语言模型(LLM(大语言模型))就是 GLM-5.3-Flash……
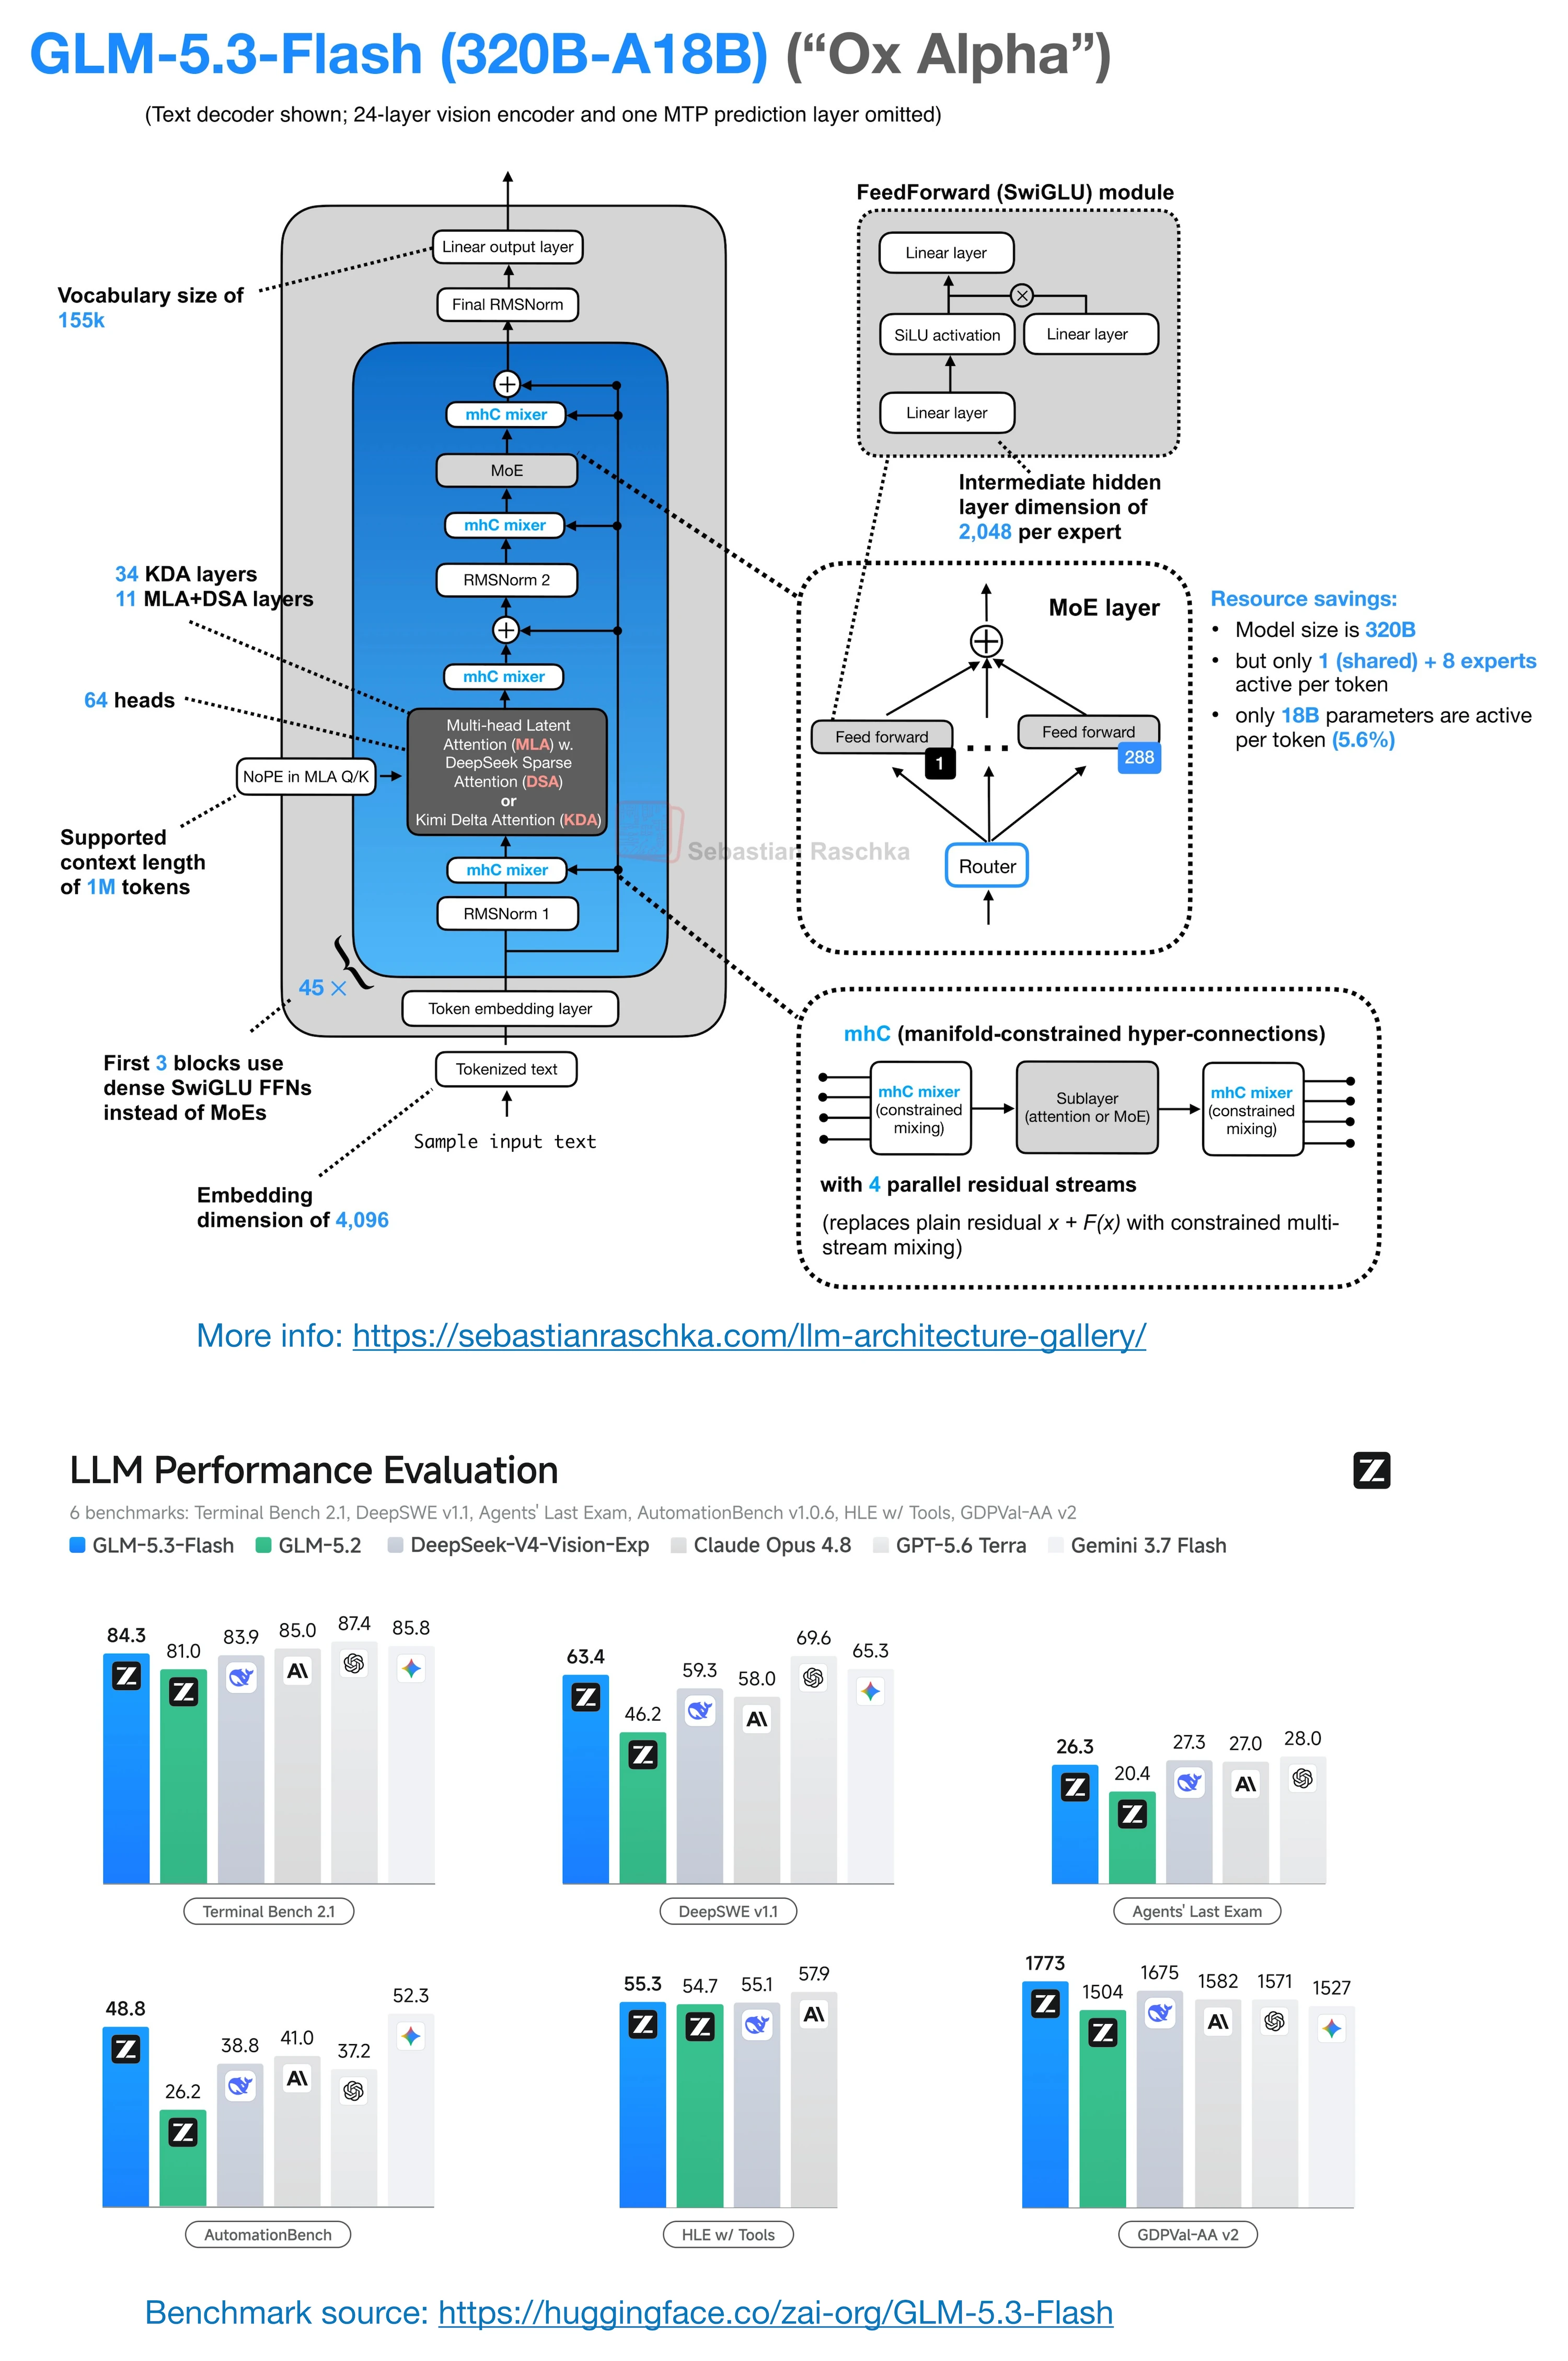
与 GLM-5.2 相比,这个新的 GLM-5.3-Flash 模型采用了:
一种 Kimi Linear 风格的 3:1(超级*)混合注意力模式,包含 34 层 Kimi Delta Attention(KDA)和 11 层 Multi-head Latent Attention(MLA)/ DeepSeek Sparse Attention(DSA)层;
一个按 GLM-5.2 风格缩小的稀疏 MoE 主干,从 744B-A40B 降至 320B-A18B;
一条 DeepSeek V4 风格的 mHC 残差路径,包含四条并行流;
外加一个原生视觉编码器(未展示)。
我之所以在上面称其为“超级混合”,是因为 KDA 和 MLA/DSA 都是“高效”组件。例如,Kimi 只使用 KDA + 全注意力 MLA,DeepSeek V3.2 使用 DSA + 全注意力 MLA。
附注:抱歉使用了过多技术术语。关于所有这些组件(MLA、DSA、KDA、mhC 等)的讲解都在我的 LLM Architecture Gallery 中。
再附注:哈哈,也许这就是买那台昂贵的 Mac Studio M5 Ultra 256 GB / 512 GB 来本地运行它的理由……
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/blog/2026/glm-5-3-flash-architecture-notes.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

