实战指南 | Kubernetes环境下DolphinScheduler与Spark集成
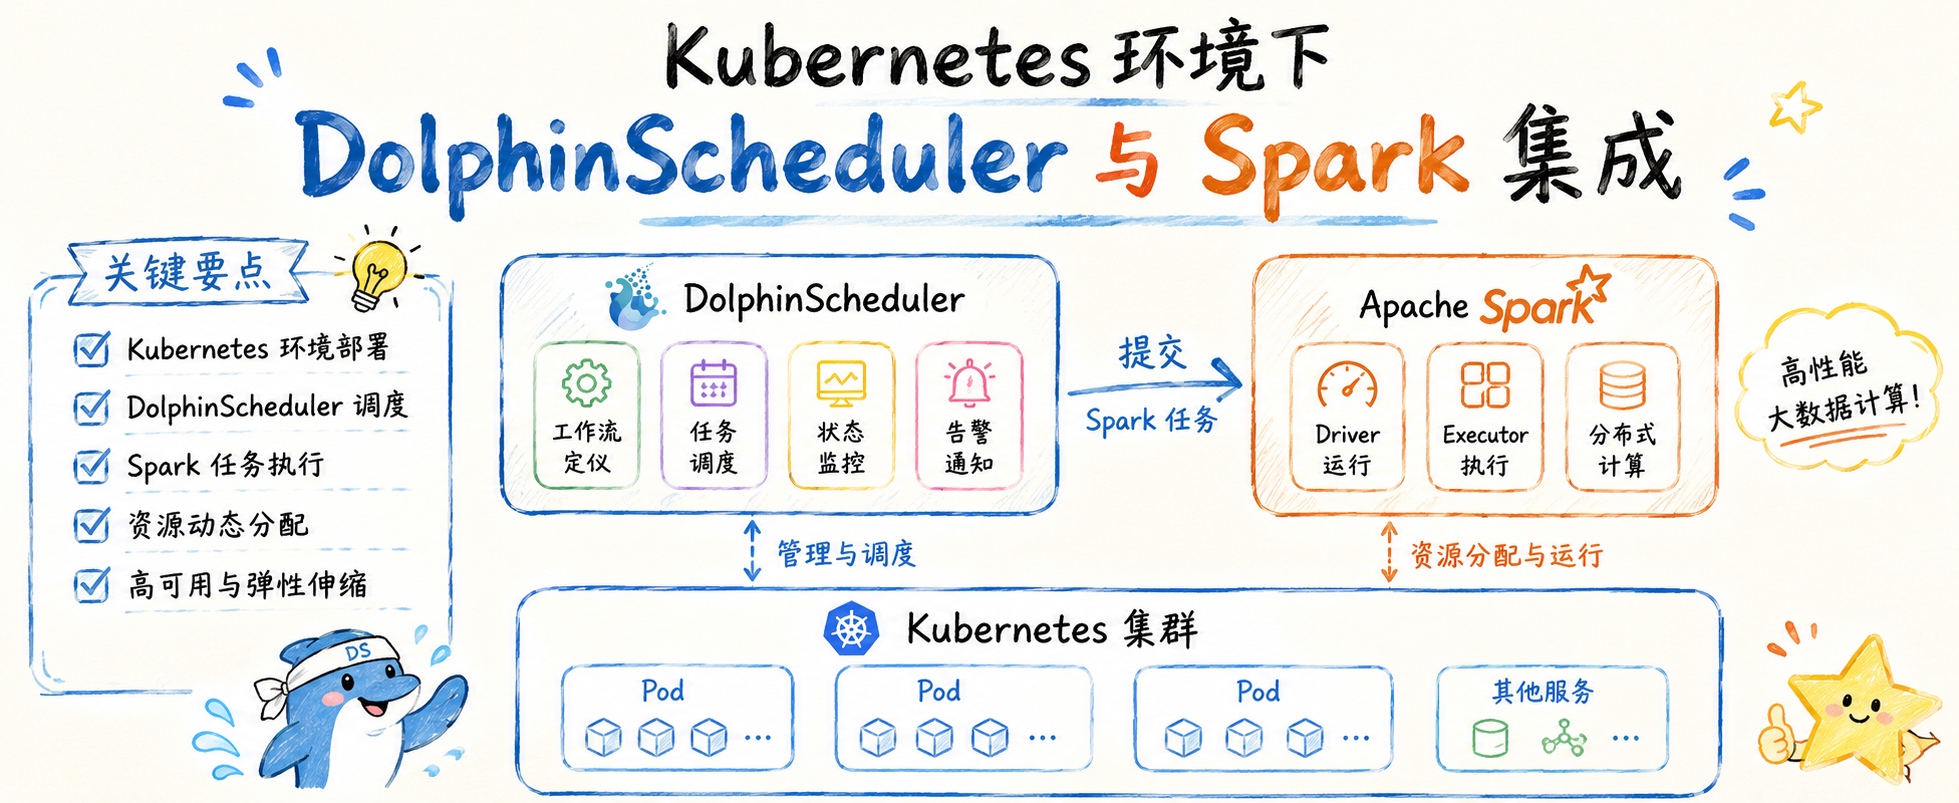
随着企业数据规模的快速增长,传统物理机或虚拟机部署Apache DolphinScheduler面临着环境配置复杂、资源利用率低、扩展性差等痛点。特别是在需要运行Spark等大数据计算任务时,手动维护多套环境、处理依赖冲突、应对突发流量等问题更是让运维团队疲于奔命。
Kubernetes云原生部署为这些问题提供了优雅的解决方案——通过容器化实现环境一致性,利用共享存储解决Spark等二进制文件的分发难题,配合自动扩缩容实现资源的弹性利用。
为此,本文将深入探讨在Kubernetes环境中部署Apache DolphinScheduler并集成Spark作业的完整实践,帮助你从零构建一个高可用、易扩展的云原生调度平台。
环境准备
前置要求
- Kubernetes集群(1.19+)
- kubectl命令行工具
- Helm 3.x
- 存储类支持ReadWriteMany访问模式(用于共享存储)
部署架构
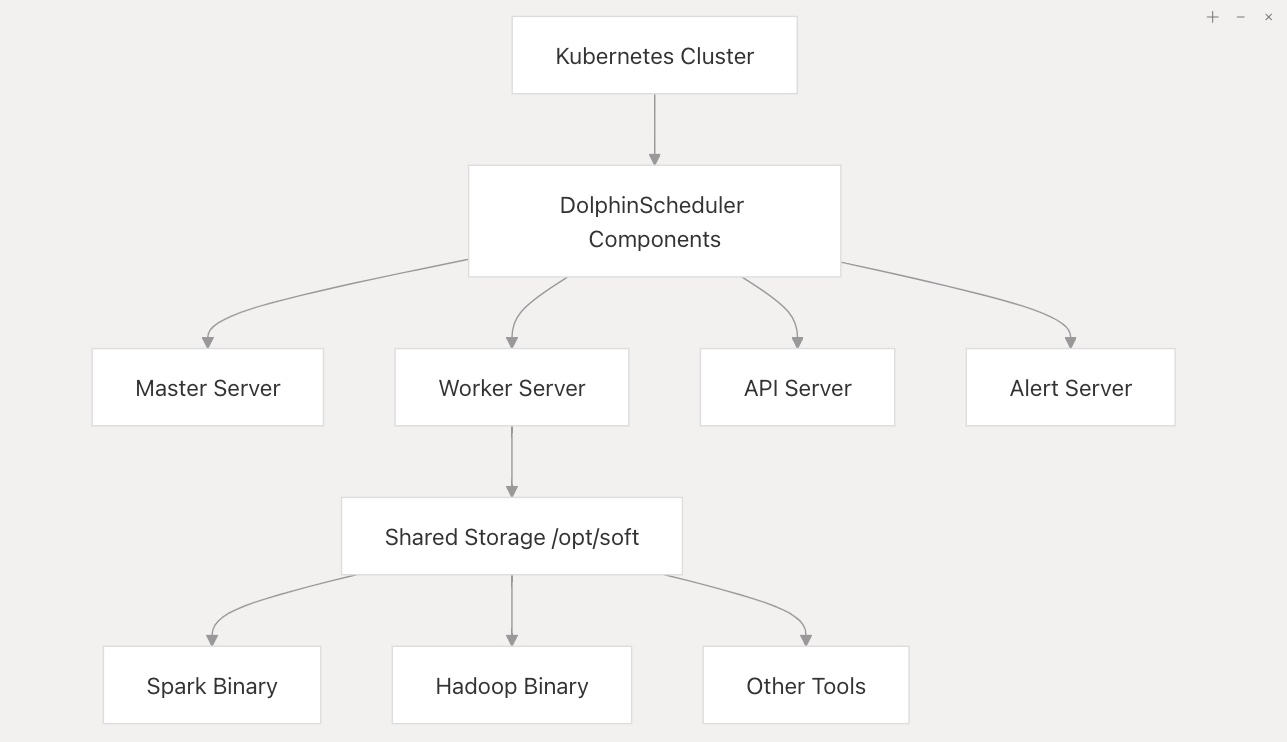
基础部署
1. 添加Helm仓库
helm repo add dolphinscheduler https://dolphinscheduler.apache.org/helm
helm repo update
2. 创建命名空间
kubectl create namespace dolphinscheduler
3. 配置values.yaml
创建自定义的
values.yaml文件,关键配置如下:
# 共享存储配置 - 关键配置,用于存储Spark等二进制文件
common:
  sharedStoragePersistence:
    enabled: true  # 必须启用以支持Spark
    mountPath: "/opt/soft"
    accessModes:
      - "ReadWriteMany"
    storageClassName: "your-storage-class"  # 替换为实际的存储类
    storage: "20Gi"

  configmap:
    # Spark环境变量配置
    SPARK_HOME: "/opt/soft/spark"
    HADOOP_HOME: "/opt/soft/hadoop"
    HADOOP_CONF_DIR: "/opt/soft/hadoop/etc/hadoop"
    JAVA_HOME: "/opt/java/openjdk"
# 数据库配置(使用外部数据库)
externalDatabase:
  enabled: true
  host: "your-mysql-host"
  port: "3306"
  database: "dolphinscheduler"
  username: "root"
  password: "your-password"
  type: "mysql"
# Worker配置
worker:
  replicas: 2
  env:
    WORKER_EXEC_THREADS: "10"
4. 部署DolphinScheduler
helm install dolphinscheduler dolphinscheduler/dolphinscheduler \
  --namespace dolphinscheduler \
  --values values.yaml \
  --version 3.2.0  # 使用具体版本号
5. 验证部署状态
# 查看Pod状态
kubectl get pods -n dolphinscheduler
# 查看服务
kubectl get svc -n dolphinscheduler
# 查看PVC状态
kubectl get pvc -n dolphinscheduler
Spark集成配置
1. 下载Spark二进制包
# 下载Spark 3.2.1为例
wget https://archive.apache.org/dist/spark/spark-3.2.1/spark-3.2.1-bin-hadoop2.7.tgz
2. 复制到Worker容器
由于共享存储已挂载到
/opt/soft,只需复制到一个Worker Pod即可:
# 复制Spark二进制包到容器
kubectl cp spark-3.2.1-bin-hadoop2.7.tgz dolphinscheduler-worker-0:/opt/soft -n dolphinscheduler
# 进入容器解压
kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bash
cd /opt/soft
tar zxf spark-3.2.1-bin-hadoop2.7.tgz
rm -f spark-3.2.1-bin-hadoop2.7.tgz
ln -s spark-3.2.1-bin-hadoop2.7 spark
# 验证Spark安装
$SPARK_HOME/bin/spark-submit --version
3. 配置Hadoop(如需Spark on YARN)
如果需要使用Spark on YARN模式,还需要配置Hadoop:
# 下载Hadoop二进制包
wget https://archive.apache.org/dist/hadoop/common/hadoop-3.3.1/hadoop-3.3.1.tar.gz
# 复制到容器
kubectl cp hadoop-3.3.1.tar.gz dolphinscheduler-worker-0:/opt/soft -n dolphinscheduler
# 解压配置
kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bash
cd /opt/soft
tar zxf hadoop-3.3.1.tar.gz
rm -f hadoop-3.3.1.tar.gz
ln -s hadoop-3.3.1 hadoop
# 配置Hadoop环境变量(已在values.yaml中配置)
export HADOOP_HOME=/opt/soft/hadoop
export HADOOP_CONF_DIR=/opt/soft/hadoop/etc/hadoop
验证Spark任务
1. Shell任务验证
首先通过Shell任务验证Spark环境:
在DolphinScheduler Web UI中创建Shell任务:
$SPARK_HOME/bin/spark-submit --class org.apache.spark.examples.SparkPi \
  $SPARK_HOME/examples/jars/spark-examples_2.12-3.2.1.jar
检查任务日志是否包含输出
Pi is roughly 3.14...。
2. Spark任务验证
上传资源文件
- 在DolphinScheduler资源中心上传
spark-examples_2.12-3.2.1.jar - 创建Spark任务,配置如下:
- 程序类型:Java
-
主函数的Class:
org.apache.spark.examples.SparkPi -
主程序包:
spark-examples_2.12-3.2.1.jar -
部署方式:
local -
Master:
local[*]
Spark SQL任务验证
创建Spark SQL任务:
-- 创建测试表
CREATE TABLE IF NOT EXISTS test_table (
  id INT,
  name STRING
) USING parquet;
-- 插入测试数据
INSERT INTO test_table VALUES (1, 'test'), (2, 'dolphinscheduler');
-- 查询数据
SELECT * FROM test_table;
配置参数:
- 程序类型:SQL
-
部署方式:
local -
Master:
local[*]
支持的Spark部署模式
根据DolphinScheduler文档,当前Kubernetes部署中对不同Spark模式的支持情况:
| 模式 | 支持状态 | 说明 |
|---|---|---|
| Spark-Local(client) | 间接支持 | 需要配置共享存储和Spark二进制 |
| Spark-YARN(cluster) | 间接支持 | 需要额外配置Hadoop环境 |
| Spark-Standalone(cluster) | 尚不支持 | - |
| Spark-Kubernetes(cluster) | 尚不支持 | 原生K8s模式暂未实现 |
高级配置
1. 自定义Worker镜像
如果需要预装Spark,可以构建自定义Worker镜像:
FROM dolphinscheduler.docker.scarf.sh/apache/dolphinscheduler-worker:3.2.0
# 安装Spark
RUN wget https://archive.apache.org/dist/spark/spark-3.2.1/spark-3.2.1-bin-hadoop2.7.tgz && \
    tar zxf spark-3.2.1-bin-hadoop2.7.tgz -C /opt/soft && \
    rm -f spark-3.2.1-bin-hadoop2.7.tgz && \
    ln -s /opt/soft/spark-3.2.1-bin-hadoop2.7 /opt/soft/spark
# 设置环境变量
ENV SPARK_HOME=/opt/soft/spark
构建并推送镜像:
docker build -t your-registry/dolphinscheduler-worker:spark .
docker push your-registry/dolphinscheduler-worker:spark
修改
values.yaml:
worker:
  image:
    repository: your-registry/dolphinscheduler-worker
    tag: spark
2. 资源限制配置
为Worker配置资源限制:
worker:
  resources:
    limits:
      memory: "8Gi"
      cpu: "4"
    requests:
      memory: "4Gi"
      cpu: "2"
3. Worker自动扩缩容
DolphinScheduler支持基于KEDA的Worker自动扩缩容:
# 安装KEDA
kubectl create namespace keda
helm install keda kedacore/keda --namespace keda --version v2.0.0
# 启用Worker自动扩缩容
helm upgrade dolphinscheduler dolphinscheduler/dolphinscheduler \
  --namespace dolphinscheduler \
  --set worker.keda.enabled=true \
  --set worker.keda.minReplicaCount=1 \
  --set worker.keda.maxReplicaCount=10
故障排查
1. 查看Pod日志
# 查看Worker日志
kubectl logs dolphinscheduler-worker-0 -n dolphinscheduler -f
# 查看特定任务日志
kubectl logs dolphinscheduler-worker-0 -n dolphinscheduler | grep "task"
2. 验证共享存储
# 检查PVC状态
kubectl get pvc -n dolphinscheduler
# 进入容器验证挂载
kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bash
df -h | grep opt/soft
ls -la /opt/soft
3. 验证环境变量
kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bash
echo $SPARK_HOME
echo $HADOOP_HOME
$SPARK_HOME/bin/spark-submit --version
4. 常见问题
问题1:Spark命令找不到
- 检查
SPARK_HOME环境变量是否正确配置 - 验证Spark二进制文件是否正确解压到
/opt/soft
问题2:共享存储无法挂载
- 确认存储类支持ReadWriteMany访问模式
- 检查PVC状态和存储类配置
问题3:Spark on YARN失败
- 确认Hadoop环境正确配置
- 验证
HADOOP_CONF_DIR指向正确的配置目录 - 检查YARN集群连接性
生产环境建议
- 存储配置:使用高性能存储类(如SSD)作为共享存储,提升Spark作业性能
- 资源配额:为Worker设置合理的资源限制,避免资源争抢
- 监控告警:配置Pod和作业级别的监控告警
- 高可用:Master和Worker至少配置2个副本
- 备份策略:定期备份数据库和资源文件
Notes
本文基于Apache DolphinScheduler 3.2.0版本编写,不同版本可能存在配置差异。Spark-Kubernetes(cluster)原生模式在当前版本中尚不支持,如需此功能需等待后续版本更新。实际部署时请根据具体环境调整配置参数,特别是存储类、数据库连接等环境相关配置。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70014275/viewspace-3176453/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 任务失败了,日志却消失了?一次DolphinScheduler异常任务排查
- 数据生产到智能应用:Apache DolphinScheduler 数仓落地实践
- DolphinScheduler 的 Master 是怎么跑起来的?带你看懂启动源码
- Apache DolphinScheduler 3.4.3 发布!权限安全与稳定性全面增强,调度补火即将上线
- 以 Harness 重构数据工程:Agent 时代的新范式
- Apache DolphinScheduler 8 月报:权限安全加固,调度补火上线,性能与稳定性持续提升
- DolphinScheduler 任务实例 Host 为空?一次内存保护机制引发的调度罢工
- DolphinScheduler 挂了你不知道?Prometheus + Grafana 监控兜底方案,亲测可用
- 把 ApacheDolphinScheduler 变成 Agent 的“手和脚”:从调度平台到自然语言数据入口
- 希望你永远用不上:Apache DolphinScheduler 任务阻塞死锁排查与解决方案
