数据生产到智能应用:Apache DolphinScheduler 数仓落地实践
随着企业数字化建设不断深入,数据平台正在从传统的数据存储和分析系统,逐渐演变为支撑业务决策、智能应用和数据资产管理的重要基础设施。如何构建稳定、高效、可扩展的数据生产体系,成为企业数仓建设中的关键挑战。
在 Apache DolphinScheduler 9 月 Meetup 分享中,来自社区的技术实践者刘赞围绕企业级数仓建设展开分享,介绍了如何以 Apache DolphinScheduler 为核心,结合数据同步、数据处理、数据应用以及运维管理等环节,构建完整的数据工程体系。
本文根据本次 Meetup 内容整理,围绕环境搭建、数据处理、数据应用、运维升级四个阶段,深入解析 Apache DolphinScheduler 在企业数仓实践中的应用。
👉🏻 查看 直播回顾
作者简介
一、环境搭建:构建面向企业数仓的数据基础设施
企业级数仓建设的第一步,是选择适合业务发展的技术架构,并搭建稳定可靠的数据基础环境。
在早期大数据建设过程中,Hadoop 生态凭借分布式存储和计算能力,成为众多企业的数据平台基础。然而随着业务实时性要求提升,传统架构在部分场景下逐渐暴露出局限。
一方面,传统 Hadoop 架构主要面向离线批处理任务,作业执行通常存在分钟级延迟,对于实时分析和快速决策场景支持不足。另一方面,计算和存储资源高度绑定,当企业需要扩展某一类资源时,往往会同时影响另一类资源的利用效率。此外,复杂的大数据组件生态也增加了版本管理、系统维护以及技术学习成本。
因此,在新的企业数仓实践中,采用更加轻量化、高性能的 OLAP 架构成为一种趋势。
1. 技术选型:以 OLAP 数据库支撑高性能分析需求
在数仓建设初期,团队采用了传统大数据数仓架构。但随着数据规模增长以及业务分析需求不断提升,原有架构在实际使用过程中逐渐暴露出一些局限。
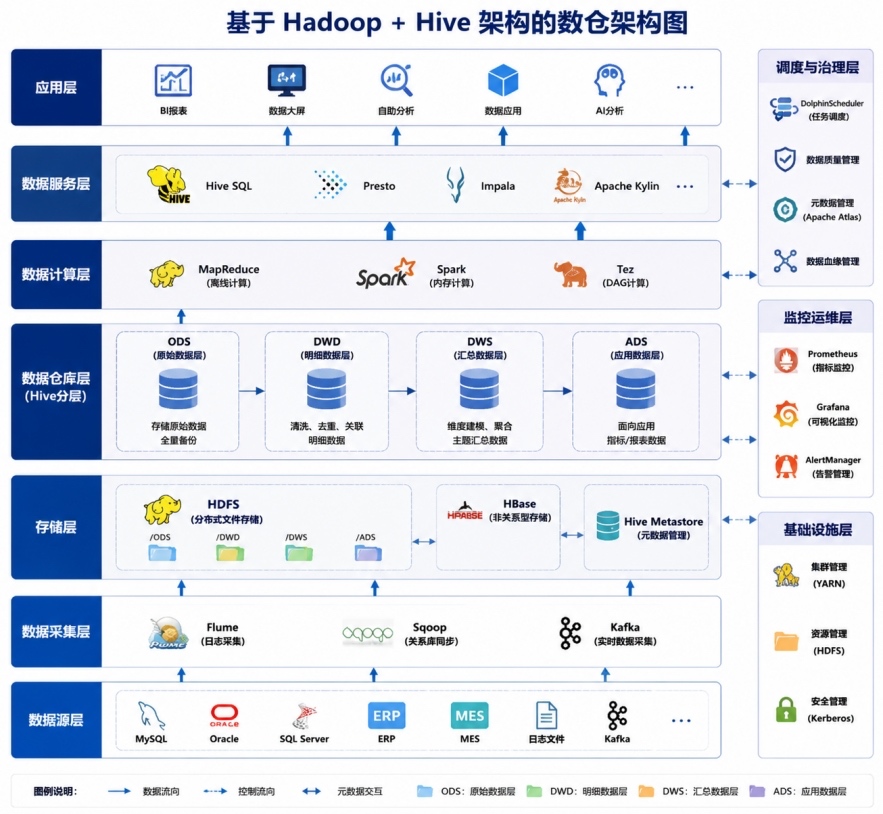
首先,传统数仓架构主要面向离线批处理场景,任务执行通常存在较高延迟,作业运行时间普遍达到分钟级,难以满足部分业务场景对于低延迟数据分析的需求。
其次,传统架构存在存算紧耦合的问题。由于计算节点同时承担数据存储和计算任务,当业务发展需要单独扩展计算资源或存储资源时,另一类资源往往也会受到影响,导致资源利用率下降,增加了平台扩展难度。
此外,传统大数据生态通常依赖多个组件协同运行,组件数量较多,不同版本之间存在适配要求,进一步提高了平台学习、部署以及后续运维成本。
针对传统架构在性能、扩展以及运维方面的问题,团队在后续数仓建设中选择采用分布式 OLAP 数据库架构,以提升数据分析能力和平台整体效率。
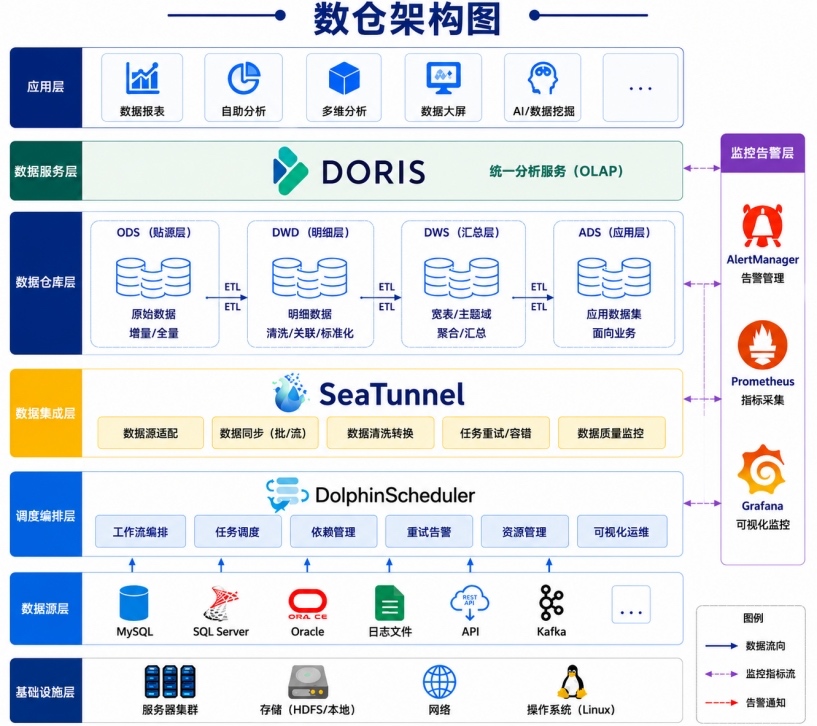
其中,调度编排层采用的是开源项目 Apache DolphinScheduler,来进行工作流编排、任务调度、依赖管理、重试告警、资源管理和可视化运维等,数据集成层采用的也是开源项目——Apache SeaTunnel,用来进行数据源适配、批/流数据同步、数据转换清洗等。
新架构首先具备更高的数据查询性能。基于分布式 OLAP 架构,可以实现亚秒级海量数据查询响应,在宽表聚合等分析场景中,相比传统方案性能提升 5~10 倍,能够更好满足业务快速分析需求。
其次,新架构具备更好的扩展能力。相比传统 Hadoop 生态需要依赖 HBase、Spark 等多个组件,新方案减少了对大量第三方组件的依赖,使整体架构更加简洁,降低了系统扩展和维护难度。
同时,新架构基于分布式集群技术,具备更高并发处理能力,可以降低单节点 IO 资源压力,提高数据平台运行稳定性。
通过此次技术选型,团队完成了从传统数仓架构到新型 OLAP 架构的升级,为后续数据同步、数据处理以及业务应用建设提供了更加稳定的数据基础。
2. 环境搭建:降低大数据平台部署复杂度
完成数仓架构选型后,下一步需要搭建支撑数据处理流程运行的基础环境。
在环境搭建过程中,团队采用集群管理工具完成大数据环境部署。该工具具备快速部署、兼容开源生态以及便捷运维等特点。
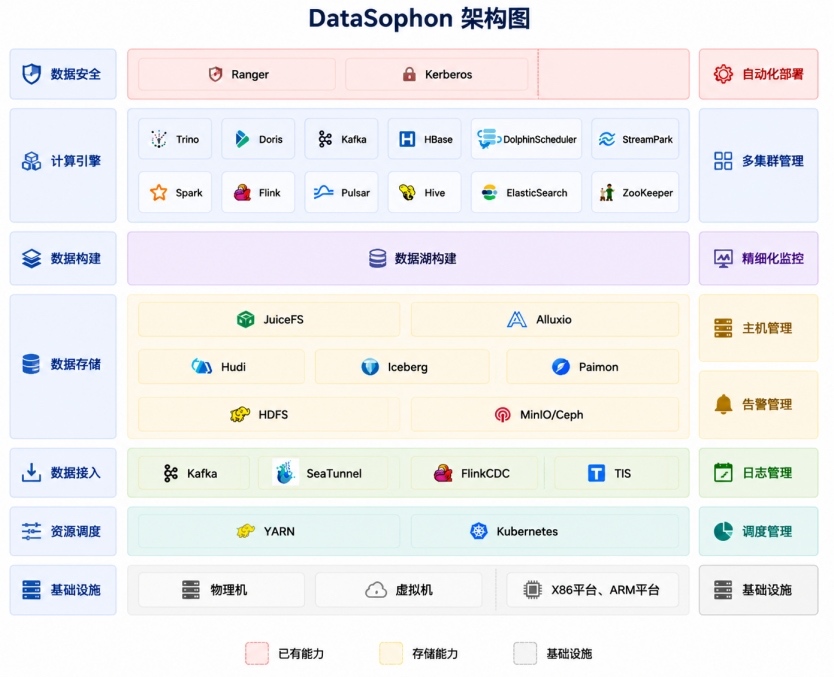
通过统一化管理方式,用户可以快速完成大规模大数据集群初始化,同时覆盖数据集成、数据存储、计算引擎、任务调度以及权限管理等多个环节。
在运维方面,该工具能够对集群、节点以及服务进行统一监控和管理,提高日常运维效率。
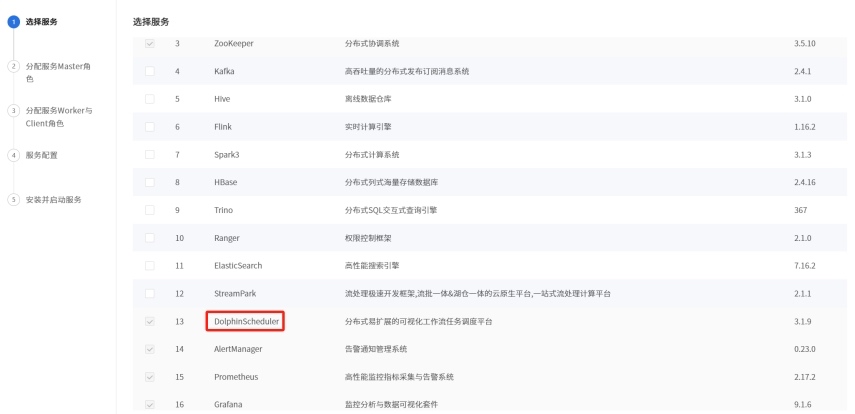
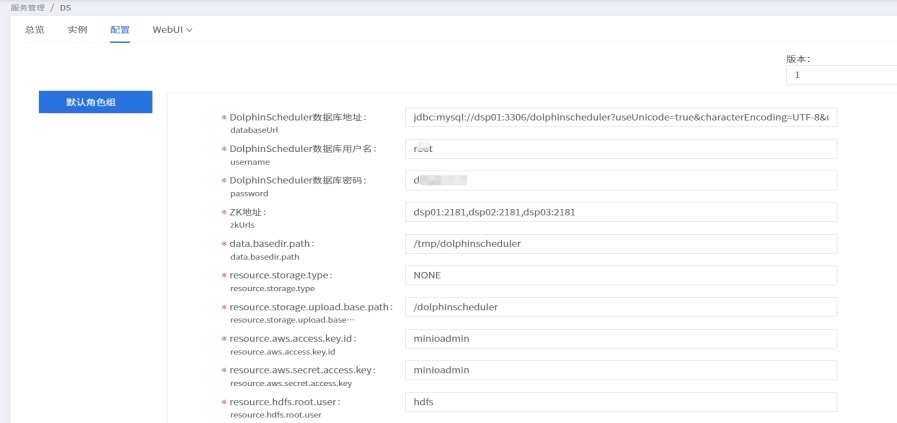
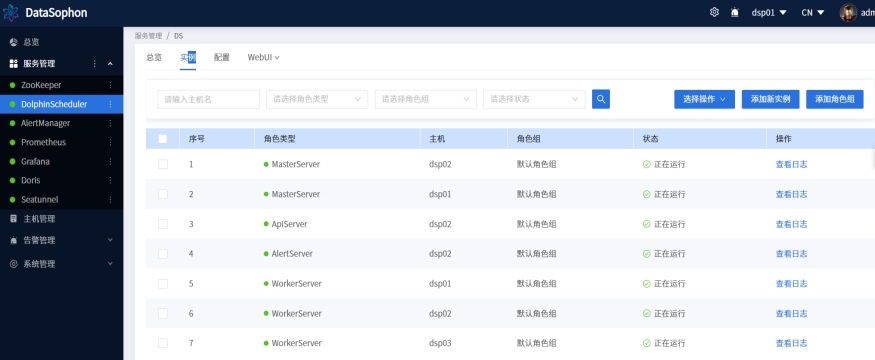
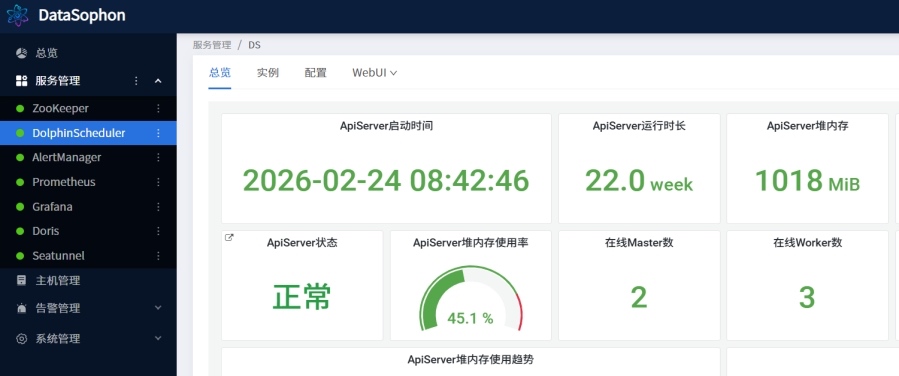
在基础环境搭建完成后,团队进一步部署 Apache DolphinScheduler,为后续数据任务执行提供统一调度能力。
3. 搭建过程:部署 Apache DolphinScheduler
在整体数仓架构中,Apache DolphinScheduler 主要承担数据任务编排和调度管理职责。
通过部署 DolphinScheduler,团队可以将后续数据同步、数据加工等任务统一纳入工作流管理体系,为数据处理流程提供可视化编排和自动化执行能力。
二、数据处理:以 Apache DolphinScheduler 串联数据生产流程
完成基础环境搭建后,数据处理成为数仓建设中的核心环节。在本次实践中,团队围绕数据同步、数据加工以及任务调度等流程展开建设,并通过 Apache DolphinScheduler 对数据任务进行统一编排。
在整体数据处理链路中,DolphinScheduler 负责工作流管理和任务调度,Apache SeaTunnel 负责数据同步,二者结合实现了从数据采集到数据加工的自动化流程。
本次实践主要涉及 Apache DolphinScheduler 应用、SeaTunnel 集成、镜像表同步、模型层逻辑处理、交换表应用以及实时方案预研等内容。
1. Apache DolphinScheduler 应用:实现数据任务统一调度
在数据处理过程中,团队采用 Apache DolphinScheduler 对任务流程进行统一管理。
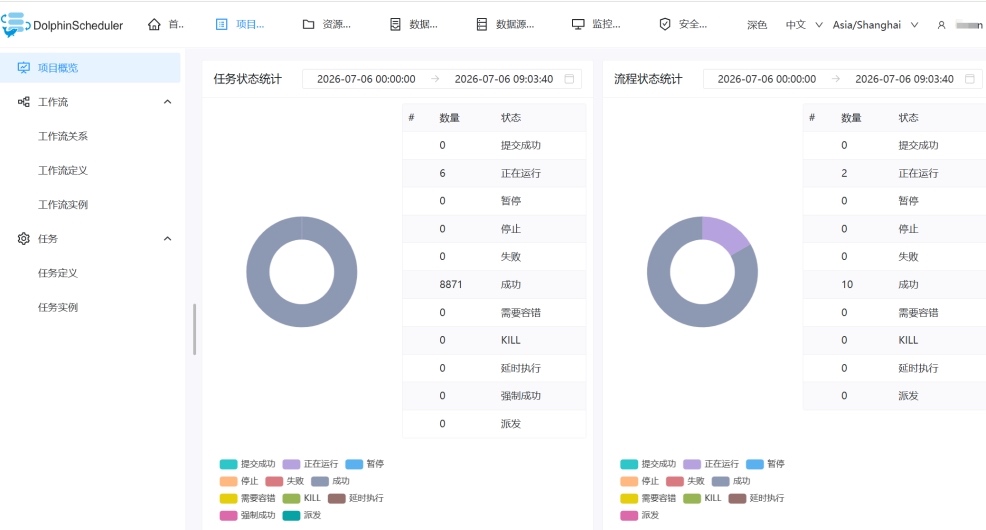
相比传统通过脚本手动维护任务执行关系的方式,DolphinScheduler 提供了可视化工作流编排能力。用户可以通过页面拖拽方式定义任务流程,将不同的数据处理任务按照依赖关系组织成 DAG 工作流,降低了任务管理复杂度。
同时,DolphinScheduler 支持多种任务类型,并具备跨语言扩展能力,可以适配不同数据处理场景。在实际数仓建设过程中,不同类型的数据任务可以统一纳入调度体系,方便进行流程管理和维护。
在稳定性方面,DolphinScheduler 采用去中心化设计,提升了调度系统运行稳定性,为数据任务持续执行提供保障。
通过引入 DolphinScheduler,团队将数据同步、数据加工等环节连接起来,实现了数据生产流程的统一调度。
2. Apache SeaTunnel 集成:构建数据同步链路
在数据采集和同步环节,团队引入 Apache SeaTunnel 作为数据集成组件,承担不同数据源之间的数据传输任务。
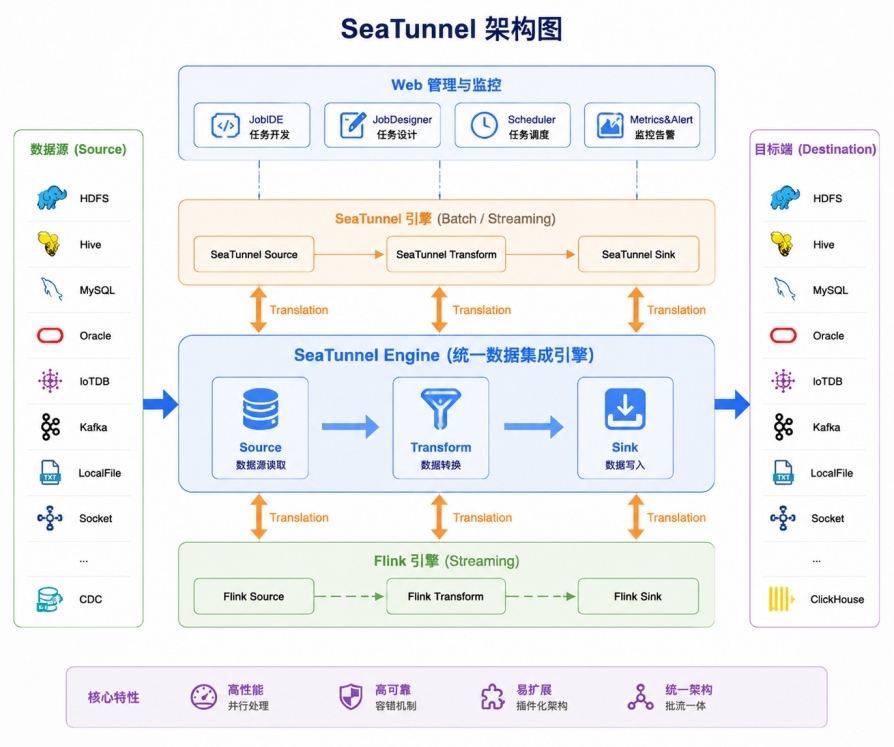
SeaTunnel 基于 Connector 机制,可以支持离线同步、实时同步、全量同步以及增量同步等多种数据同步场景,降低了数据集成任务管理的复杂度。
在执行引擎方面,SeaTunnel 默认采用 Zeta 引擎,同时支持 Flink 和 Spark 作为 Connector 执行引擎,为不同业务场景提供更加灵活的选择。
此外,SeaTunnel 通过并行读写机制提升数据传输效率,能够提供稳定、高吞吐、低延迟的数据同步能力。
在整体数据处理架构中,DolphinScheduler 与 SeaTunnel 形成协同关系:DolphinScheduler 负责任务流程编排和执行调度,SeaTunnel 负责具体的数据同步操作,共同支撑数仓数据流转。
3. 镜像表同步:提升数据同步灵活性
在数据同步过程中,团队采用镜像表同步方案完成数据迁移。
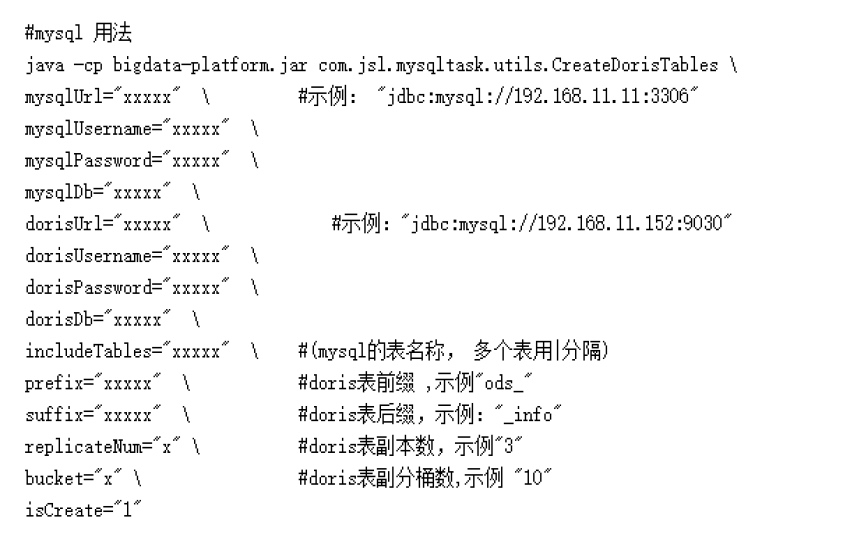
表结构同步,配置灵活,操作简单
该方案在配置方式上类似 DataX,同时提供更加丰富的数据同步能力。在实际应用中,通过工具完成表结构同步,再结合 DolphinScheduler 对数据同步任务进行统一调度,实现数据同步流程自动化。
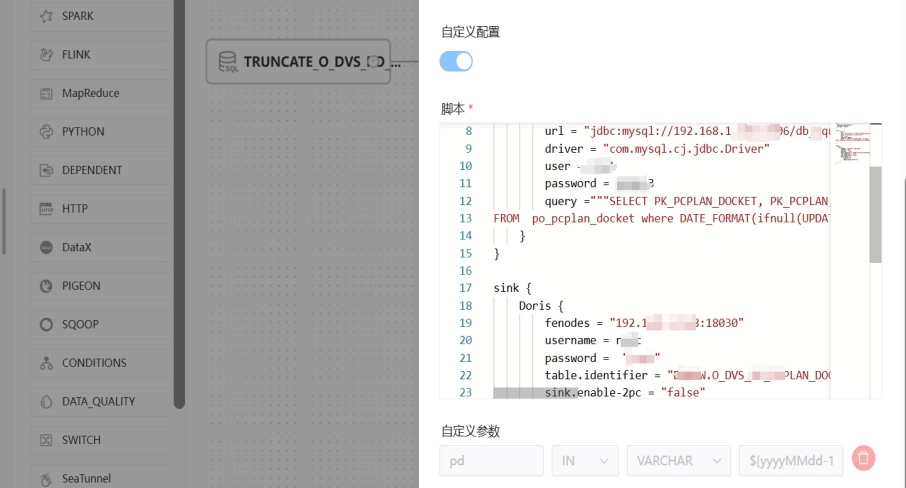
数据同步(DolphinScheduler)
通过将同步任务纳入调度体系,数据同步过程能够按照既定流程自动执行,并结合任务状态进行统一管理,提高数据处理过程的可控性。
4. 模型层逻辑处理:简化数据加工流程
完成数据同步后,团队进一步对数据进行模型层处理。
在模型层数据清洗环节,采用 Shell 脚本进行逻辑处理,通过脚本方式提升开发效率,同时减少后续维护成本。
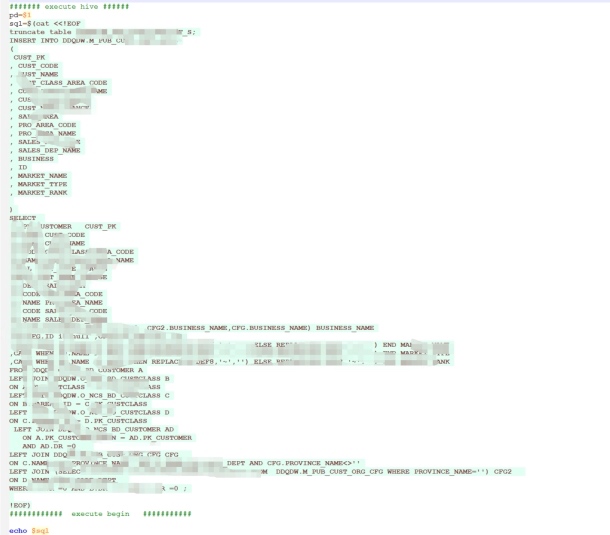
在实际流程中,模型层处理任务同样可以通过 DolphinScheduler 进行统一调度,与前后的数据同步任务形成完整的数据加工流程。
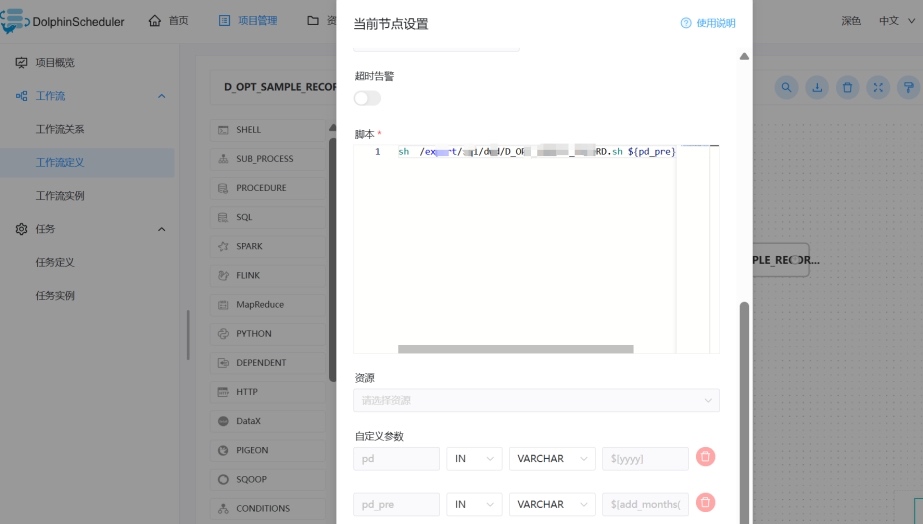
5. 交换表应用:实现无感知数据切换
在数据更新过程中,为提高数据可靠性和稳定性,团队采用交换表机制进行数据切换。
通过交换表的方式,可以实现表数据的无感知切换,减少数据更新过程对业务使用的影响。
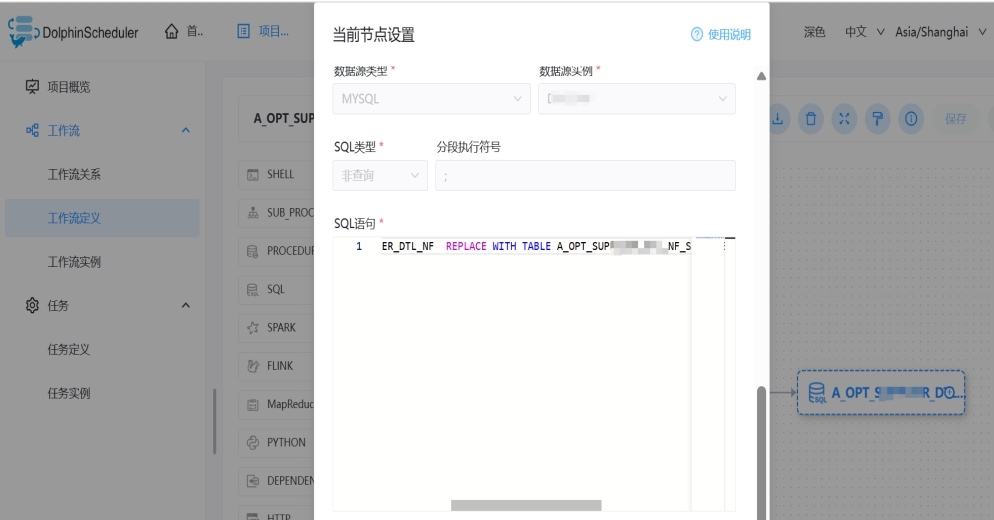
结合 DolphinScheduler 的任务编排能力,数据处理、数据切换等流程可以按照预设顺序自动执行,进一步提升数据生产流程的稳定性。
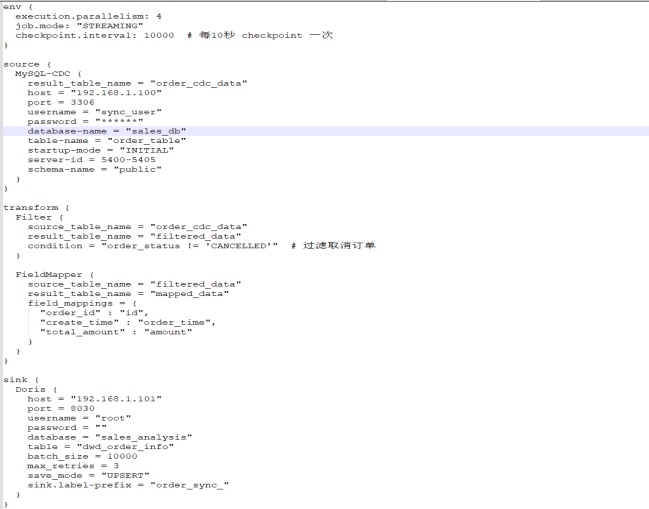
6. 实时方案预研:探索 CDC 实时同步方案
除离线数据处理流程外,团队也针对实时数据同步场景进行了方案预研。
本次实践探索了一种非 Flink 架构的 CDC 实时同步方案,该方案具有架构简洁、性能优越以及运维友好的特点。
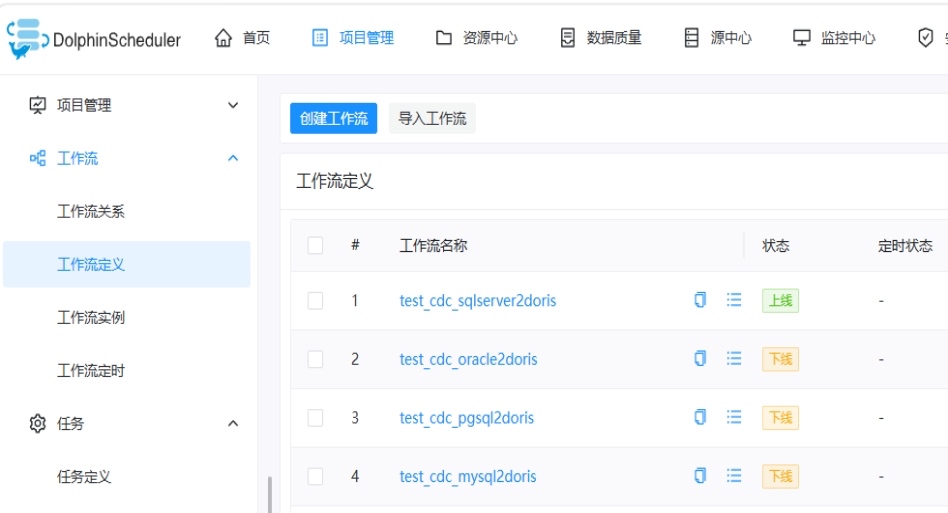
通过对实时同步方案进行探索,团队进一步完善数据处理能力,为后续不同场景的数据应用提供支持。
三、数据应用:从数据分析到智能化数据服务
完成数据采集、同步和加工后,数据需要进一步服务于业务分析和应用场景。在本次数仓建设实践中,团队围绕 BI 应用、AI 智能体应用以及数据治理三个方向,对数据应用能力进行了建设。
1. BI 应用:支撑数据分析和业务展示
在数据应用阶段,团队通过数据库接口与 BI 工具进行连接,实现数据分析和展示。
基于内置 JDBC 驱动,可以直接连接数据库,提供较高的并发能力和查询响应速度。同时,通过 MySQL 协议接口,可以实现与现有数据分析工具的兼容对接。
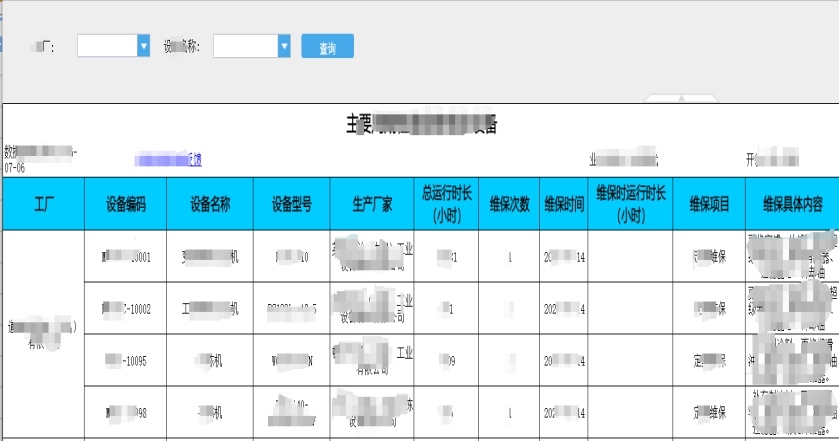
报表应用(FineReport)
在具体应用场景中,团队通过 FineReport 支撑报表应用,通过 DataEase 支撑数据大屏展示。
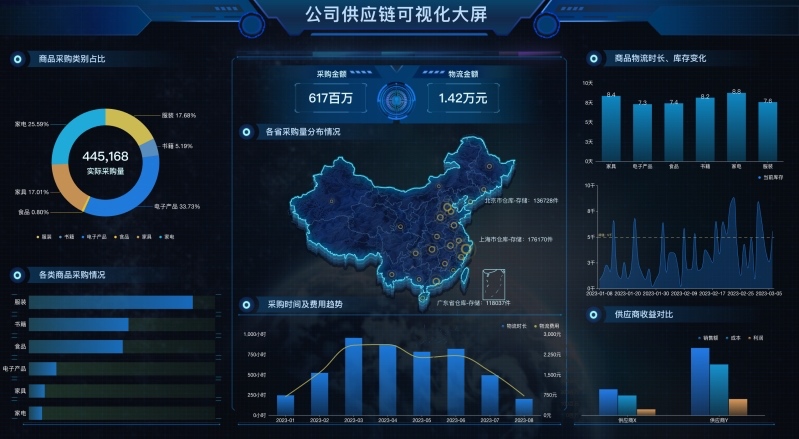
大屏应用(DataEase)
通过前面的数据处理流程,数据同步、数据加工等任务由 Apache DolphinScheduler 统一调度,保证数据能够按照既定流程完成更新,为后续 BI 查询和展示提供稳定的数据基础。
2. AI 智能体应用:探索数据问数场景
在传统数据分析场景中,用户通常需要通过报表或者查询工具获取数据。为了进一步拓展数据应用方式,团队基于 Dify 开展数据问数智能体开发。
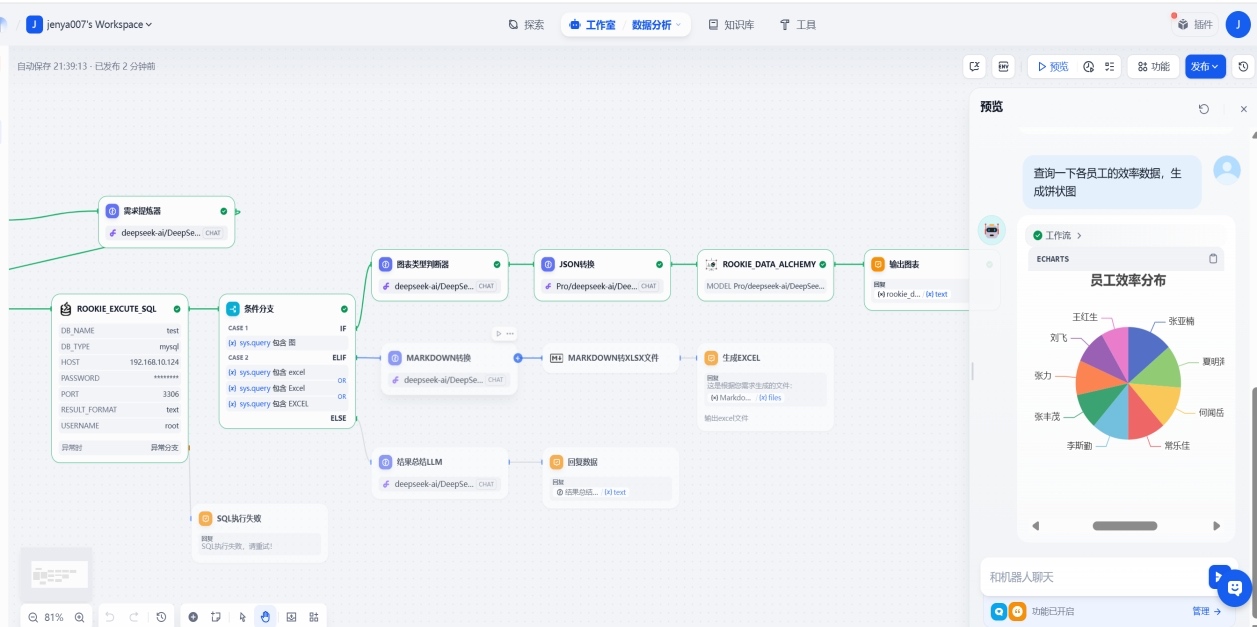
通过构建数据问数智能体,用户可以通过更加便捷的方式访问数据,为数据应用提供了更多可能。
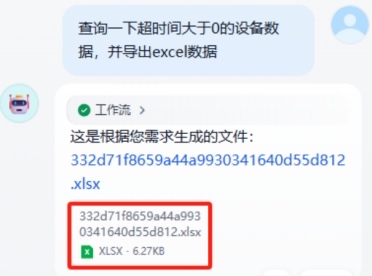
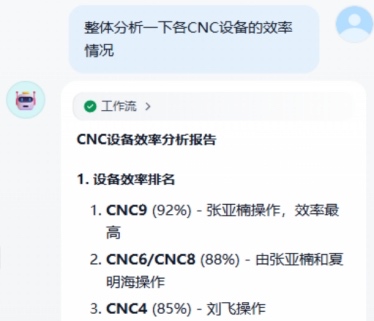
在这一实践中,数据平台不仅需要提供稳定的数据处理能力,同时也需要为上层应用提供可靠的数据支撑。前端智能应用依赖的数据,仍然需要通过底层数仓的数据同步和加工流程持续产生。
3. 数据治理:完善元数据管理能力
随着数据资产不断积累,数据治理成为数仓建设中的重要环节。
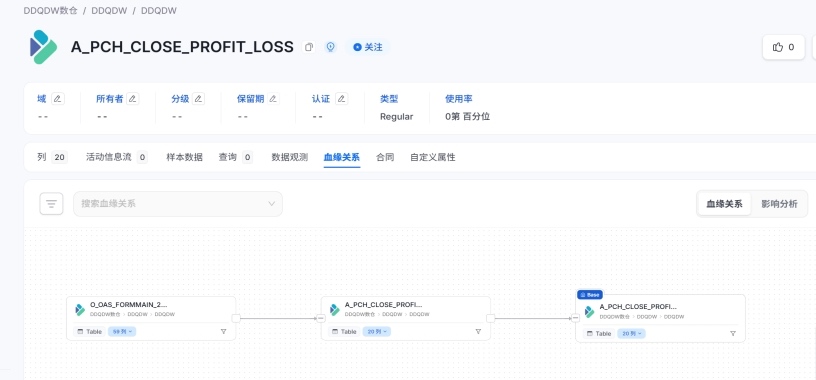
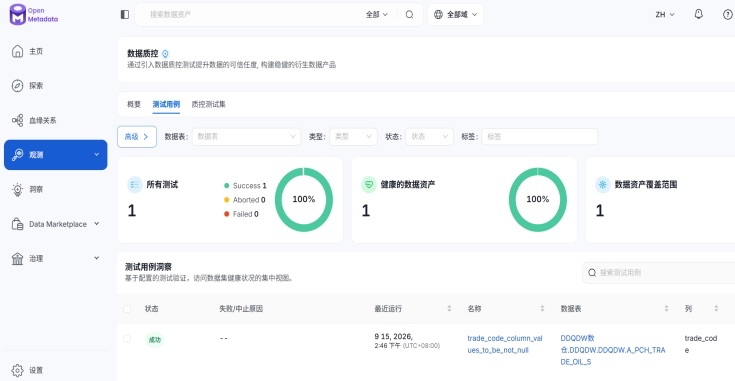
在本次实践中,团队通过 OpenMetadata 对 Doris 数据库提供支持,实现元数据管理能力。
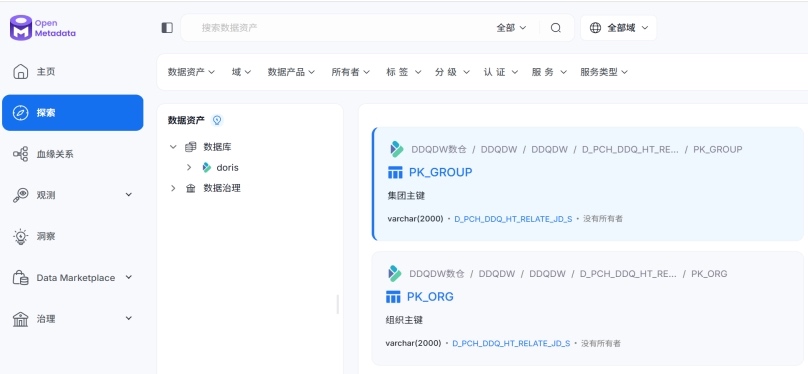
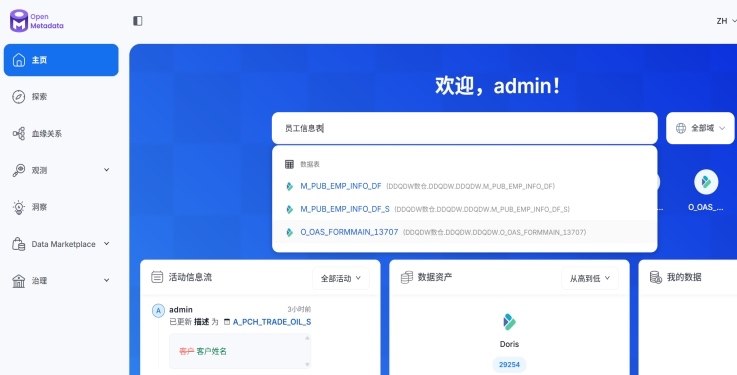
通过元数据管理,可以对数据库中的数据资产信息进行统一管理,为数据使用和后续维护提供支持。
四、运维升级:保障数仓平台稳定运行
在完成数仓建设和数据应用落地后,平台的长期稳定运行仍然需要完善的运维体系支持。
本次实践主要围绕日志监控、升级维护以及异常告警三个方面,对平台运维能力进行了完善。
1. 日志监控:提升系统运行可观测能力
在日常运行过程中,团队通过日志监控及时了解各组件运行状态。
通过实时查看组件运行日志,并结合指标采集和自定义告警机制,可以及时发现异常情况并进行处理。
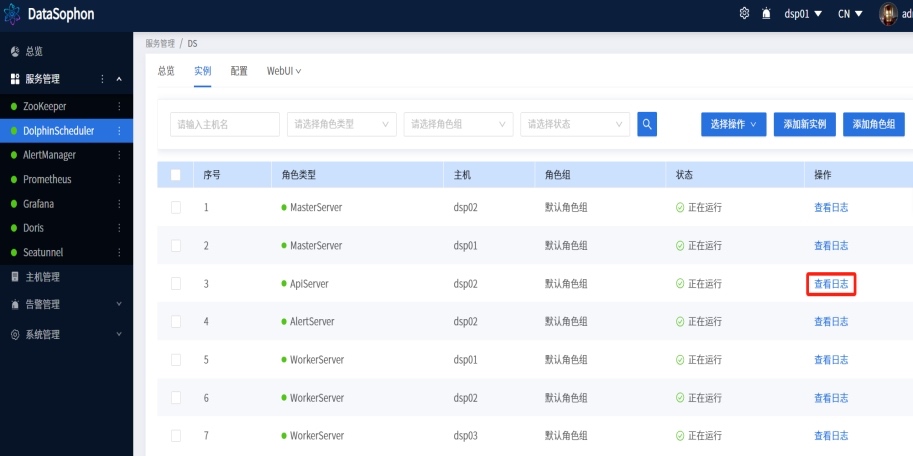
在具体实践中,通过 Apache DolphinScheduler 查看任务运行日志,同时结合 Prometheus 和 Grafana 完成日常监控。
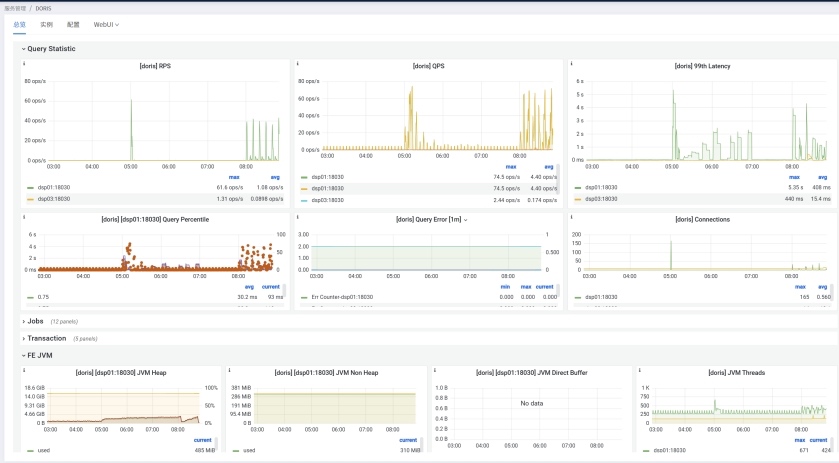
其中,DolphinScheduler 提供任务执行过程中的日志查看能力,Prometheus 和 Grafana 则用于平台运行指标监控,共同提升系统运行管理能力。
2. 升级维护:简化 Doris 集群管理
在数据库集群维护过程中,团队采用 DorisManager 进行 Doris 集群管理。
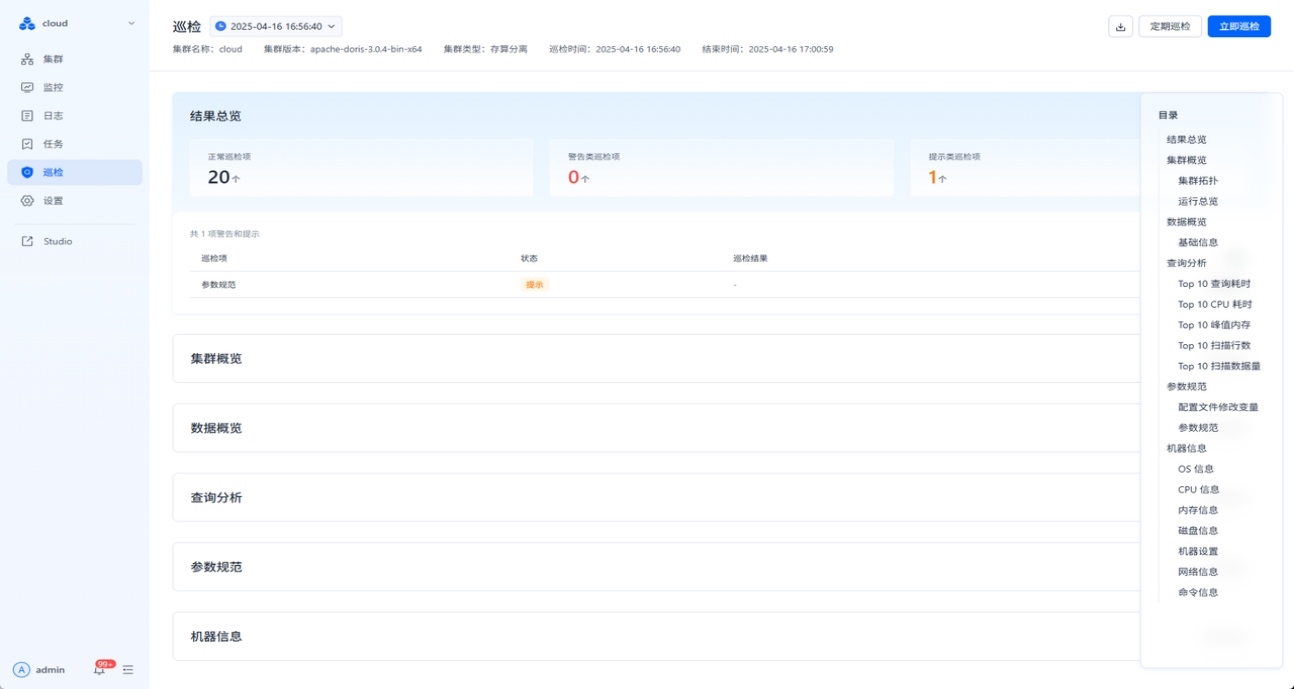
通过一站式 Doris 集群管理工具,可以简化集群升级和维护操作,提高平台管理效率。
3. 异常告警:建立任务失败通知机制
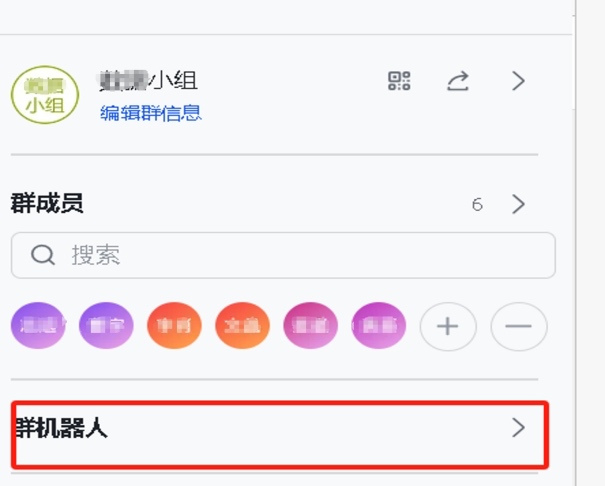
为了及时发现数据任务异常,团队在 Apache DolphinScheduler 中配置告警实例,并结合飞书机器人完成异常通知。
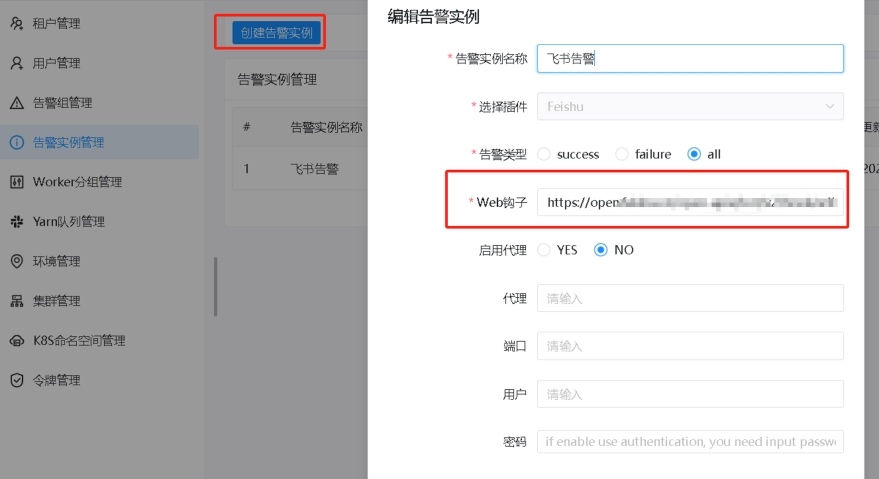
当任务运行过程中出现异常时,系统可以通过告警机制及时通知相关人员,帮助快速定位和处理问题。
总结:Apache DolphinScheduler 支撑企业数仓全流程建设
本次 Apache DolphinScheduler 9 月 Meetup 分享,围绕企业级数仓建设实践,展示了一套从环境搭建、数据处理到数据应用和运维管理的完整流程。
在整体架构中,Apache DolphinScheduler 贯穿数据生产流程,通过工作流编排和任务调度连接数据同步、数据加工以及任务运维等环节;Apache SeaTunnel 负责数据同步,OLAP 数据库支撑数据分析,BI 工具、AI 智能体和元数据管理进一步拓展数据应用能力。
通过这一实践,团队构建了一套覆盖数据处理和数据应用的数据平台体系,为数仓稳定运行提供了完整支撑。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70014275/viewspace-3183396/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 任务失败了,日志却消失了?一次DolphinScheduler异常任务排查
- DolphinScheduler 的 Master 是怎么跑起来的?带你看懂启动源码
- Apache DolphinScheduler 3.4.3 发布!权限安全与稳定性全面增强,调度补火即将上线
- 以 Harness 重构数据工程:Agent 时代的新范式
- Apache DolphinScheduler 8 月报:权限安全加固,调度补火上线,性能与稳定性持续提升
- DolphinScheduler 任务实例 Host 为空?一次内存保护机制引发的调度罢工
- DolphinScheduler 挂了你不知道?Prometheus + Grafana 监控兜底方案,亲测可用
- 把 ApacheDolphinScheduler 变成 Agent 的“手和脚”:从调度平台到自然语言数据入口
- 希望你永远用不上:Apache DolphinScheduler 任务阻塞死锁排查与解决方案
- Apache DolphinScheduler 单机部署实战 | Docker 一把梭,10分钟搞定!
