DolphinScheduler 任务实例 Host 为空?一次内存保护机制引发的调度罢工
一、问题现象
1.1 告警信息
凌晨 4 点多,收到一连串调度失败告警:
scheduler failed
projectName: 数仓平台
processName: 【ods】同步MySQL「每小时」
taskName: OPTIMIZE table_records
taskType: SQL
taskState: FAILURE
taskEndTime: 2026-03-13 04:34:01
1.2 页面表现
登录 DolphinScheduler 查看任务实例,发现两个关键异常:
- 任务状态:失败
- 任务实例 Host:为空
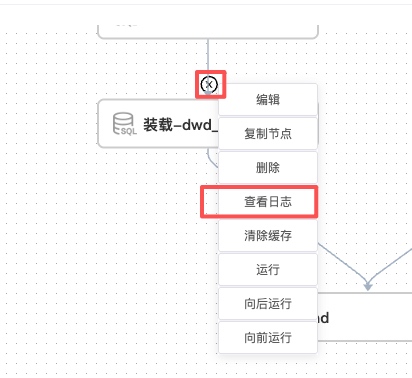
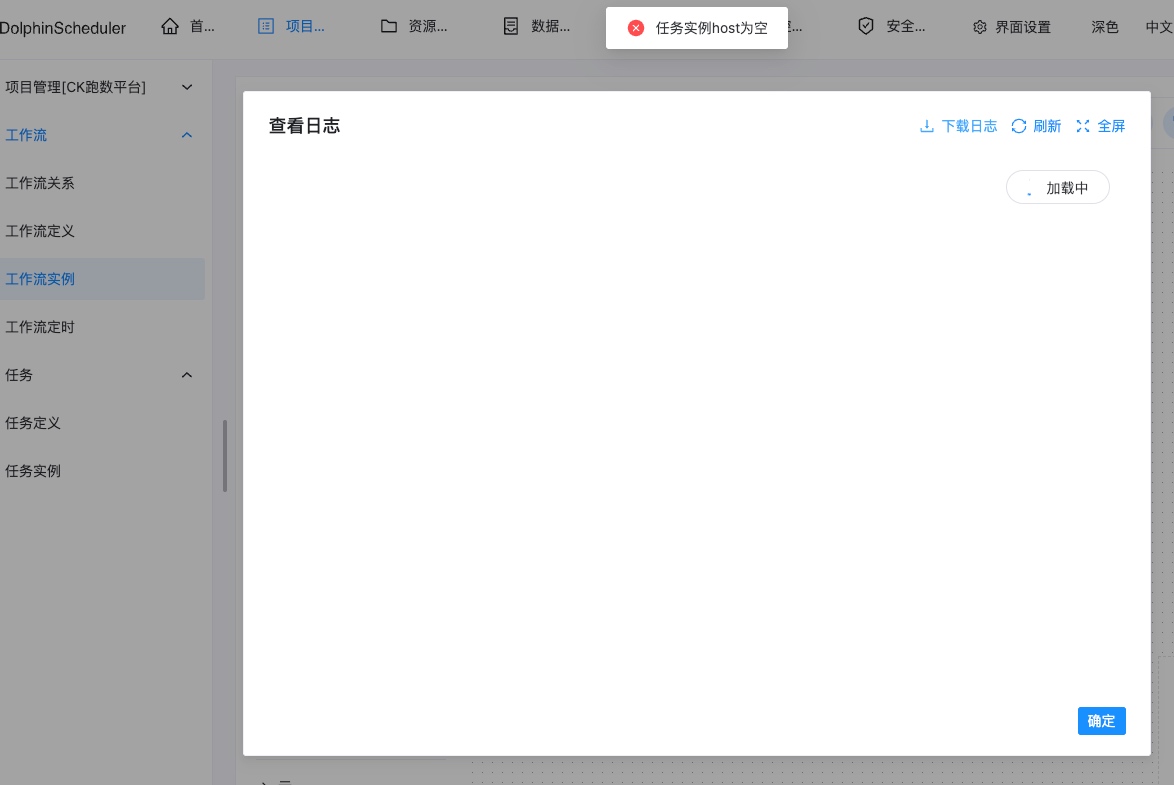
Host 为空意味着什么? 没有任何 Worker 节点愿意接这个任务。 任务连"被执行"的机会都没有,直接被拒之门外。
二、排查过程
2.1 先看系统资源
第一反应:是不是机器资源出问题了?
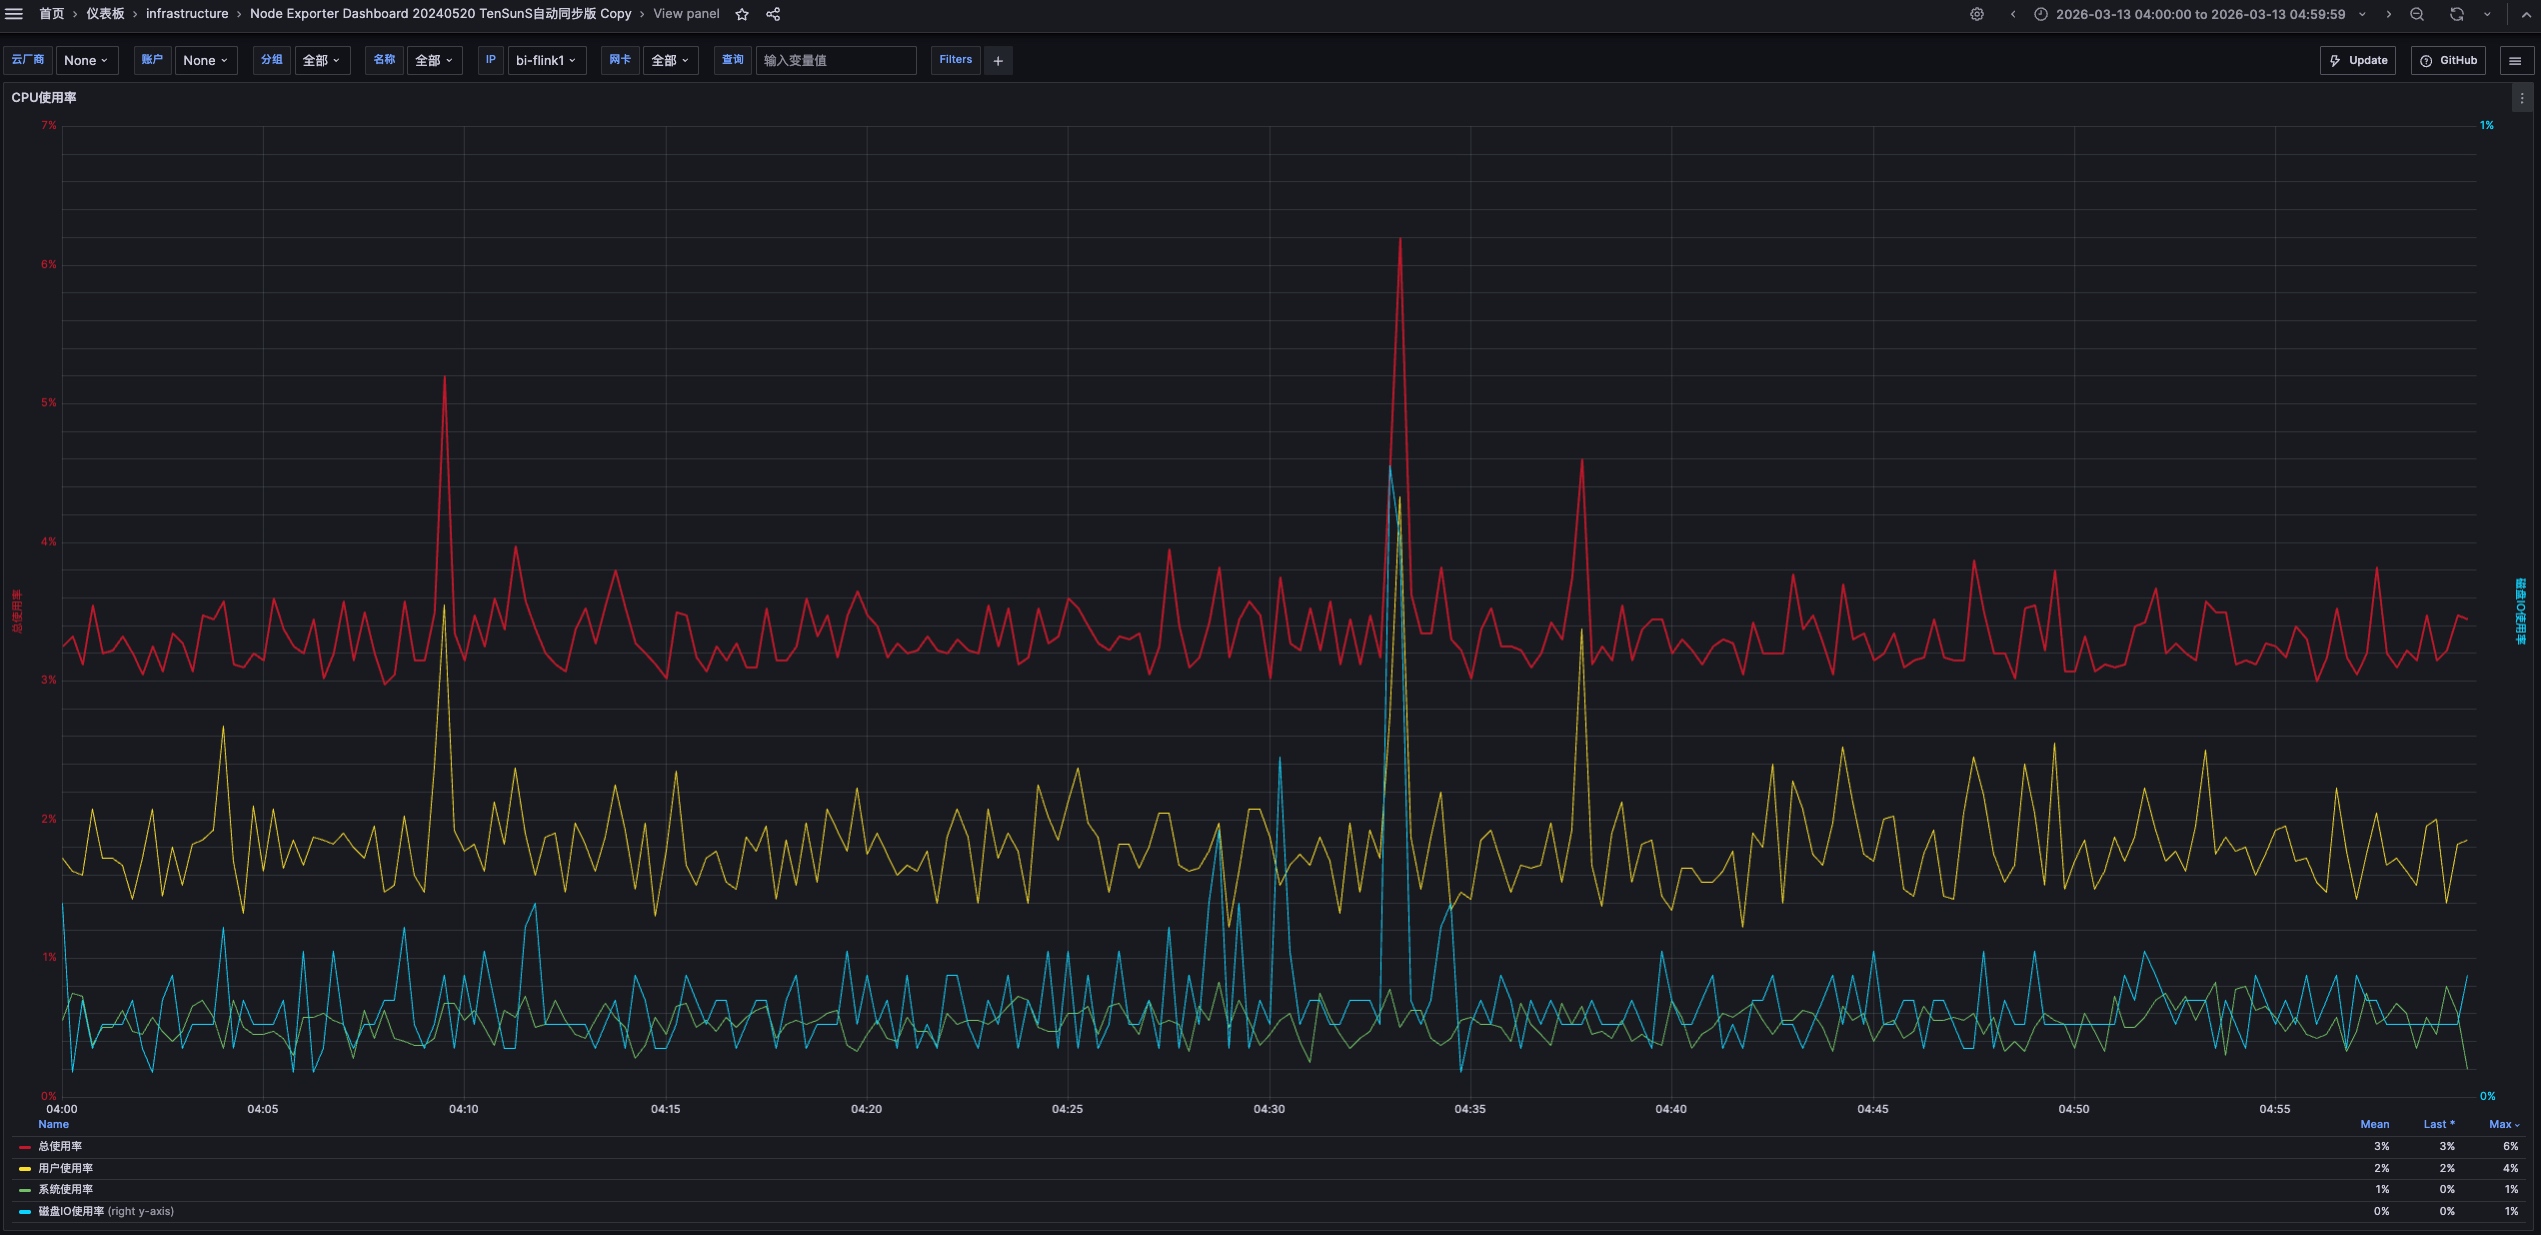
CPU 使用率:很低,不是瓶颈。
内存使用率:嗯?有点高。
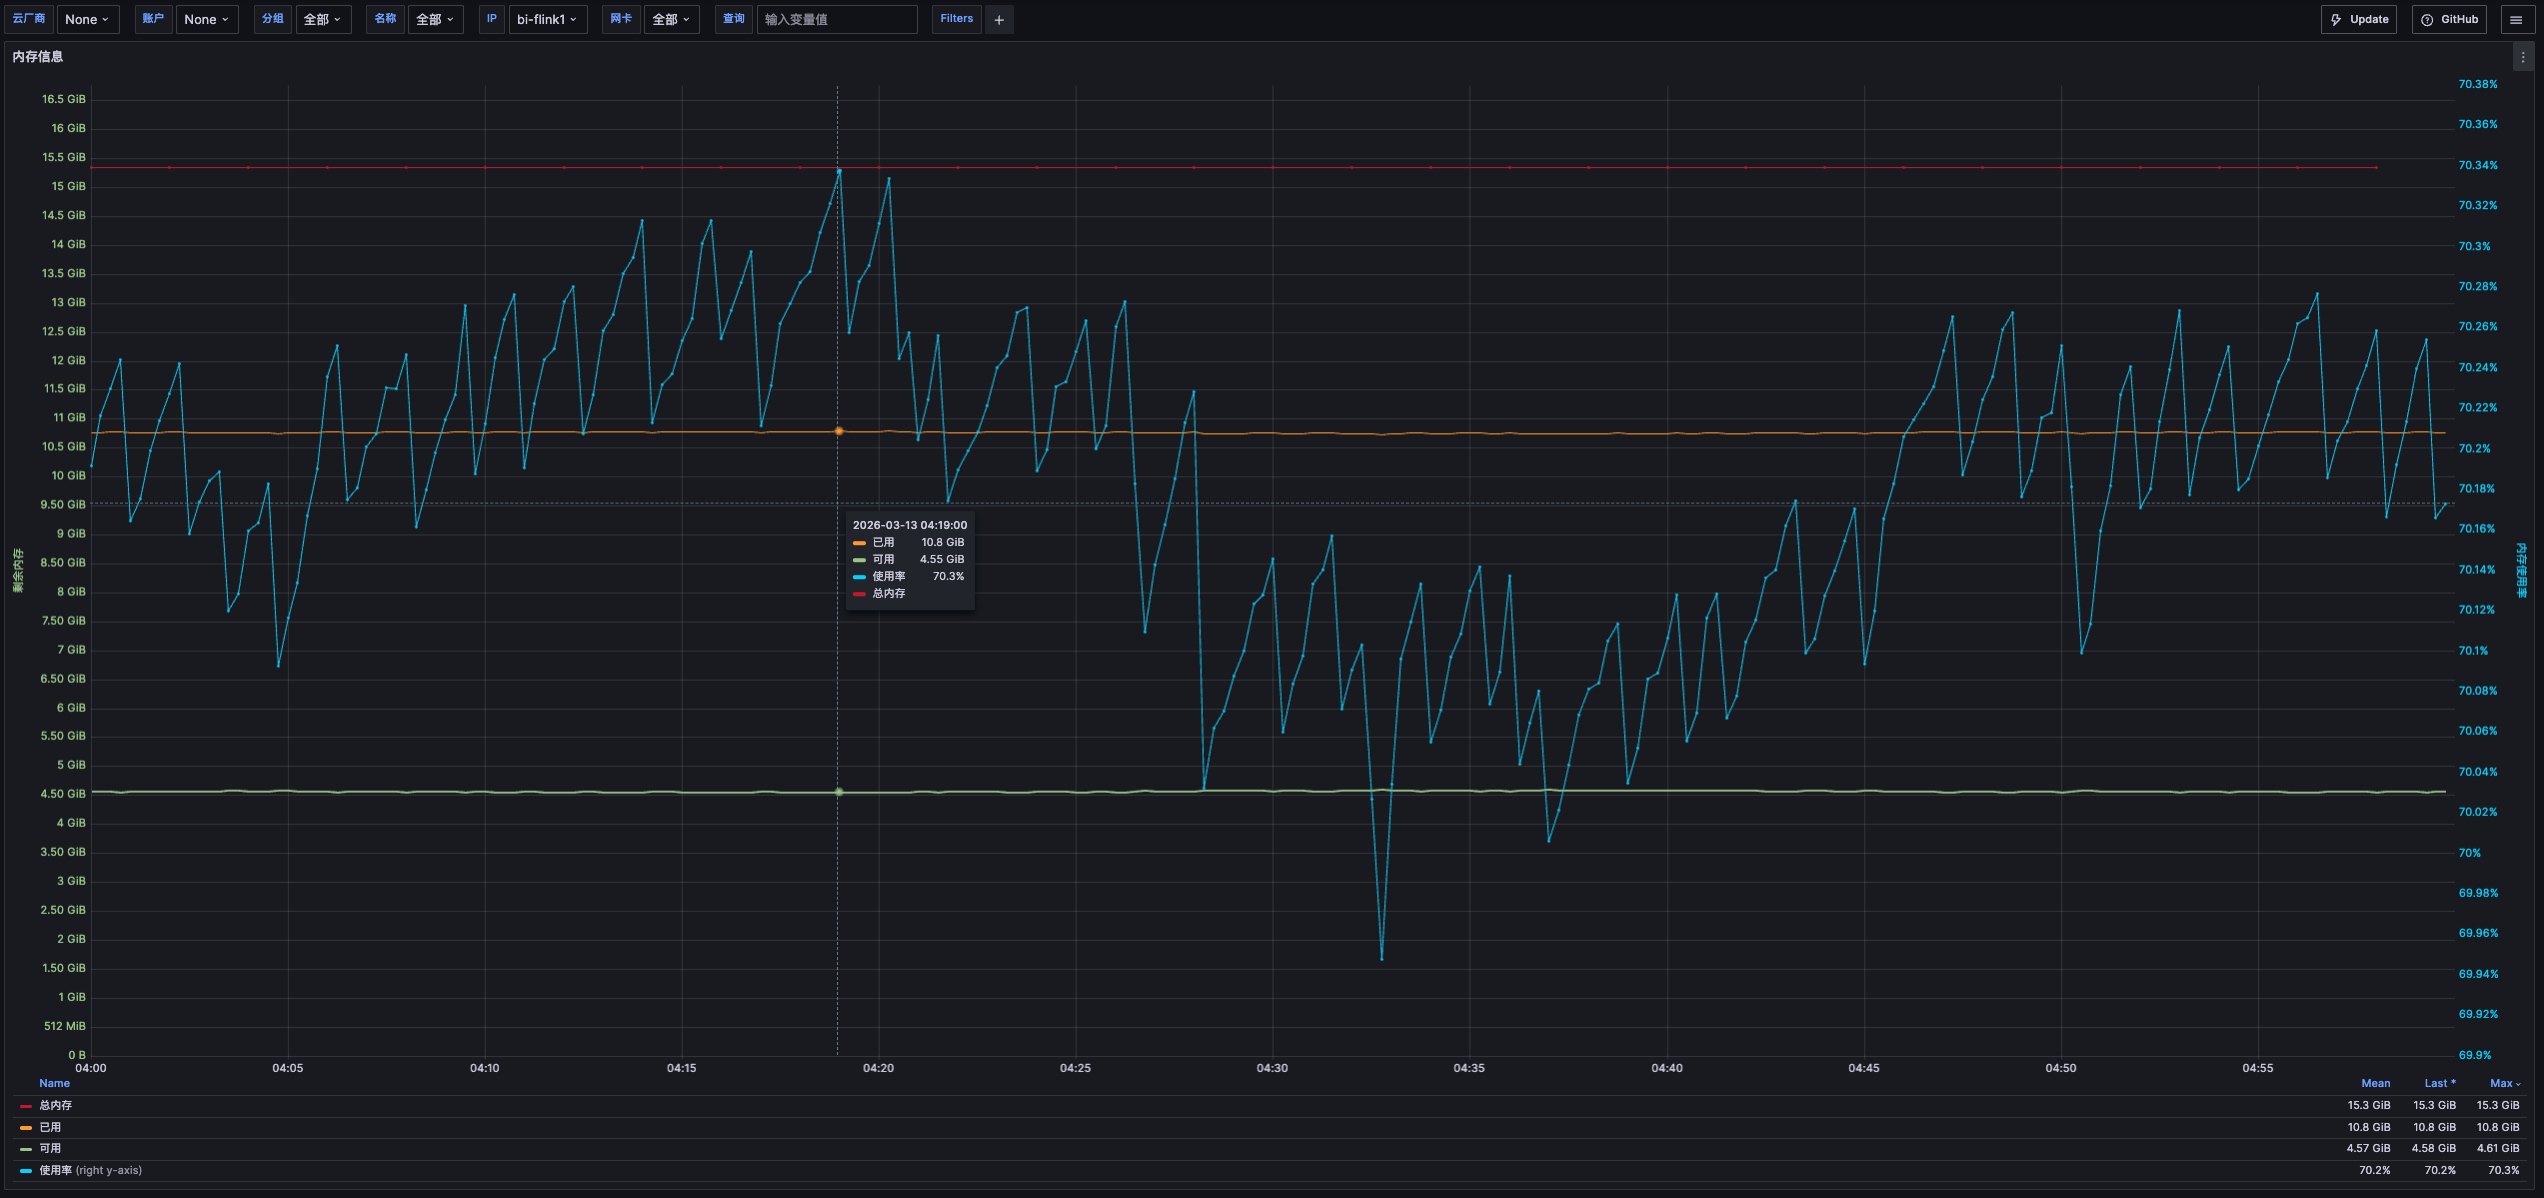
先重启 Worker 恢复业务(线上第一要务是止血):
docker restart dolphinscheduler-worker
重启后重跑任务,恢复正常。但重启只是止血,根因还得继续挖。
2.2 查看 Worker 日志
grep -i "memory\|error\|exception" /data/dolphin/worker/logs/dolphinscheduler-worker.xxx.log | head -20
[WARN] current cpu load average 0.03 is higher than 1.0
       or available memory 0.295 is lower than 0.3
[WARN] current cpu load average 0.03 is higher than 1.0
       or available memory 0.294 is lower than 0.3
Worker 心跳任务每 10 秒检测一次,持续报告:可用内存比例 29.5%,低于阈值 30%。
2.3 查看 Master 日志
grep -i "overload\|memory\|dispatch" /data/dolphin/master/logs/dolphinscheduler-master.xxx.log | head -20
[WARN] Current available memory percentage 0.297 is too low, reserved.memory=0.3
[WARN] The current server is overload, cannot consumes commands.
[WARN] worker 10.0.1.100:1234 current cpu load average 0.0 is too high
       or available memory 4.57G is too low
Master 这边也很明确:
- 自身内存不足,拒绝消费调度命令
- 判定 Worker 负载过高,不往 Worker 分发任务
2.4 确认内存状态
$ free -h
               total   used    free    shared  buff/cache  available
Mem:           15Gi    8.9Gi   482Mi   1.1Gi   5.9Gi       4.9Gi
可用内存 4.9G / 15G ≈ 32%,刚刚踩在 30% 的阈值线上。凌晨跑批任务一多,稍微波动就跌破红线。
2.5 看谁在吃内存
ps -aux --sort=-%mem | head -n 11
结果一目了然: Master 4G + Worker 4G + API 1G + Alert 1G + Flink + MySQL + ZooKeeper,15GB 的机器被塞得满满当当。
三、原因分析
3.1 根因
DolphinScheduler 有一套内存保护机制:
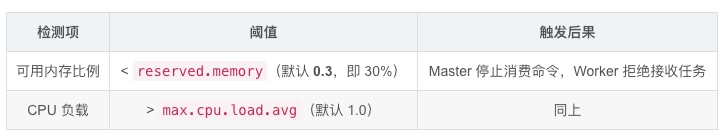
当系统可用内存跌破 30% 时:
Master: "内存不够,我不消费命令了"
Worker: "内存不够,别往我这派活了"
任务实例: Host = 空(没人接活)
结果: 任务失败
3.2 为什么内存不够?
15GB 的机器,光 DolphinScheduler 四个组件就吃掉了 10GB JVM 堆:
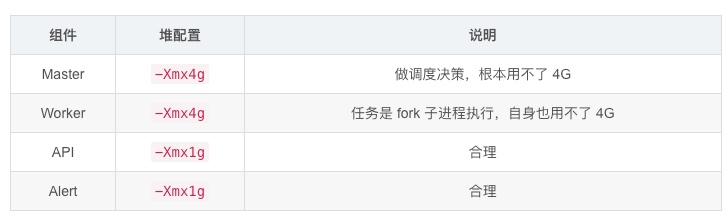
Master 和 Worker 默认堆配置 4G 严重偏大,实际 RSS 只用了 1~2G,白白占着内存不干活。
四、解决方案
有三个方向,按推荐优先级排列:
方案一:降低 Master/Worker JVM 堆大小(推荐)
在
docker-compose.yml 的
environment 中加入:
dolphinscheduler-master:
  environment:
    - JAVA_OPTS=-Xms2g -Xmx2g -Xmn1g
dolphinscheduler-worker:
  environment:
    - JAVA_OPTS=-Xms2g -Xmx2g -Xmn1g
方案二:降低内存保护阈值
默认
reserved.memory=0.3(30%),可以调低到 10%:
dolphinscheduler-master:
  environment:
    - MASTER_RESERVED_MEMORY=0.1
dolphinscheduler-worker:
  environment:
    - WORKER_RESERVED_MEMORY=0.1
这种方式治标不治本,内存真的紧张时任务可能 OOM。
方案三:给容器加
mem_limit 防止互相挤占
dolphinscheduler-master:
  mem_limit: 3g
dolphinscheduler-worker:
  mem_limit: 3g
五、解决验证
这里采用方案一,将 Master/Worker 堆从 4G 降到 2G,重启后验证:
5.1 内存释放效果
$ free -h
               total   used    free    shared  buff/cache  available
Mem:           15Gi    6.8Gi   2.6Gi   1.1Gi   5.9Gi       7.1Gi
可用内存从 4.9G → 7.1G,占比从 32% 提升到 47%,远超 30% 阈值。
5.2 容器实际占用
$ docker stats --no-stream dolphinscheduler-master dolphinscheduler-worker
CONTAINER   NAME                     MEM USAGE / LIMIT    MEM %
aec302...   dolphinscheduler-master  1.098GiB / 15.34GiB  7.16%
cd6df5...   dolphinscheduler-worker  1.049GiB / 15.34GiB  6.84%
- Master 实际内存 1.1GB,堆上限 2G,充裕
- Worker 实际内存 1.05GB,堆上限 2G,充裕
5.3 启动参数确认
$ docker exec dolphinscheduler-master ps -ef | grep java | head -1
/opt/java/openjdk/bin/java -Xms2g -Xmx2g -Xmn1g ... MasterServer
参数已生效,日志也恢复正常,不再有内存告警。
六、总结

核心教训:
- DolphinScheduler 默认 JVM 堆配置偏大,部署到资源有限的机器上一定要按需调整
-
reserved.memory=0.3是一把双刃剑——保护了系统,也可能让你凌晨被叫起来 - Host 为空 ≠ 网络问题,大概率是 内存保护机制拒绝了任务分发
- 线上先止血(重启),再追因(看日志),最后根治(调参数)
原文链接: https://blog.csdn.net/fengquan8866/article/details/159018724
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70014275/viewspace-3182065/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 任务失败了,日志却消失了?一次DolphinScheduler异常任务排查
- 数据生产到智能应用:Apache DolphinScheduler 数仓落地实践
- DolphinScheduler 的 Master 是怎么跑起来的?带你看懂启动源码
- Apache DolphinScheduler 3.4.3 发布!权限安全与稳定性全面增强,调度补火即将上线
- 以 Harness 重构数据工程:Agent 时代的新范式
- Apache DolphinScheduler 8 月报:权限安全加固,调度补火上线,性能与稳定性持续提升
- DolphinScheduler 挂了你不知道?Prometheus + Grafana 监控兜底方案,亲测可用
- 把 ApacheDolphinScheduler 变成 Agent 的“手和脚”:从调度平台到自然语言数据入口
- 希望你永远用不上:Apache DolphinScheduler 任务阻塞死锁排查与解决方案
- Apache DolphinScheduler 单机部署实战 | Docker 一把梭,10分钟搞定!
