DolphinScheduler依赖机制、Open-Falcon告警推送与监控的优化实践
一、背景
DolphinScheduler(海豚调度器)作为开源分布式调度系统,核心价值在于破解大数据场景下复杂任务的调度与流程编排难题,凭借可靠的任务调度、可视化工作流管理等能力,已成为生产环境的核心调度中枢——当前95%以上的大数据任务均通过其实现协调调度。而Open-Falcon作为专注大规模分布式系统的开源监控工具,二者形成"调度核心+监控中枢"的协同关系:前者承担任务调度的核心职责,后者则作为其专属告警对接系统,实现监控信息向钉钉群的精准推送。
然而原生机制中,DolphinScheduler的依赖判断逻辑、告警推送效果及组件监控能力均存在优化空间——例如依赖判断仅基于工作流级别可能导致资源浪费,原生告警存在关键信息淹没、无优先级区分等问题,且缺乏组件不可用状态的自动监控与自愈机制。
为此,本文聚焦某大数据团队的实战优化经验,系统阐述该团队的核心实践:针对任务依赖机制的源码级改造(新增节点级别判断逻辑)、与Open-Falcon的告警对接升级(实现信息精简、优先级分级与分群推送),以及组件监控体系的构建(含节点存活检测与自愈能力)等。通过拆解技术实现逻辑与落地细节,为同类场景下的调度系统优化提供可复用的实践参考。
二、DolphinScheduler改进实践
2.1依赖机制修改
2.1.1 依赖信息介绍
DolphinScheduler不单单支持 DAG简单的前驱和后继节点之间的依赖关系,同时还提供任务依赖节点,支持 流程间的自定义任务依赖。
- 名词解释:
DAG:全称 Directed Acyclic Graph,简称 DAG。工作流中的 Task 任务以有向无环图的形式组装起来,从入度为零的节点进行拓扑遍历,直到无后继节点为止。举例如下图:
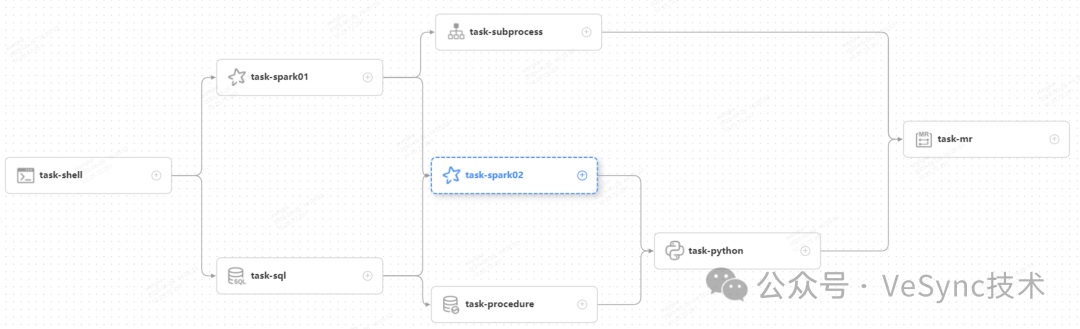
流程定义:通过拖拽任务节点并建立任务节点的关联所形成的可视化DAG。
流程实例:流程实例是流程定义的实例化,可以通过手动启动或定时调度生成。每运行一次流程定义,产生一个流程实例
任务实例:任务实例是流程定义中任务节点的实例化,标识着某个具体的任务。
任务类型:目前支持有 SHELL、SQL、SUB_PROCESS(子流程)、PROCEDURE、MR、SPARK、PYTHON、DEPENDENT(依赖),同时计划支持动态插件扩展,注意:其中 SUB_PROCESS类型的任务需要关联另外一个流程定义,被关联的流程定义是可以单独启动执行的。
2.1.2 问题描述
DolphinScheduler的原生依赖机制是:从元数据库t_ds_process_instance(流程实例表)根据依赖的时间周期(如图示)在其范围内根据工作流的结束时间倒序取第一条工作流实例进行判断。

这就导致了一个问题:工作流中出现执行失败的节点就需要将完整工作流进行修复,存在已经成功执行占用资源较大、执行时间较长的节点需要重新执行、在包含大量节点的工作流已经执行大半,受影响的只是少量的工作流要重新执行的情况。
但如果只执行失败和未执行的节点,就会导致再失败工作流中已经执行成功的节点在后续的依赖判断中会被判失败。
2.1.3 改进逻辑
我们对这一机制进行了优化改进。在获取新工作流实例的位置增加部分逻辑:获取依赖的节点code,从元数据库t_ds_task_instance表根据依赖的时间周期在其范围内根据工作流的结束时间倒序取第一条节点实例。
此改动既保证了原生逻辑中判断会遵循工作流级(process)实例的完成顺序,又增加节点级别(task)实例的判断。
2.1.4 代码修改
- dolphinscheduler-master/src/main/java/org/apache/dolphinscheduler/server/master/utils/DependentExecute.java添加代码:
// 代码121行
    result = getDependTaskResult(dependentItem.getDepTaskCode(), processInstance, dateInterval);                //函数getDependTaskResult 修改功能:在取最新的流程实例获取对应任务实例依赖为空的情况下,增加单独的任务实例获取    private DependResult getDependTaskResult(long taskCode, ProcessInstance processInstance, DateInterval dateInterval) {        DependResult result;        TaskInstance taskInstance = null;        List<TaskInstance> taskInstanceList = processService.findValidTaskListByProcessId(processInstance.getId());              for (TaskInstance task : taskInstanceList) {            if (task.getTaskCode() == taskCode) {                taskInstance = task;                break;            }        }              if (taskInstance == null) {            // cannot find task in the process instance            // maybe because process instance is running or failed.            if (processInstance.getState().typeIsFinished()) {                Integer processDefinitionId = processInstance.getId();                Date taskStartTime = dateInterval.getStartTime();                Date taskEndTime = dateInterval.getEndTime();                TaskInstance lastTaskInstance = processService.findLastRunningTaskByProcessDefinitionId(processDefinitionId, taskCode, taskStartTime, taskEndTime);                if(lastTaskInstance == null) {                    return DependResult.FAILED;                }                if(lastTaskInstance.getState().typeIsFinished()){                    result = getDependResultByState(lastTaskInstance.getState());                }else {                    result = DependResult.WAITING;                }            }else{                return DependResult.WAITING;            }        }else{            result = getDependResultByState(taskInstance.getState());        }        return result;    }
- dolphinscheduler-dao/src/main/resources/org/apache/dolphinscheduler/dao/mapper/TaskInstanceMapper.xml 添加代码:
根据任务实例的开始时间倒序取最新一条数据:
<select id="findLastRunningTaskByProcessDefinitionId" resultType="org.apache.dolphinscheduler.dao.entity.TaskInstance">
    select *
    from t_ds_task_instance
    <where>
        task_code=#{taskCode}
        <iftest="startTime!=null and endTime != null ">
            and start_time <![CDATA[ >= ]]> #{startTime} and start_time <![CDATA[ <= ]]> #{endTime}
        </if>
    </where>
    order by start_time desc limit 1
</select>
- dolphinscheduler-dao/src/main/java/org/apache/dolphinscheduler/dao/mapper/TaskInstanceMapper.java添加代码:
TaskInstance findLastRunningTaskByProcessDefinitionId(@Param("processDefinitionId") Integer processDefinitionId,
                                                      @Param("states") int[] stateArray,
                                                      @Param("taskCode") long taskCode,
                                                      @Param("startTime") Date startTime,
                                                      @Param("endTime") Date endTime
);
- dolphinscheduler-service/src/main/java/org/apache/dolphinscheduler/service/process/ProcessService.java 添加代码:
TaskInstance findLastRunningTaskByProcessDefinitionId(Integer processDefinitionId, long taskCode, Date startTime, Date endTime);
- dolphinscheduler-service/src/main/java/org/apache/dolphinscheduler/service/process/ProcessServiceImpl.java 添加代码:
private final int[] stateArray = new int[]{ExecutionStatus.Pending.ordinal(),
ExecutionStatus.InProgress.ordinal(),
ExecutionStatus.Stopping.ordinal(),
ExecutionStatus.Failed.ordinal(),
ExecutionStatus.Stopped.ordinal(),
ExecutionStatus.CompletedWithViolations.ordinal(),
ExecutionStatus.Completed.ordinal()};
@Override
public TaskInstance findLastRunningTaskByProcessDefinitionId(Integer processDefinitionId, long taskCode, Date startTime, Date endTime) {
    return taskInstanceMapper.findLastRunningTaskByProcessDefinitionId(processDefinitionId, stateArray, taskCode, startTime, endTime);
}
2.2 告警对接Open-Falcon
2.2.1 问题描述
DolphinScheduler原生的告警通知如下:
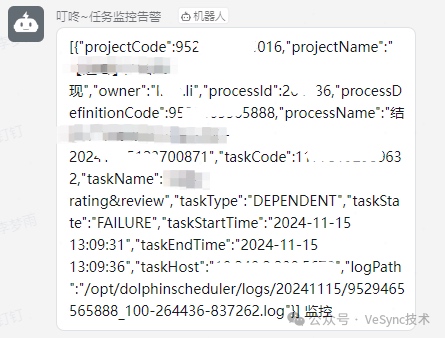
这样的告警推送存在以下问题:
-
报警信息不清晰:上报较多无用信息(如code、owner、host及日志信息),导致关键信息淹没
-
没有告警优先级:所有工作流上报信息都一样,某些需要立即关注的问题不能及时感知
-
没有未恢复告警提示:告警信息较多的情况,容易遗漏修复
2.2.2 解决逻辑
确认原生告警逻辑的查询条件: 每分钟查询元数据库t_ds_process_instance表,汇总当前分钟内执行结束的工作流信息,并标记对应状态,将获取数据上报open-falcon,实现告警信息自定义配置、告警等级设定、未恢复告警提示。
2.2.3 实现逻辑
确认只保留工作流级别的失败通报,通过脚本实现:每分钟获取上一分钟执行结束的工作流实例信息,获取结束状态向falcon上报组装获取的工作流相关信息、指定的告警等级等。
实现逻辑如下:
- 获取监控时间段内的,工作流信息,获取工作流的sql实现:
select pi.id, pd.name as process_name, pi.state
from (select id, state, process_definition_code from t_ds_process_instance where end_time >= '%s'
and end_time < '%s' and (command_param not like '%%parentProcessInstanceId%%' or command_param is null)) pi,
t_ds_process_definition pd
where pi.process_definition_code = pd.code
-
过滤不是结束状态的工作流;
-
对执行结束的工作流进行状态标记;
-
数据上报falcon、设置告警等级、告警过滤、实现告警分情况上报不同群
实现后告警信息如下图:

三、DolphinScheduler的监控体系
3.1 节点状态存活监控
3.1.1 什么问题?
由于线上环境会因为各种资源占用出现宕机或接近宕机的状态(机器可以正常进入,但不能进行组件正常执行,例:磁盘写满、网络波动等),但DolphinScheduler本身没有针对组件不可用状态监控或恢复的机制功能。
如果正好在没人使用DolphinScheduler执行手动任务或进行测试时,很难察觉组件的异常状态,如果在周末出现问题时,则会影响大量的任务运行,需要花费较长时间进行修复。
因此,实现节点状态存活监控旨在:
- 实现组件的状态监控,并尝试自愈;
- 快速上报组件内自愈失败的异常节点,减少对线上任务的执行影响。
3.1.2 功能描述
脚本监控DolphinScheduler的worker-server、master-server存活状态,发现状态异常时先进行重新启动,再次监控状态还是异常时,进行告警,因为不同节点在组件中的角色不同,因此对告警等级进行了下图的设定:

效果示例:

3.2 工作流定时状态上线监控
3.2.1 什么问题?
由于线上定时任务的调度基本都在DolphinScheduler上执行,每天会有较多的上线操作,会对线上工作流进行下线修改操作,如果上线过程遗漏掉定时上线或者工作流上线,就会造成任务漏跑,严重的会影响其他的正常定时调度的工作流。
因此,工作流定时状态上线监控旨在:每天夜里在凌晨任务高峰段开始前确认线上正式工作流的上线状态、定时状态。
3.2.2 功能描述
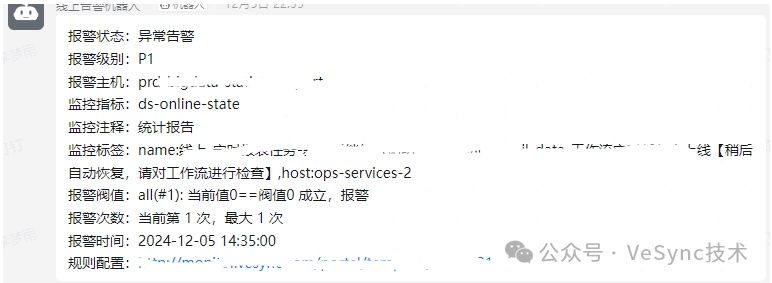
从DolphinScheduler元数据库查询,所有有上线定时设置的工作流,再逐一进行递归验证工作流的上线状态和定时上线状态,以及子工作流的上线状态,未上线时进行上报。
3.2.3 实现逻辑
- 从元数据库获取由定时设置且工作流名称未包含‘修复’、‘测试’等关键词的工作流信息;
- 遍历上述获取工作流,对其定时状态进行判断,如果未上线:则进行告警通知;
- 如果2中工作流定时上线,则遍历工作流内节点信息,获取所有的子节点类型节点,对子节点指向的工作流进行工作流上线状态的判断;正常则进行本步骤继续递归子工作流节点直至工作流内没有子工作流类型的节点为止;否则,就进行告警通知。
实现效果:
3.3 DolphinScheduler长时间执行工作流监控
3.3.1 什么问题?
目前,线上大多数的工作流执行不会超过4个小时,但存在:1、特殊工作流长时间执行;2、异常工作流执行:长时间请求等待、依赖卡住等情况。
开发DolphinScheduler长时间执行工作流监控,旨在:提醒当前线上存在超长时间执行工作流,方便异常情况的停止并及时修复;也方便特殊工作流的分析优化。
3.3.2 功能描述
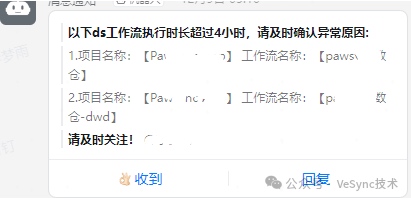
上报当前执行时长超过4小时(基本是执行异常事件)的工作流名称。
3.3.3 代码实现
- 获取超长时间执行的工作流信息,实现sql如下:
select pjname, pname, stat from
(select process_definition_code, TIMESTAMPDIFF(minute , start_time,now()) stat from t_ds_process_instance where state = 1) instance
join
(select project.name pjname, process.name pname, process.code
from t_ds_project project join t_ds_process_definition process on process.project_code = project.code
whereprocess.name not like '%测试%'
and process.name not like '%修复%') def
on def.code = instance.process_definition_code
wherestat > 240
-
判断是不是指定端特殊工作流(为这类工作流设置单独的告警时长);
-
超出设置阈值,则进行上报。
实现效果:
3.4 Shell节点未添加重试监控
3.4.1 什么问题?
由于DolphinScheduler上的执行任务受集群机器的状态影响、关联组件(比如:zookeeper、MySQL等)的影响、网络影响,不能保证任务节点在定时调度时,一次就一定能执行成功,所以需要进行重试次数的设置。
本监控实现对当日新增的节点未添加重试进行上报提醒。
3.4.2 功能描述
上报当前shell类型节点未增加重试的工作流信息。
3.4.3 代码实现
从元数据库获取当日新增的、类型为‘SHELL’的、未被禁止的、所属工作流已上线的、失败重试次数为0的节点信息,sql实现如下:
select project.name pjname, process.name pname, task.name tname
from t_ds_task_definition task
join t_ds_project project on task.project_code = project.code
left join t_ds_process_definition process on locate(task.code, process.locations) > 0
where process.release_state = 1 and task.task_type in ('SHELL', 'SQL')
and task.fail_retry_times = 0 and process.release_state = 1 and task.flag = 1
and (task.update_time >= '{}' or task.create_time >= '{}')
对获取的信息进行汇总上报。
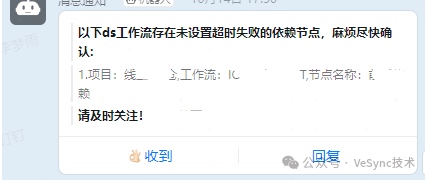
3.5 依赖节点未设置超时失败监控
3.5.1 什么问题?
由于DolphinScheduler对依赖信息的判断在没有对应实例的情况下,会进行等待然后判断,一直循环。那么不设置超时失败就会导致工作流在依赖执行异常的情况下(例如:未执行、或长时间执行不出来),就会一直进行判断,这同样可能造成大量工作流不能执行要花费较多时间进行修复,且要在修复前手动进行停止。本监控旨在解决依赖节点超时时长相关的监控,旨在保证依赖时长始终控制在合理且有效的范围内
3.5.2 功能描述
上报未设置超时失败的依赖类型节点、设置的不是超时失败的依赖节点、以及依赖节点执行时长接近设置时长的节点
3.5.3 代码实现
- 先获取每日执行的、依赖节点类型的任务实例,关联任务节点定义表,如果未设置超时、设置的不是超时失败,则进行上报;
- 获取近七天内执行的、依赖节点类型的任务且依赖执行时长超过1分钟的实例信息,统计依赖执行总时长/依赖执行次数的平均执行时长,平均执行时长接近设置时长的80%,则进行上报;
- 获取当日执行的、依赖执行时长超过设置时长90%,进行上报。
实现效果:
四、效率工具
4.1 工作流的依赖情况查询
4.1.1 什么问题?
因为DolphinScheduler中工作流之间会有较多的依赖关系,因此在对工作流的拓扑进行调整、定时进行修改时,要先确认对他有依赖的下游工作流有哪些,需要逐一确认,调整对其是否有影响,是否需要随之改动。
4.1.1 功能描述
查询当前环境所有依赖你指定的工作流的工作流信息。
4.1.2 代码实现
- 根据输入的项目名称、工作流名称获取对应的id;
- 在任务定义表中获取依赖类型节点的信息中包含1中查询到的id信息的任务节点id;
- 将2中获取的id关联工作流定义表、项目表,获取其所在的项目和工作流。实现效果:
指定项目和工作流名称:

查询结果:

4.2 工作流信息快捷查询
4.2.1 功能描述
在DolphinScheduler元数据库中工作流(process)和节点(task)都是通过project_code和项目进行关联的,因此,查询对应节点和工作流信息时,要经过较多处理,故进行一个基础sql实现项目、工作流和节点的信息关联,这样在实际应用中只需要进行简单其他筛选条件的添加。
4.2.2 代码实现
select project.name pjname, process.name pname, task.name tname
from t_ds_task_definition task
join t_ds_project project on task.project_code = project.code
left join t_ds_process_definition process on locate(task.code, process.locations) > 0
这样在实际应用中,只需要增加where条件和需要的字段就可以获取所有需要的信息
举例:获取所有‘SQL’类型节点的信息:
select project.name pjname, process.name pname, task.name tname
from t_ds_task_definition task
join t_ds_project project on task.project_code = project.code
left join t_ds_process_definition process on locate(task.code, process.locations) > 0
where task.task_type = 'SQL'
五、展望
在本文介绍的大数据团队对DolphinScheduler的优化实践、监控体系和效率工具基础上,为保证任务的稳定运行同时优化项目的调度、保障资源分配合理且充足,我们将会继续通过智能编排算法进行以下方面优化:
结合历史调度实例、集群资源空闲状态、追溯依赖关系输出合适的修改建议;
元数据导入dataHub,方便溯源工作流之间的真实的依赖关系,在脚本中自动进行递归改动,对改动信息进行输出。
参考文档:
- https://dolphinscheduler.apache.org/zh-cn/docs/3.2.2/about/glossary
- https://hitripod.gitbooks.io/open-falcon/content/zh/intro/
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70014275/viewspace-3098463/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 任务失败了,日志却消失了?一次DolphinScheduler异常任务排查
- 数据生产到智能应用:Apache DolphinScheduler 数仓落地实践
- DolphinScheduler 的 Master 是怎么跑起来的?带你看懂启动源码
- Apache DolphinScheduler 3.4.3 发布!权限安全与稳定性全面增强,调度补火即将上线
- 以 Harness 重构数据工程:Agent 时代的新范式
- Apache DolphinScheduler 8 月报:权限安全加固,调度补火上线,性能与稳定性持续提升
- DolphinScheduler 任务实例 Host 为空?一次内存保护机制引发的调度罢工
- DolphinScheduler 挂了你不知道?Prometheus + Grafana 监控兜底方案,亲测可用
- 把 ApacheDolphinScheduler 变成 Agent 的“手和脚”:从调度平台到自然语言数据入口
- 希望你永远用不上:Apache DolphinScheduler 任务阻塞死锁排查与解决方案
